TL;DR
- 單次輸出 100 萬 Token:Google DeepMind 發表 Gemini 4 系列首款前沿模型 Gemini 4 Argon,單次輸出上限推升至 100 萬 Token,解決長篇代碼與複雜專案必須依賴多輪切片的痛點。
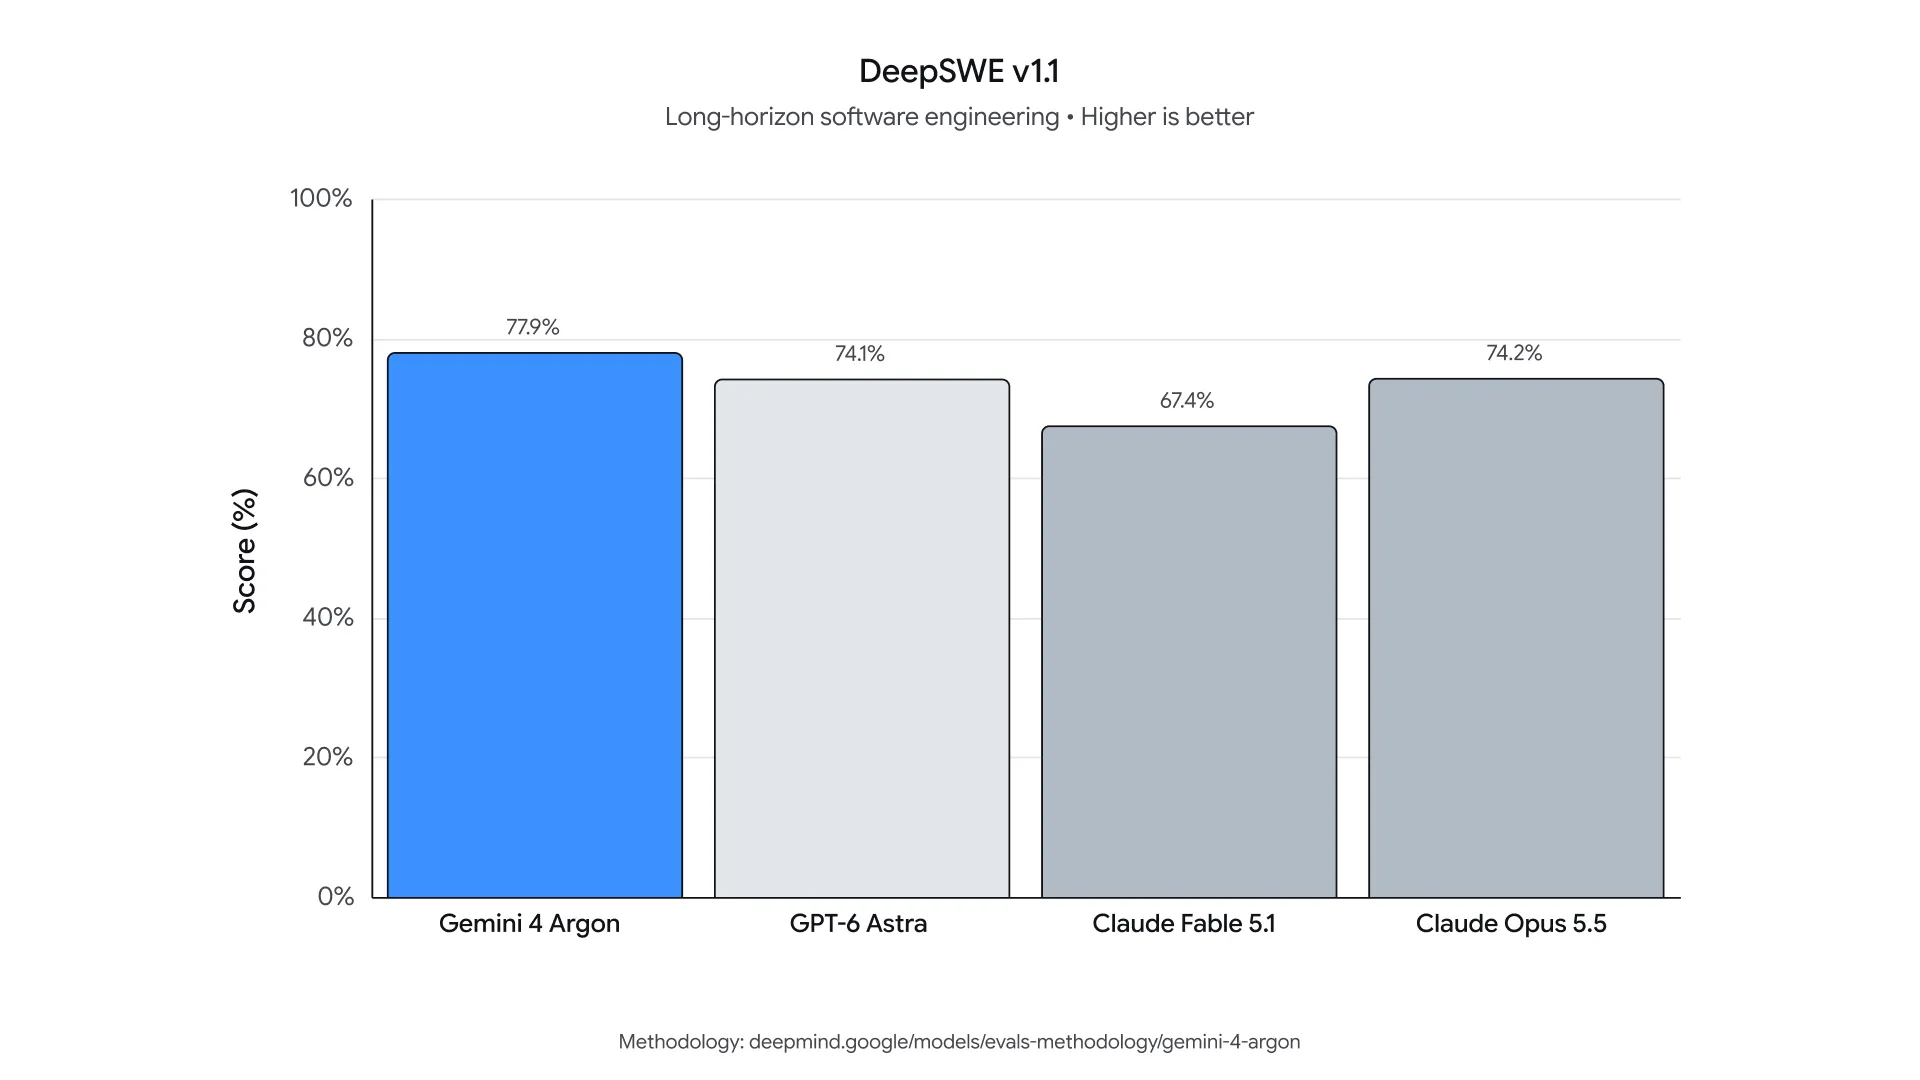
- 官方評測領先領域:在 19 項指標中,DeepSWE v1.1(77.9%)、Harvey 法律代理(19.6% vs 競品 5% 以下)、AutomationBench(51.3%)與 GraphWalks 1M 長上下文(84.2%)均拔得頭籌。
- 競品各有勝負:FrontierSWE v2(65.5%)與終端科學測試由 GPT-6 Astra 領先;Terminal-bench 4.0 則由 Claude Opus 5.5(66.4%)佔優。
- 定價與開放:首波透過 Fairwind Program 提供資安研究夥伴測試;早鳥 API 定價為輸入每百萬 $2.00、輸出每百萬 $10.00,快取輸入享 95% 折扣。
Google DeepMind 於 2026 年 9 月 30 日發表新一代旗艦模型 Gemini 4 Argon。這是 Gemini 4 世代首款亮相的前沿模型,專為長程推演、全自動代碼工程與企業知識工作打造。

核心突破:100 萬輸出 Token 的實用價值
過去語言模型的上下文競賽大多集中在「輸入長度(Input Context Window)」,主流旗艦模型如 GPT-6 Astra 與 Claude Opus 5.5 已普遍支援 50 萬至 100 萬 Token 輸入。然而「單次輸出上限(Output Token Limit)」普遍停留在 64K 至 128K 區間。
當工程師需要模型重構大型專案、一次性生成多個相互依賴的微服務模組,或編寫完整的系統驗證測試時,過往必須透過 Multi-agent 架構進行拆解、多輪對話與狀態拼接,容易出現邏輯斷裂與狀態丟失。
Gemini 4 Argon 重新設計了解碼注意力機制,將單次輸出容量推升至 100 萬 Token(繁體中文約 70 萬字以上)。這代表模型可在單次推論請求中完成端到端的全專案代碼輸出與複雜長程推演。
在輸入端方面,從官方 GraphWalks 評測中測試了 256k 至 1M 的跨度可看出,Argon 同樣具備百萬級長上下文檢索能力。
官方基準測試解析:19 項評測全面拆解
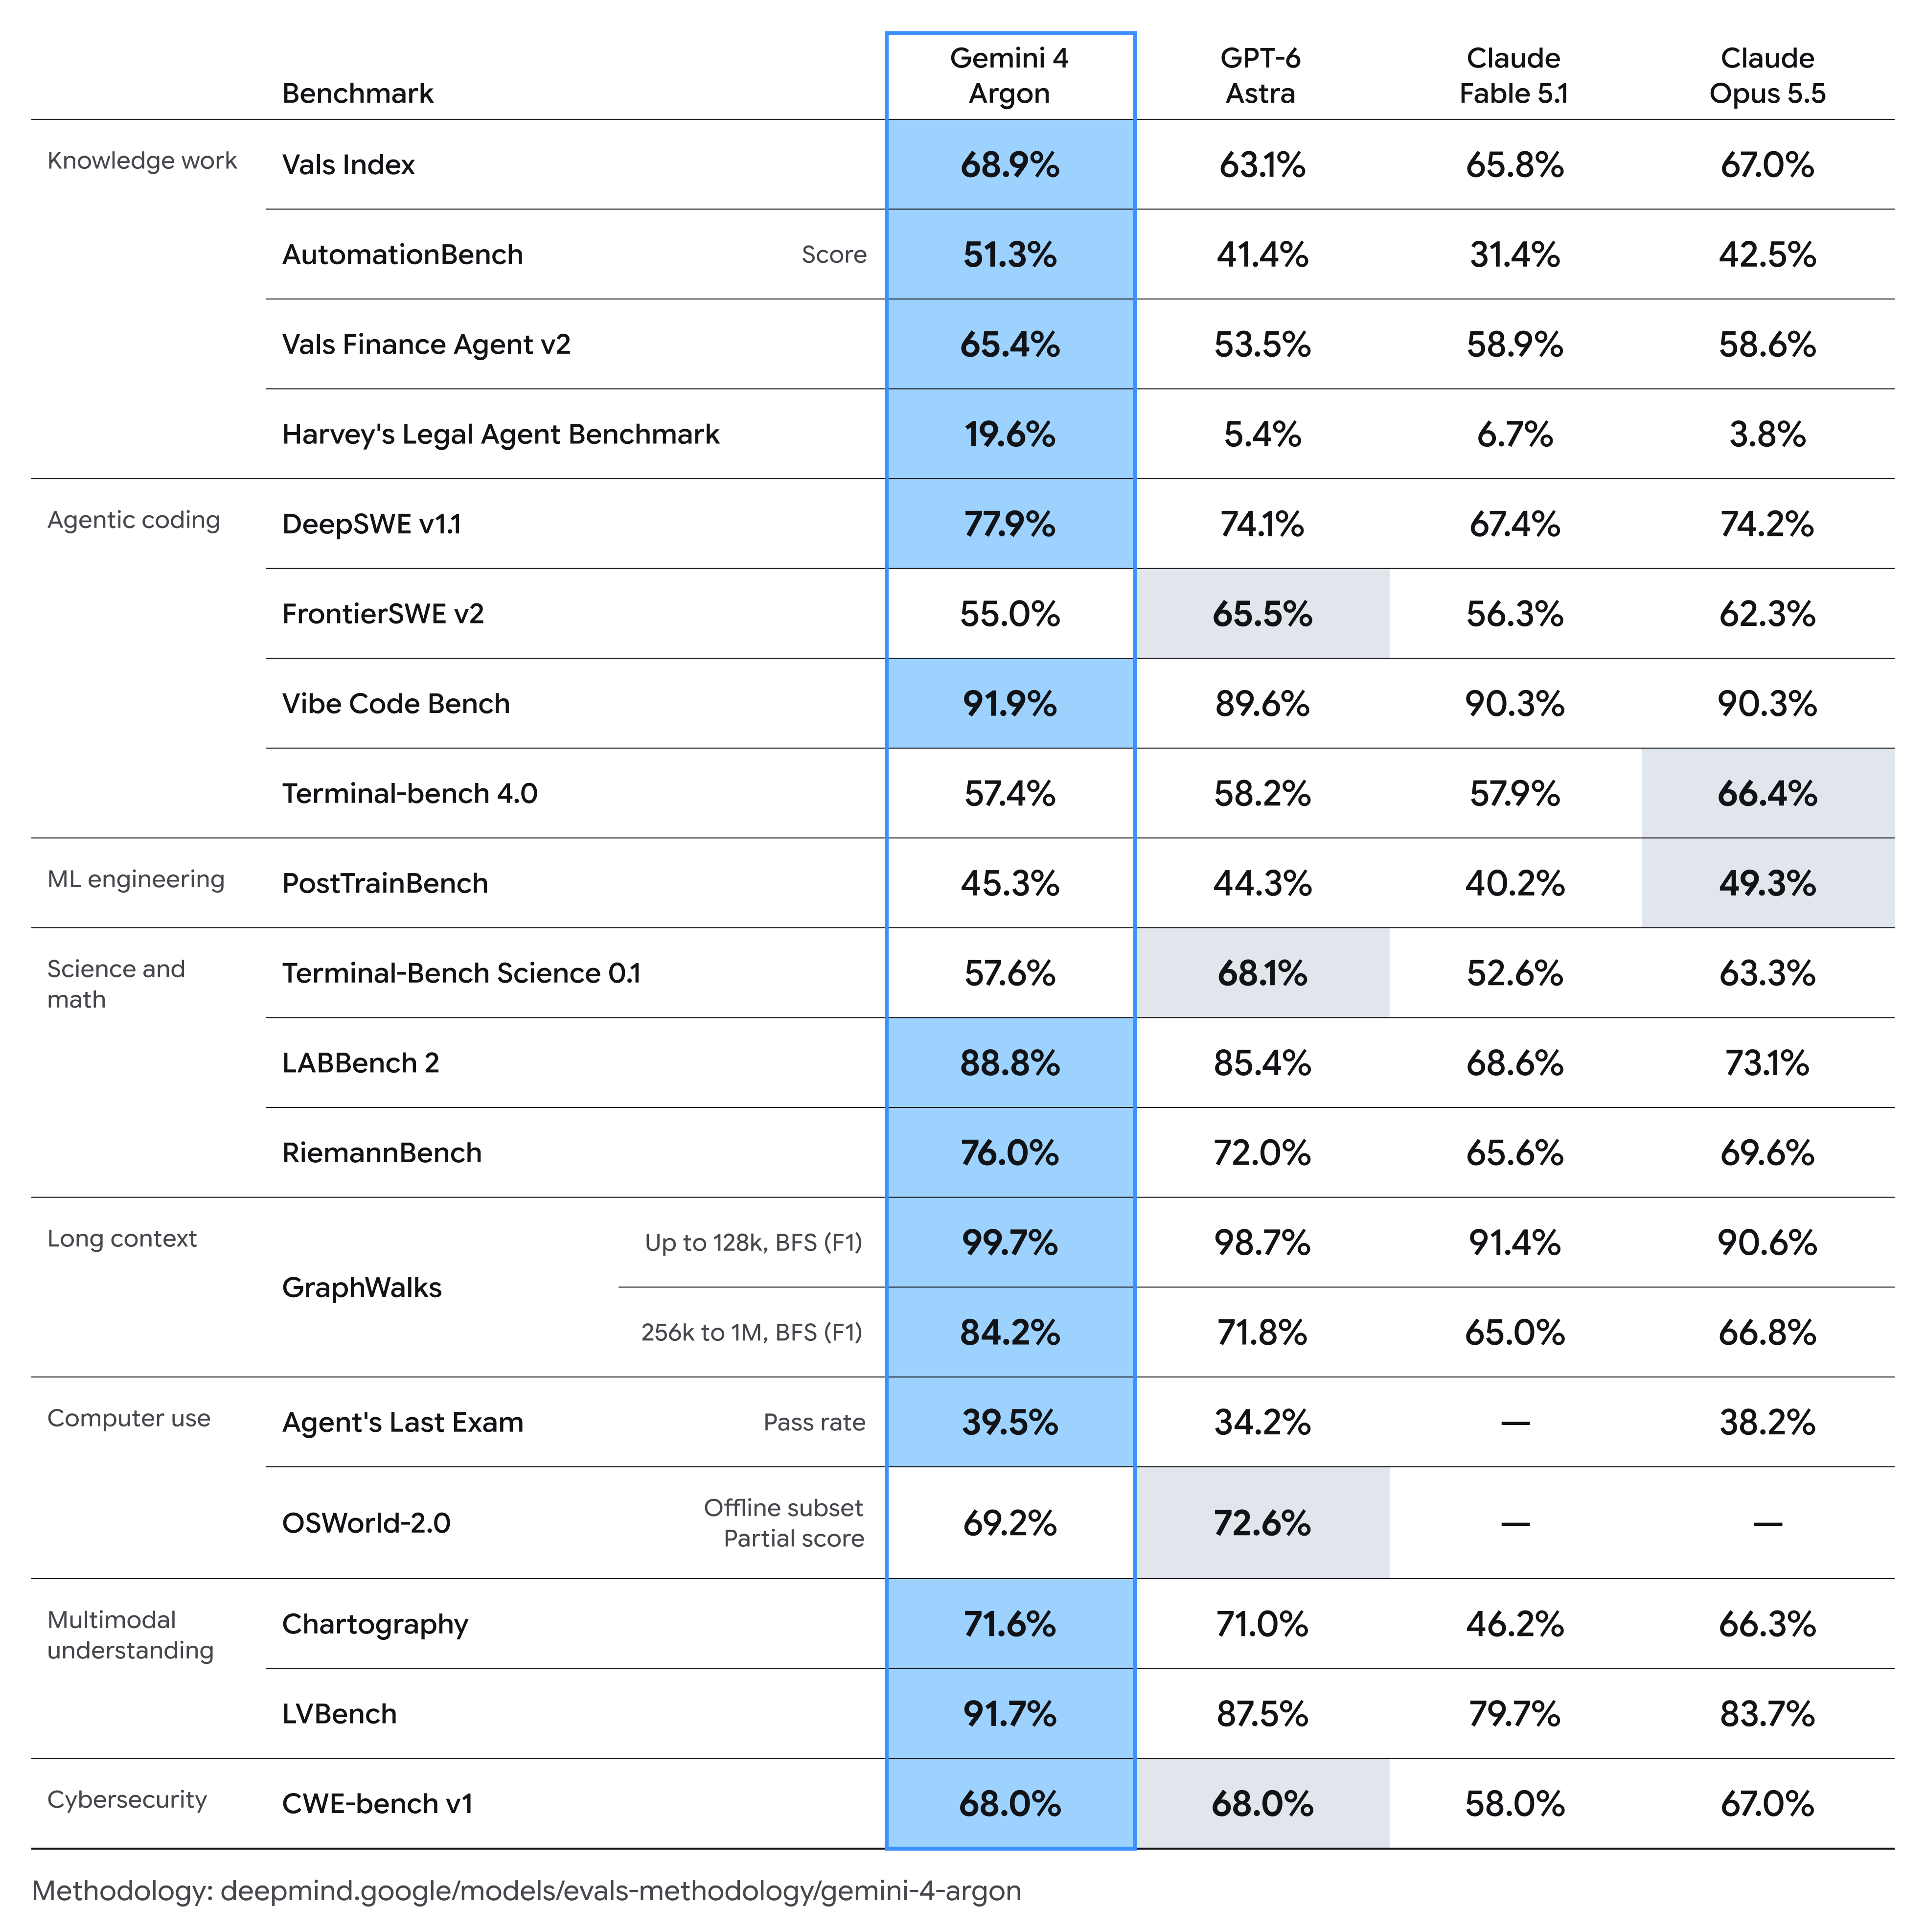
Google DeepMind 同步公布了涵蓋 8 大領域、共 19 項指標的官方基準評測,全面對比同世代的競爭對手 GPT-6 Astra、Claude Opus 5.5 與 Claude Fable 5.1:
1. 知識工作與企業代理:法律與自動化壓倒性領先
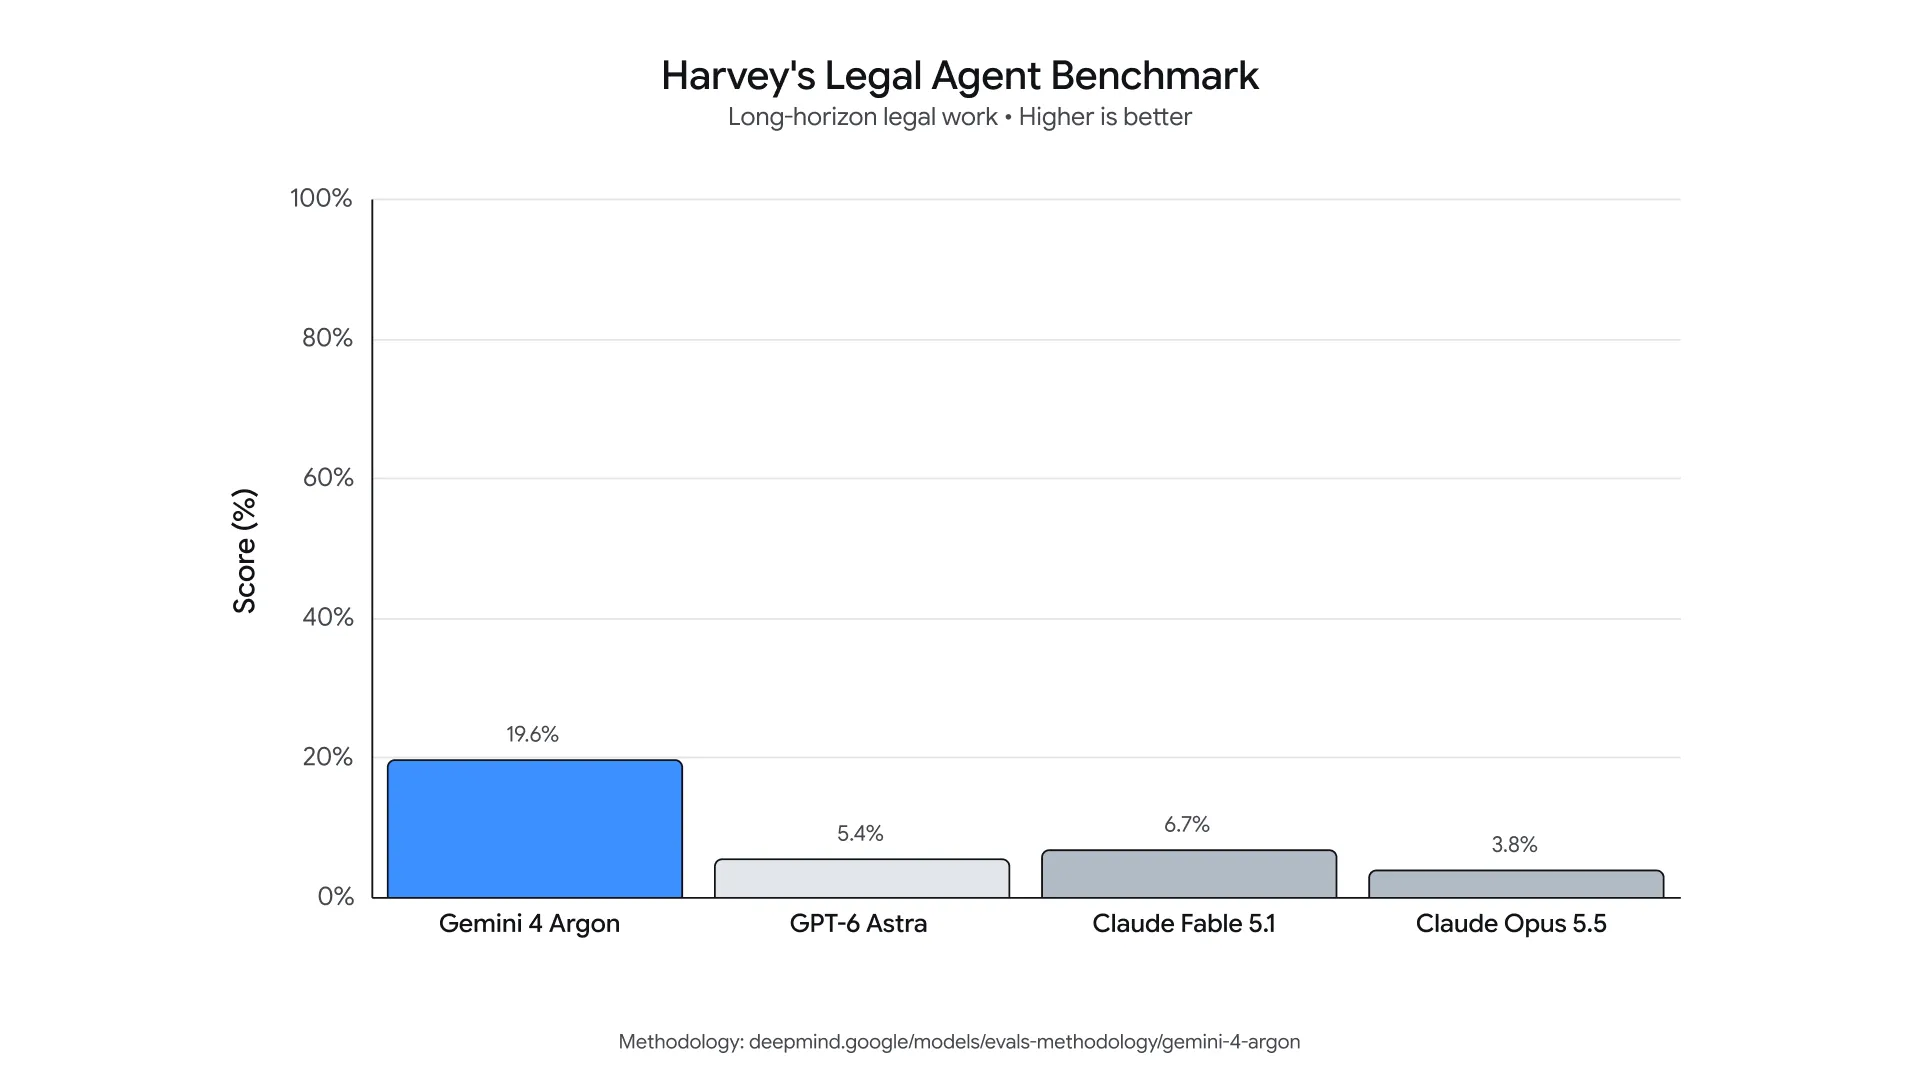
- Harvey’s Legal Agent Benchmark:Argon 繳出 19.6% 的成績,相比 GPT-6 Astra(5.4%)、Claude Fable 5.1(6.7%)與 Claude Opus 5.5(3.8%),取得近 4 倍的壓倒性領先。在複雜長篇法律條文檢索與邏輯推理上優勢顯著。
- AutomationBench:Argon 拿下 51.3%,領先 Claude Opus 5.5(42.5%)與 GPT-6 Astra(41.4%)。
- Vals Index 與 Vals Finance Agent v2:分別取得 68.9% 與 65.4%,在金融與企業報告整合任務均位居第一。
2. 軟體工程與編程(Agentic Coding):旗艦互有勝負
- DeepSWE v1.1(真實 Repo 修復):Argon 取得 77.9% 拔得頭籌,超越 Claude Opus 5.5(74.2%)與 GPT-6 Astra(74.1%)。
- Vibe Code Bench:Argon 以 91.9% 領先全場(Astra 89.6%、Opus 90.3%)。
- FrontierSWE v2:GPT-6 Astra 表現更優,以 65.5% 居冠,Claude Opus 5.5 居次(62.3%),Argon 則為 55.0%。
- Terminal-bench 4.0:Claude Opus 5.5 展現終端操作優勢,拿下 66.4%,Argon(57.4%)與 Astra(58.2%)在此項略遜於 Opus。
3. 長上下文與圖結構檢索(Long Context)
- GraphWalks (Up to 128k, BFS F1):Argon 達到 99.7%,Astra 為 98.7%,Claude 兩款模型均在 91% 左右。
- GraphWalks (256k to 1M, BFS F1):當上下文擴展至 100 萬 Token,Argon 依然維持 84.2% 的檢索準確度,顯著高於 GPT-6 Astra(71.8%)與 Claude Opus 5.5(66.8%),證明其在超長上下文下的注意力未出現嚴重衰退。
4. 科學、多模態與電腦操作
- 科學與數學:Argon 在 LABBench 2(88.8%)與 RiemannBench(76.0%)取得第一;但在 Terminal-Bench Science 0.1 上,GPT-6 Astra 以 68.1% 大幅領先(Argon 57.6%)。
- 多模態理解:LVBench 長影片理解 Argon 拿下 91.7%,Chartography 圖表解析達 71.6%,延續了 Gemini 在原生多模態上的穩定優勢。
- 電腦操作 (Computer Use):在 Agent’s Last Exam 上 Argon 以 39.5% 居首;但在 OSWorld-2.0 離線子集評測中,GPT-6 Astra 以 72.6% 取得更高分數(Argon 69.2%)。
資安防禦機制:Fairwind Program 與 CWE-bench 評測
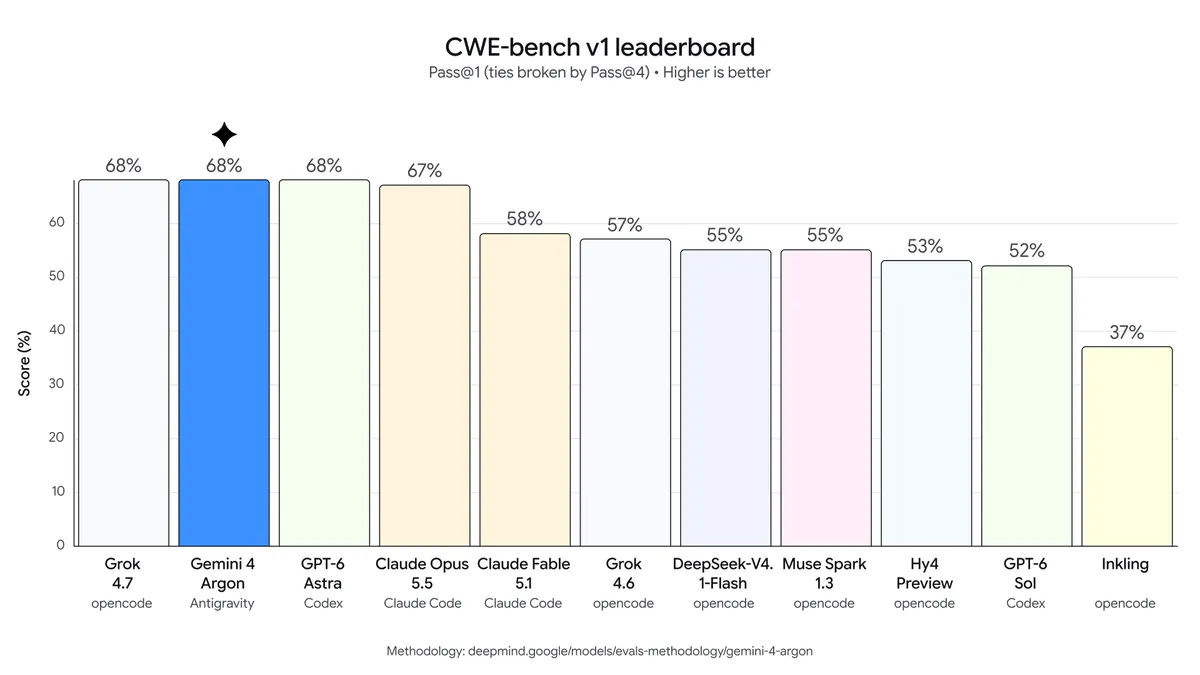
在常見弱點列舉評測 CWE-bench v1 中,Gemini 4 Argon 與 GPT-6 Astra 同樣取得 68.0% 的最高分,高於 Claude Opus 5.5(67.0%)與 Claude Fable 5.1(58.0%)。
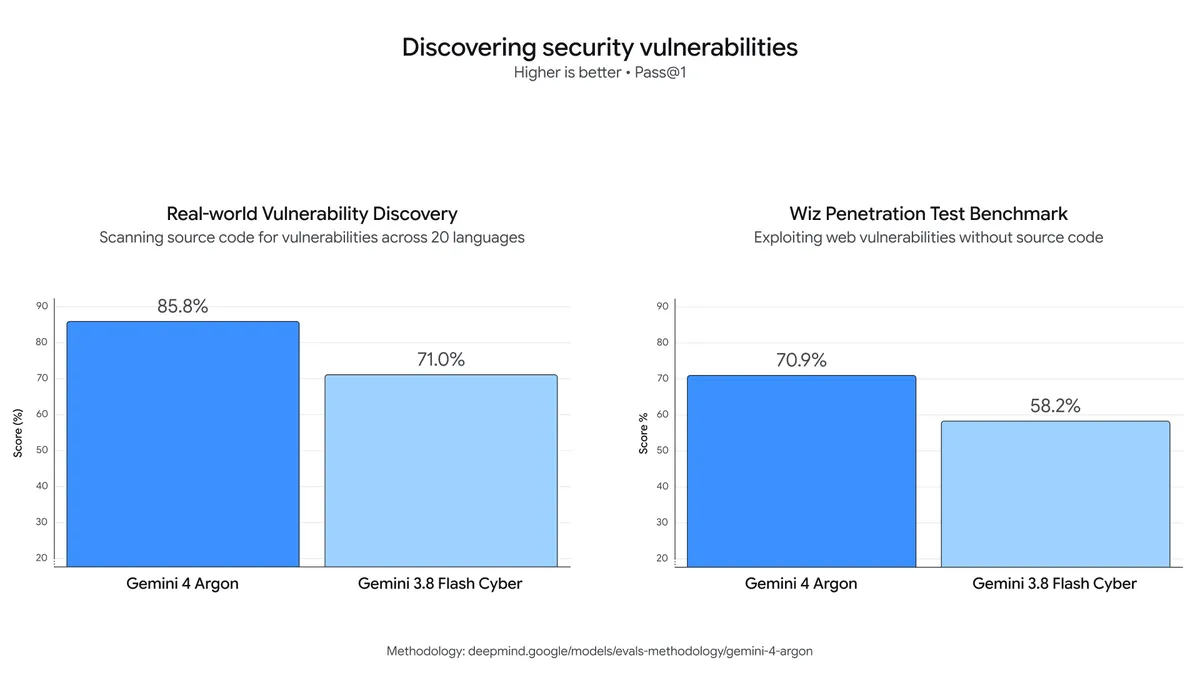
在實際漏洞挖掘(Real-world Vulnerability Discovery)與無源碼網頁滲透(Wiz Penetration Test)評測中,Argon 分別拿下 85.8% 與 70.9% 的成績:
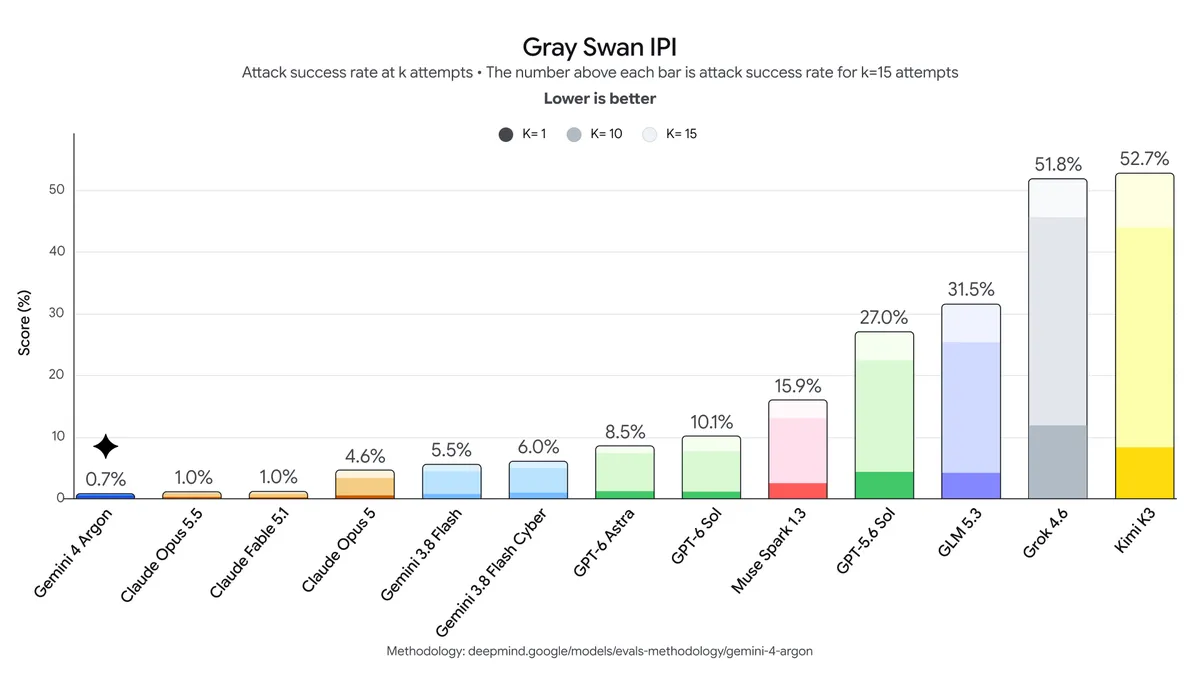
在安全性與對抗攻擊防禦上,Google 引用了 Gray Swan IPI(間接提示詞注入攻擊) 測試。在 15 次攻擊嘗試下,Gemini 4 Argon 的攻擊成功率僅為 0.7%,位列所有參測前沿模型之冠(對比 GPT-6 Astra 的 8.5% 與 Claude Opus 5.5 的 1.0%):
為了讓模型能協助白帽防禦者挖掘與修復深層漏洞,Google 啟動了 Fairwind Program:
- 定向開放授權:現階段僅開放給通過身分驗證的資安機構、學術團隊與合作防禦者。
- 沙盒專屬環境:在嚴密監控的隔離沙盒內,適度調整部分防護限制,以利進行真實漏洞復現驗證與熱修補生成。
- 未來一般 API 防護:此放寬僅限 Fairwind 專案沙盒,未來向一般開發者與企業開放時,仍會全面套用標準企業級安全護欄。
定價策略與開放管道
Google 為 Gemini 4 Argon 提供了極具競爭力的早鳥促銷價格:
| 計費項目 | 早期促銷定價 (Introductory) | 未來標準定價 (Standard) | 說明 |
|---|---|---|---|
| Input Tokens (每百萬) | $2.00 | $4.00 | 具備高度競爭力 |
| Output Tokens (每百萬) | $10.00 | $20.00 | 百萬級長輸出極具性價比 |
| Cached Input (每百萬) | $0.10 (折抵 95%) | $0.20 (折抵 95%) | 適用長期快取代碼庫與規格手冊 |
開放進度與呼叫提醒
- 當前階段:優先開放給 Fairwind Program 合作夥伴。
- 後續排程:即將在 Google Cloud Vertex AI 與 Google AI Studio 向付費 API 用戶推出,並納入 Google AI Ultra 訂閱權益。
- 開發者提醒:官方目前尚未公開正式的 API Model ID 字串,切勿在現有專案中手動指定未公開的端點名稱,以免觸發
404 Not Found。
常見問答 (FAQ)
Q1: Gemini 4 Argon 的 100 萬輸出 Token 與一般的百萬輸入視窗有何差別?
過去模型宣傳的百萬視窗是指「輸入容量」,即模型能讀多少文字;而 Argon 突破的是「單次輸出容量」,代表模型能一次性生成 100 萬 Token 的代碼或報告,避免了多輪對話切割產生的上下文遺失。
Q2: 官方評測中,Argon 在哪些項目輸給對手?
從官方 19 項評測可看出,Argon 並非全項目獲勝:GPT-6 Astra 在 FrontierSWE v2、Terminal-Bench Science 與 OSWorld-2.0 取得領先;Claude Opus 5.5 則在 Terminal-bench 4.0 終端操作指標上高於 Argon。