時隔一年,Google 在前天終於發布了萬眾期待的 Google Gemma 4 開源大型語言模型(LLM)。
這次 Gemma 4 的發布,不僅 AI 推理能力得到顯著增強,更是罕見地支援了「原生聲音」與「影片」的多模態輸入(Multimodal),甚至開放讓開發者調整輸入影像的 Token 預算與思考預算。更棒的是,授權條款從原本的 Gemma 協議,全面變更為更加開放且商用友善的 Apache 2.0 協議。
今天我們就來深度解析 Google Gemma 4 的架構亮點,並進行一系列的 AI 壓力實測(邏輯推理、網頁設計、OCR 等)。文章後半段也會手把手教大家如何免費線上試用,以及如何透過 Ollama 本機部署 Gemma 4。

Gemma 4 模型家族一覽:從手機到伺服器規格全解析
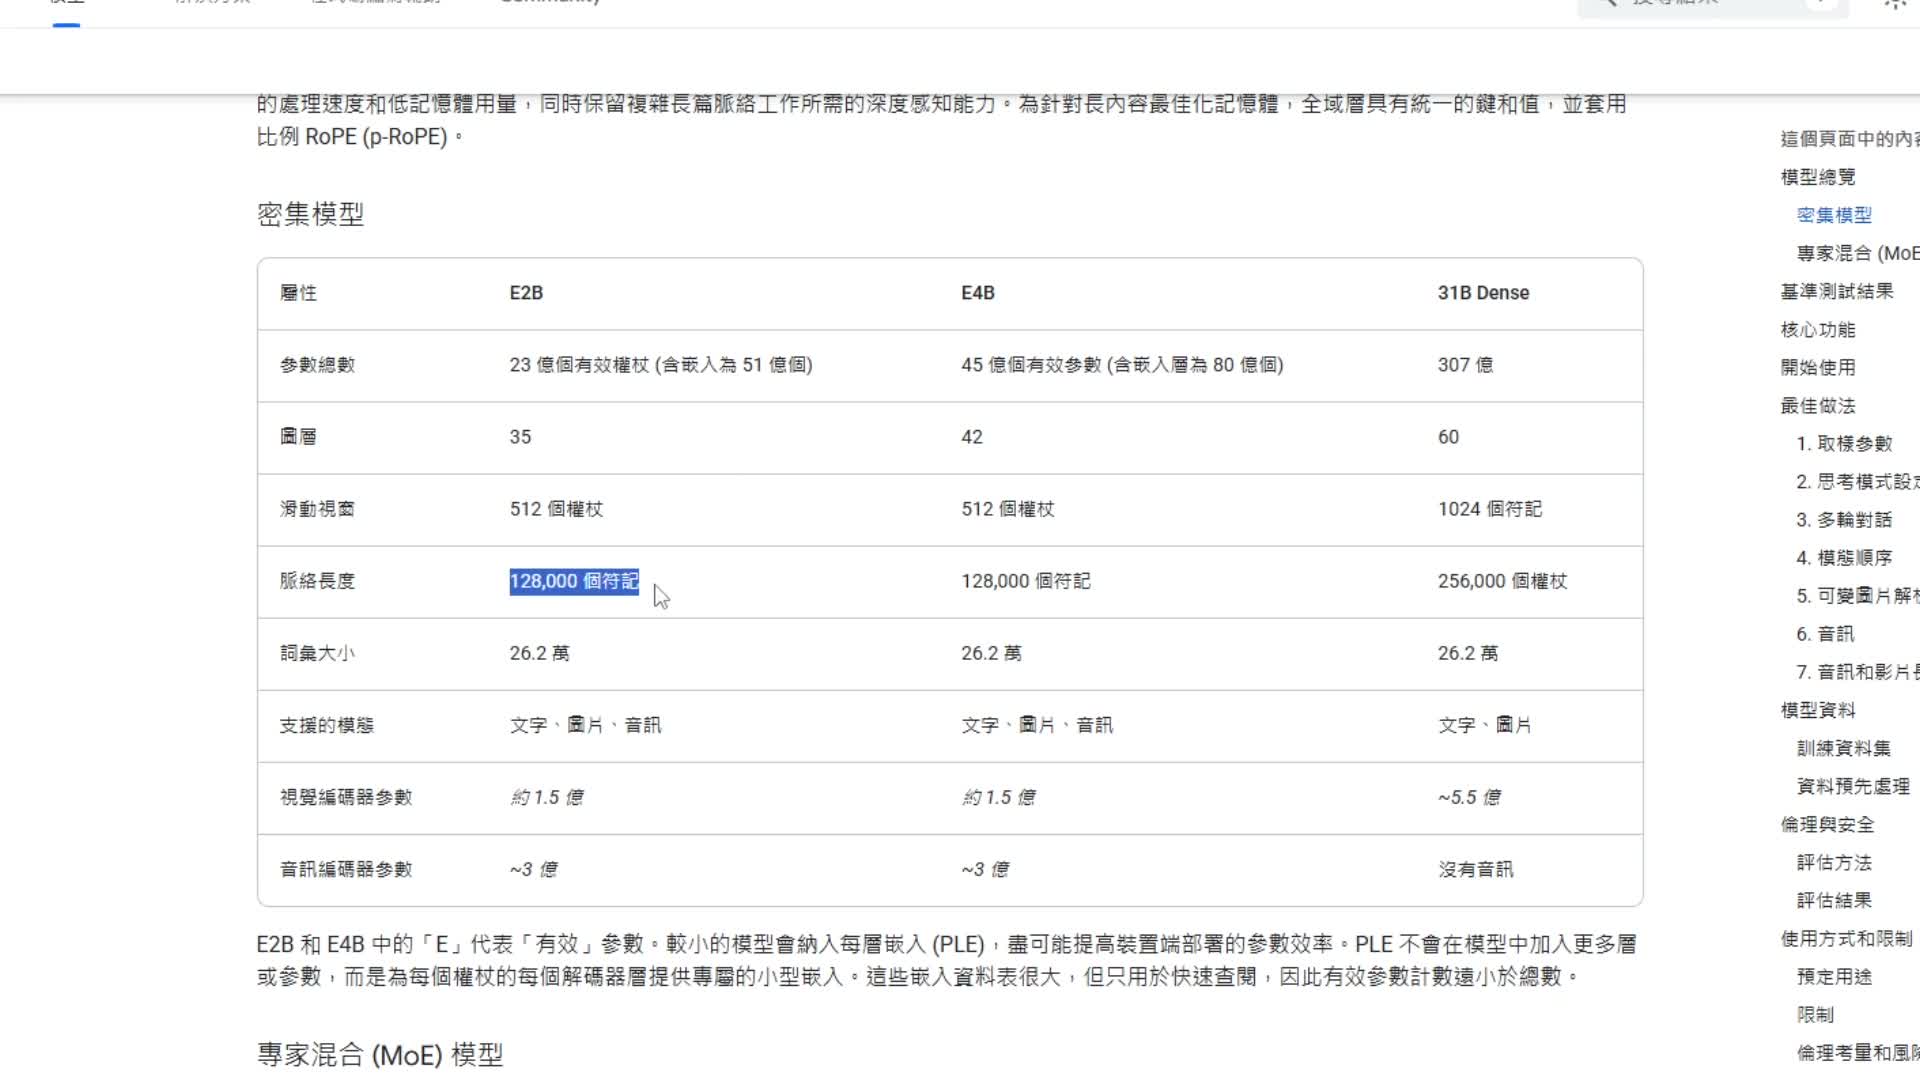
這次 Google Gemma 4 總共推出了四種不同參數量(Parameters)的版本,分別為 E2B, E4B, 26B A4B 與 31B,滿足邊緣運算到雲端伺服器的所有需求。
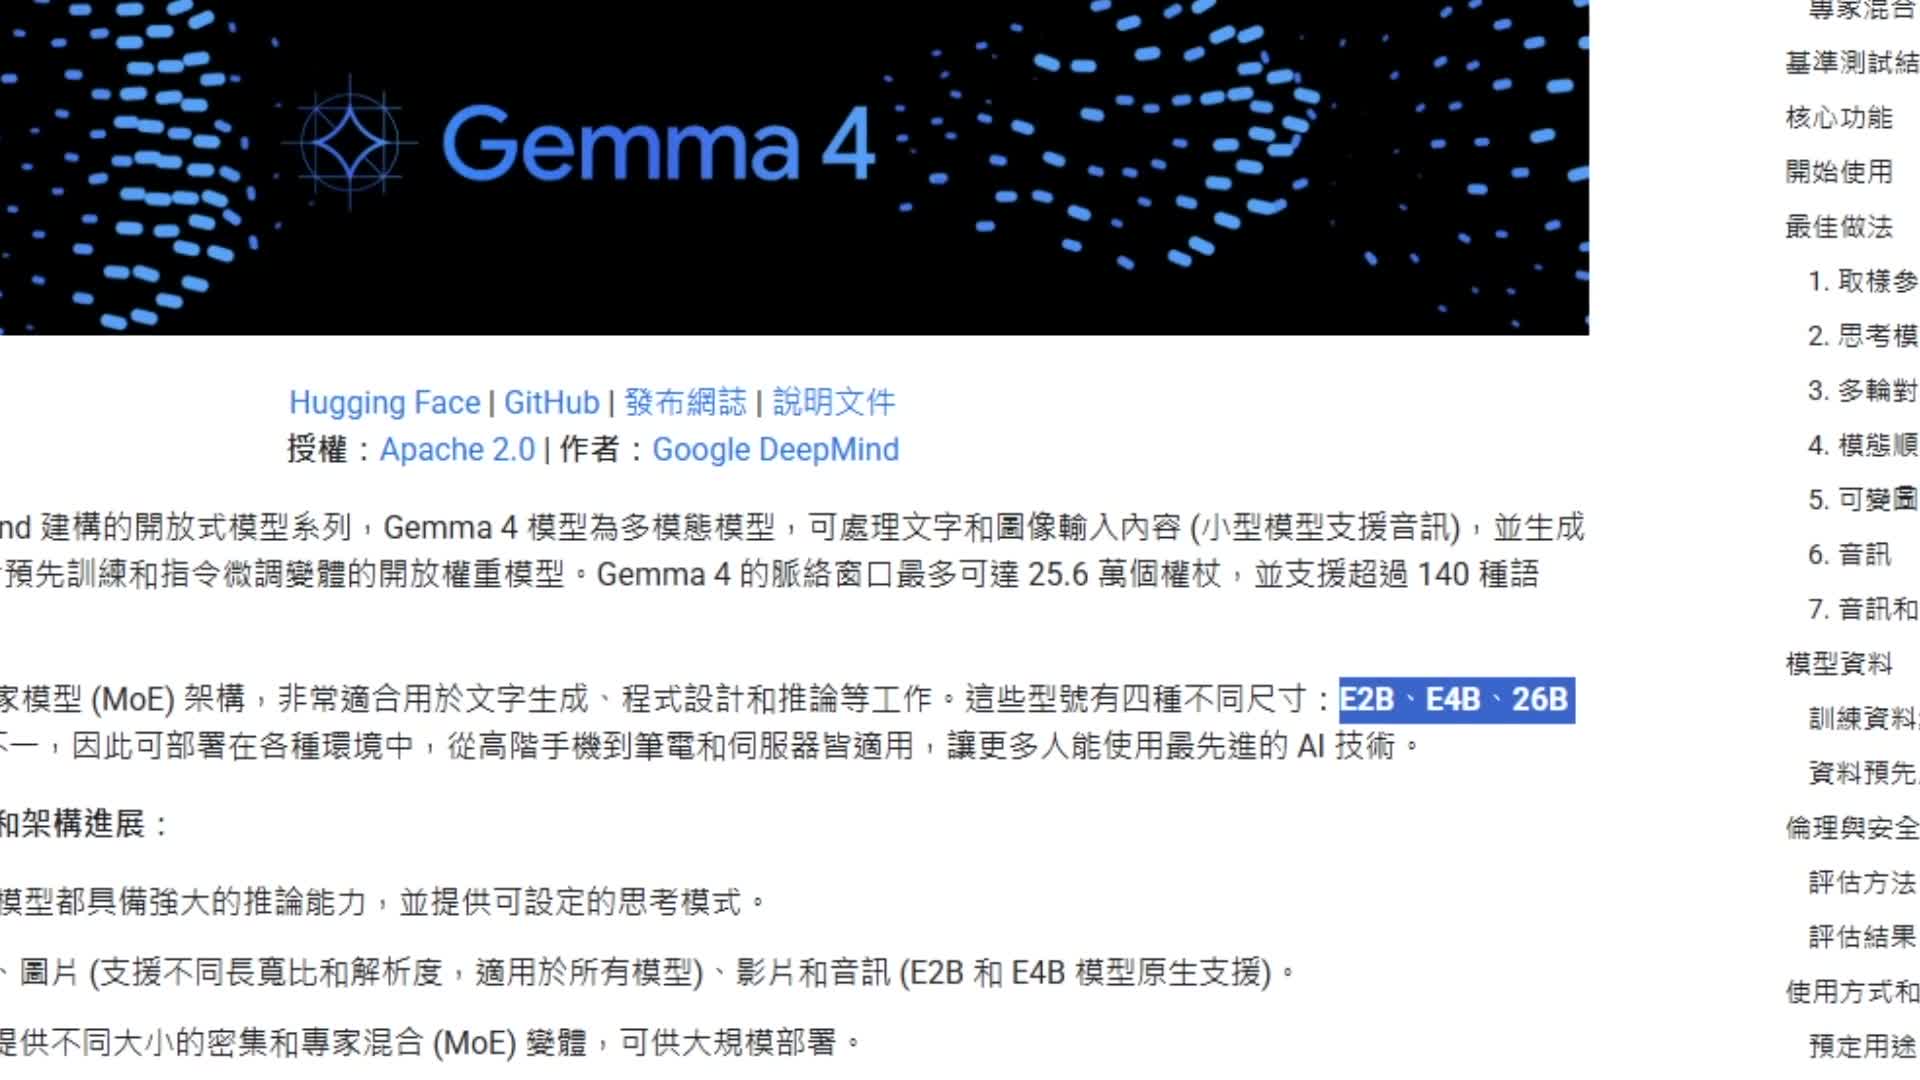
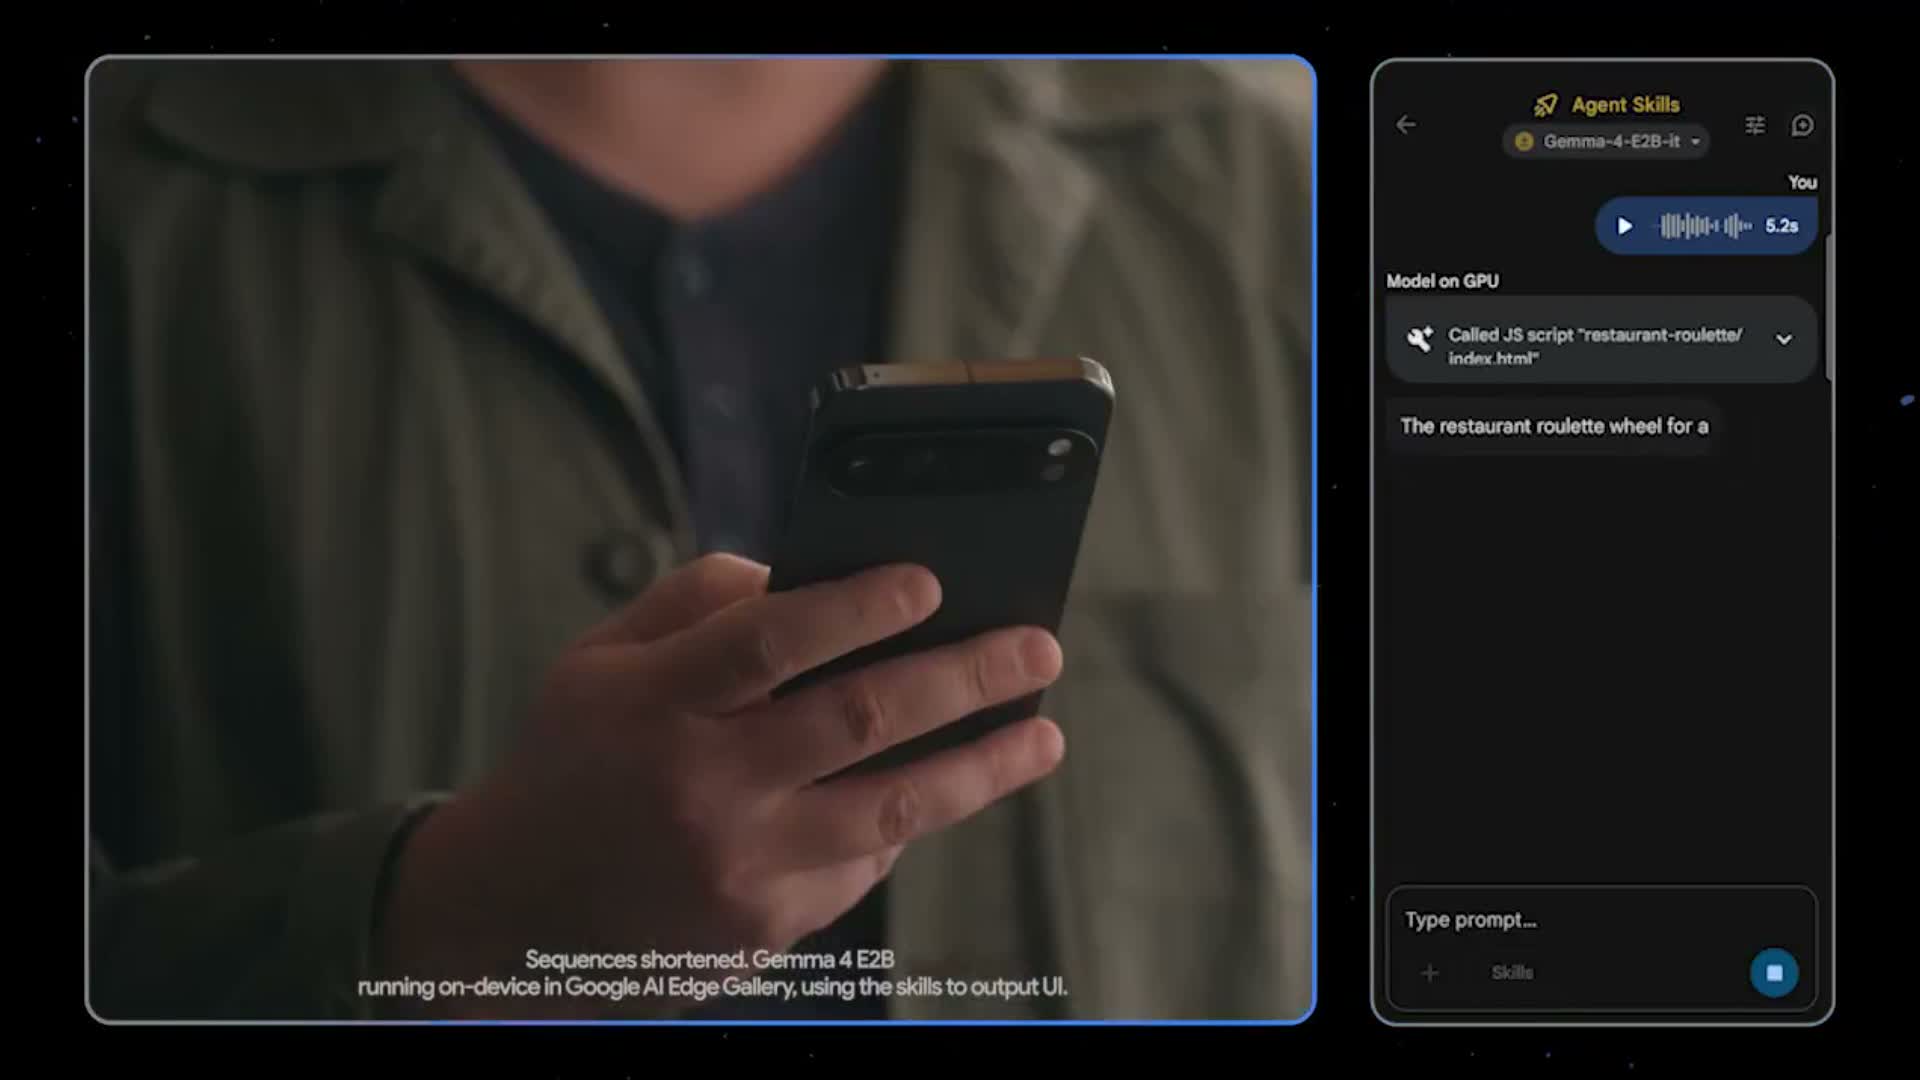
- E2B 與 E4B(適合輕量設備):最大上下文長度(Context Window)高達 128K,支援文字、圖像、音訊、影片等多模態輸入。
- 26B A4B 與 31B(適合高效能伺服器):最大上下文長度提升至 256K,支援文字、圖像與影片輸入(注意:大模型版本不支援音訊輸入)。
MoE 架構 vs 密集模型 (Dense) 差異
其中,最頂規的 31B 是標準的密集模型(Dense Model)。而 26B A4B 則是 Google 第一次開源的 MoE (Mixture-of-Experts) 專家混合架構模型。雖然總參數量高達 26B,但在實際運行推論時,只會動態啟動約 4B 的參數,大幅降低了硬體資源的消耗。

手機也能跑?E2B / E4B 與創新 PLE 技術解析
這次最特殊的亮點在於 E2B 與 E4B 這兩個版本。「E」代表的是「有效參數(Effective Parameters)」,這個命名方式曾出現在專為手機運行的 Gemma 3n 上。
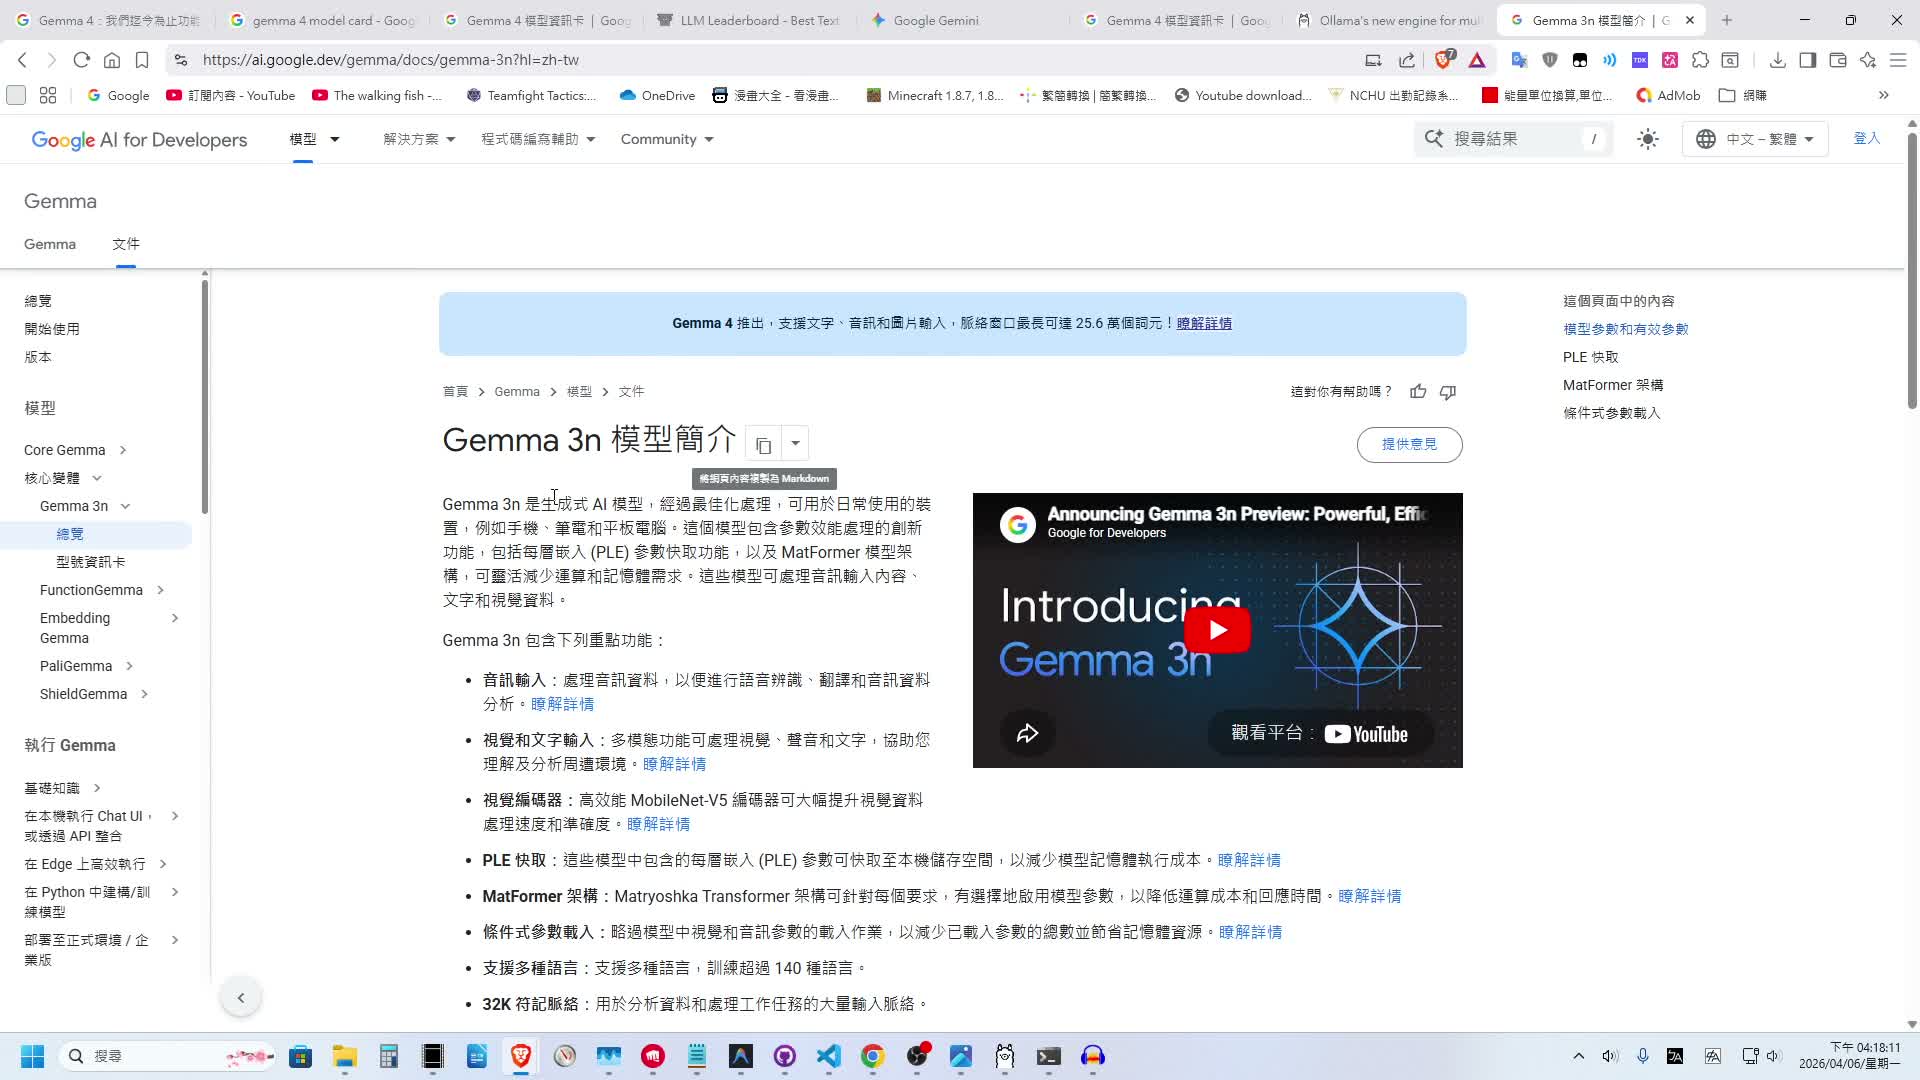
E2B 的總參數量實際上是 5.1B,E4B 則有 8B。但在進行推論時,真正參與運算的參數只有 2.3B 與 4.5B。這要歸功於全新的 Per-Layer Embedding (PLE) 技術。
傳統 LLM 只有在底部有一個巨大的 Embedding Layer(嵌入層)。而 PLE 則是在每一層(或特定層)額外新增 Layer,運作原理就像外掛一本字典,模型需要時才去查找相關向量並補充進去。這讓模型能攜帶龐大知識庫,卻不會增加額外的即時計算量。甚至可以將這些 Layer 放在系統 RAM 中交由 CPU 運算,為開發者節省寶貴的 GPU VRAM 資源!
Gemma 4 效能跑分表現:全面超越前代
除了先進的 PLE 架構,Gemma 4 系列相較於上一代的 Gemma 3 27B IT,展現了近乎全面的效能超越。
根據 Google 官方的 Benchmark 跑分資料,即便是小巧的 E4B 版本,在 MMMU Pro、LiveCodeBench V6 等高難度測試資料集上,表現也能贏過龐大的 Gemma 3 27B IT。

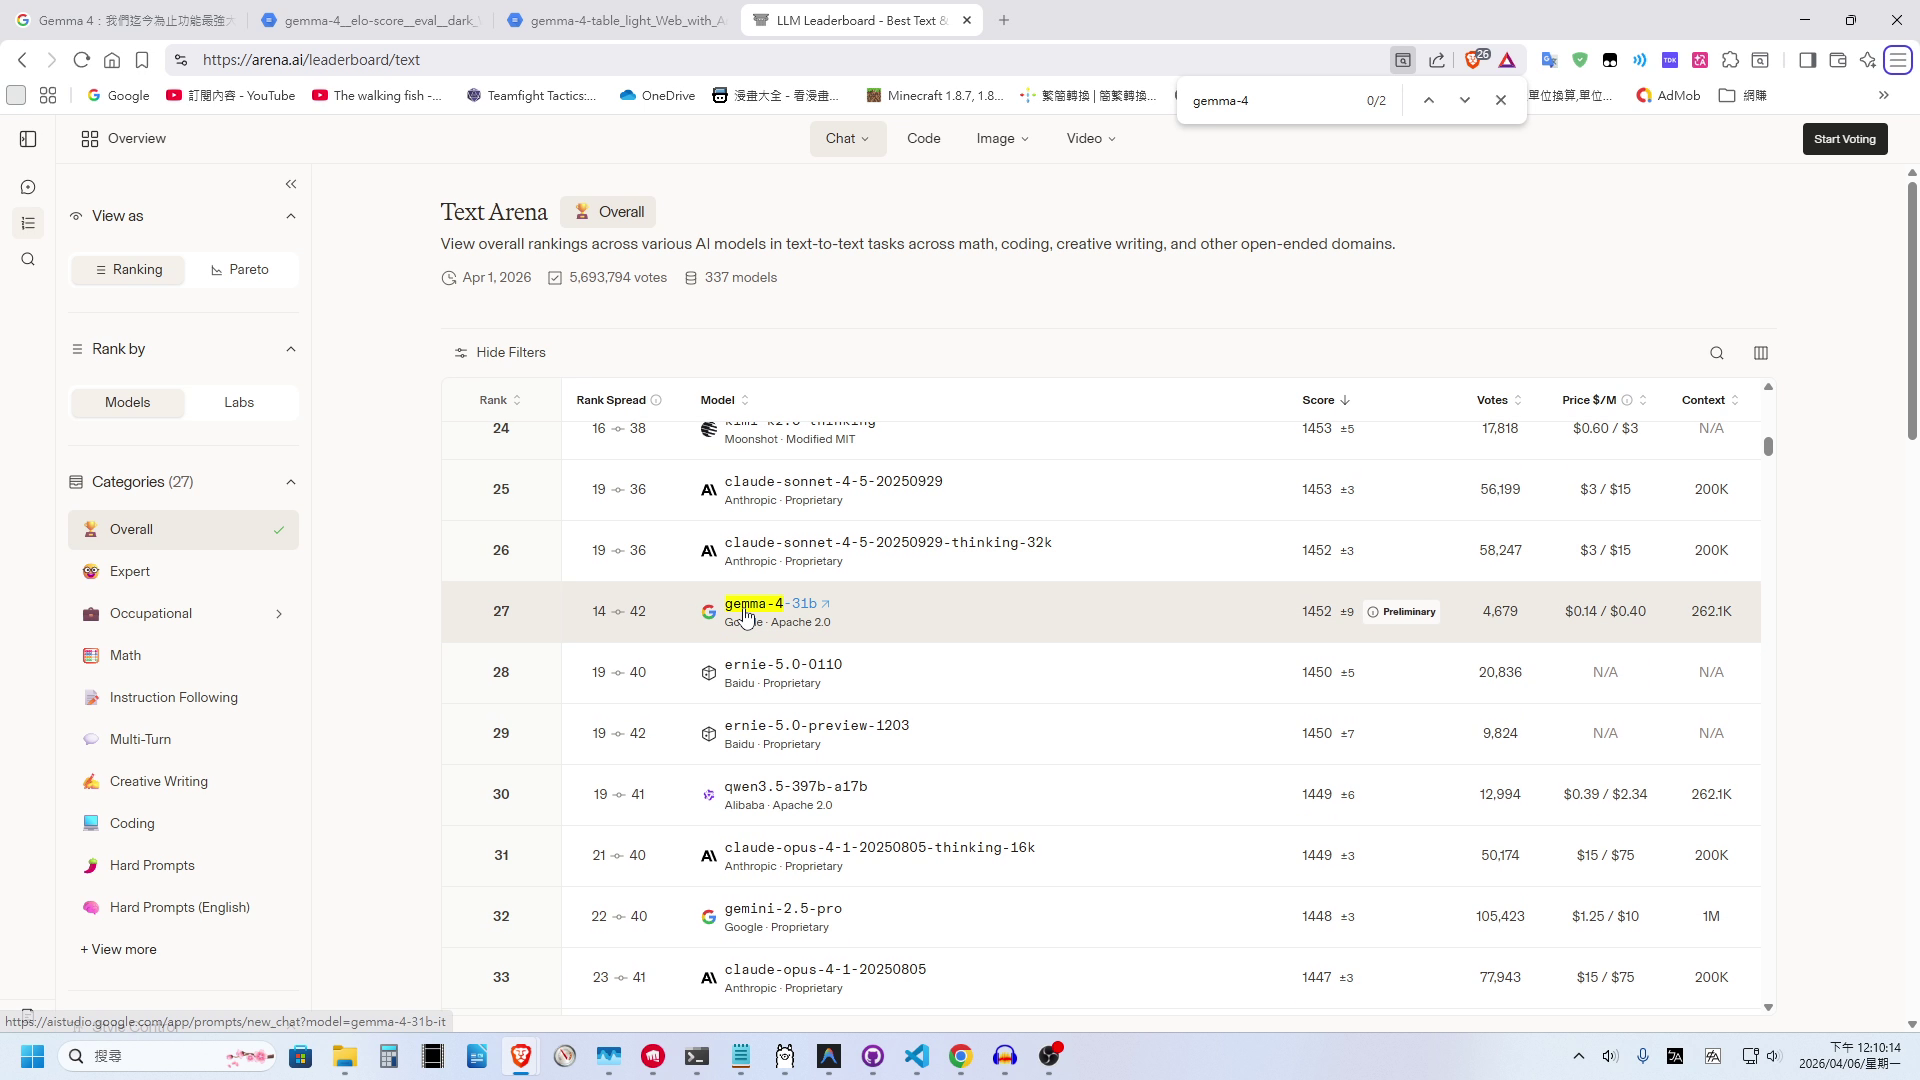
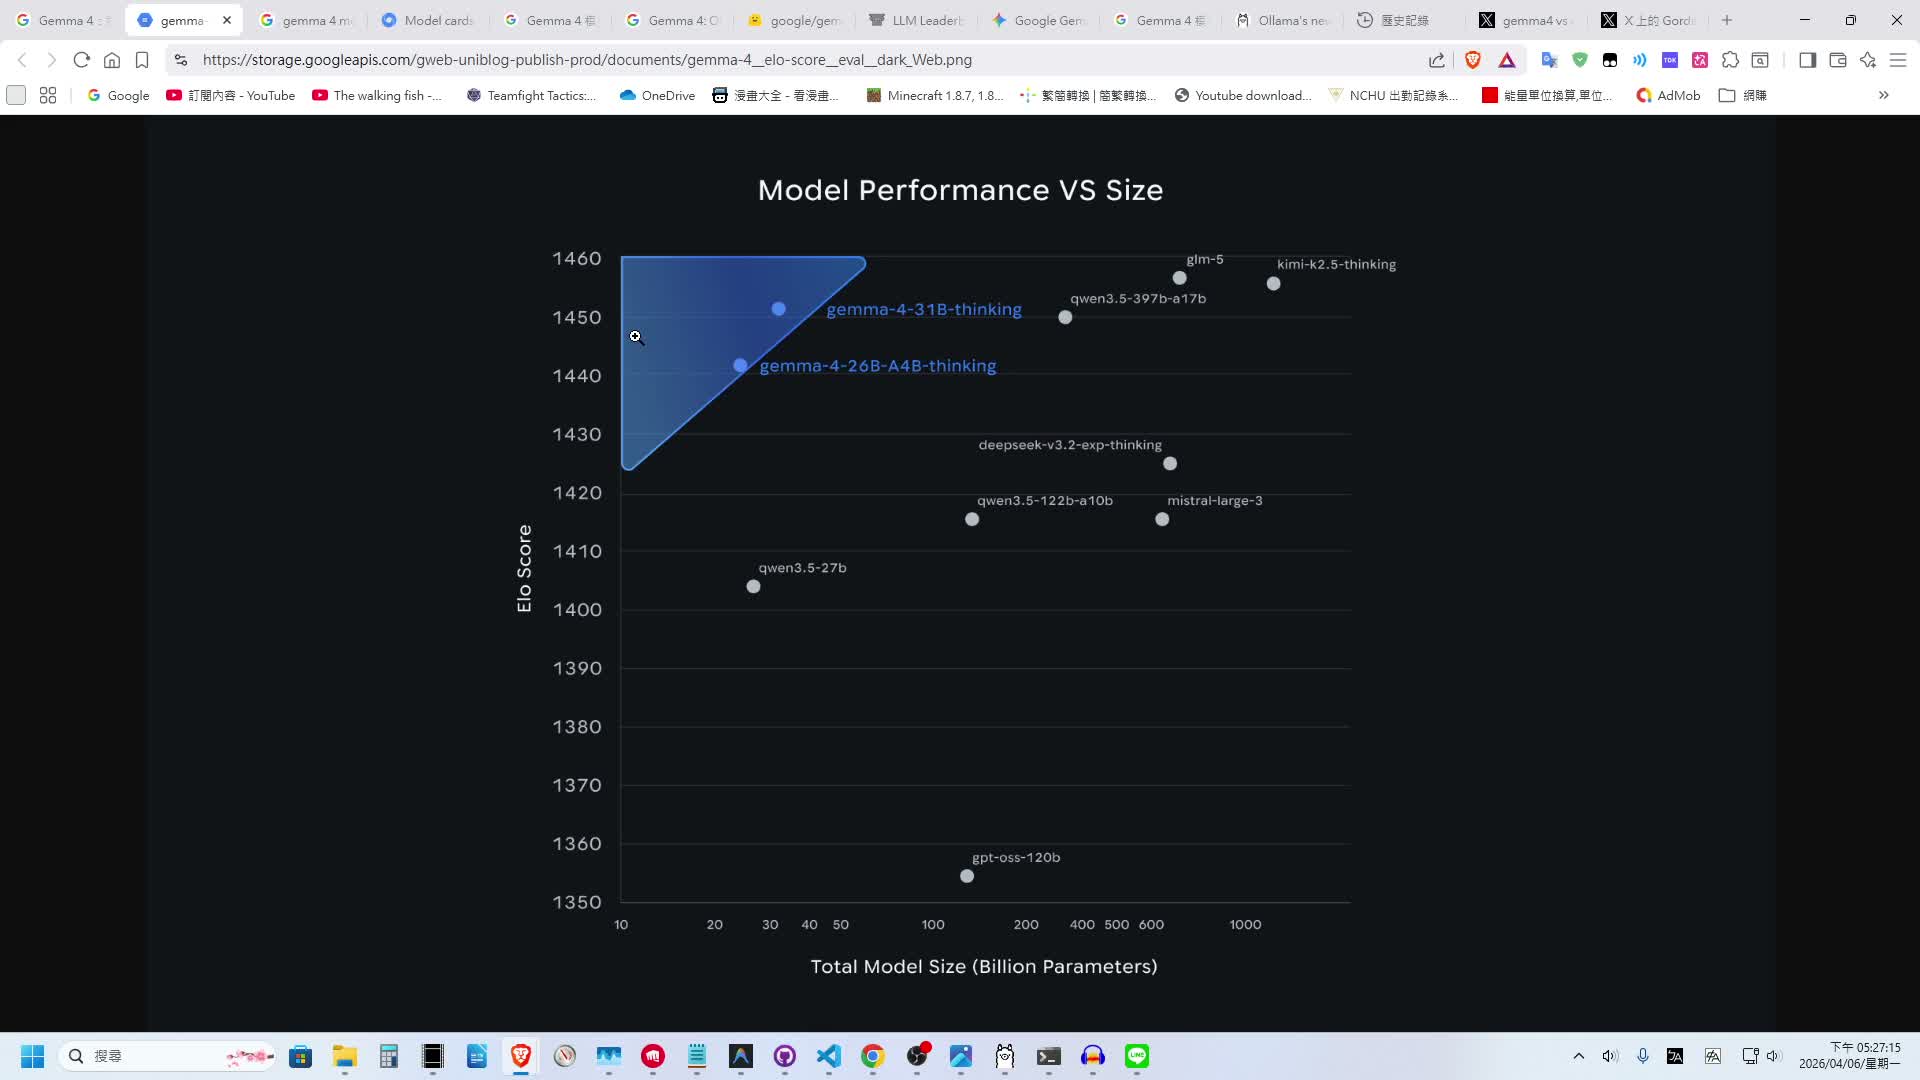
而在權威的語言模型競技場(LMSYS Chatbot Arena)排行榜上,Gemma 4 31B 與 26B A4B 分別空降了第 27 名與第 40 名。從官方提供的 Elo Score 可以明顯看出它對標其他開源模型的競爭優勢。
Gemma 4 免費試用與本機部署教學 (Ollama)
想要親自體驗 Gemma 4 嗎?這裡提供兩種最快速的方法:
1. Google AI Studio (線上免費試用)
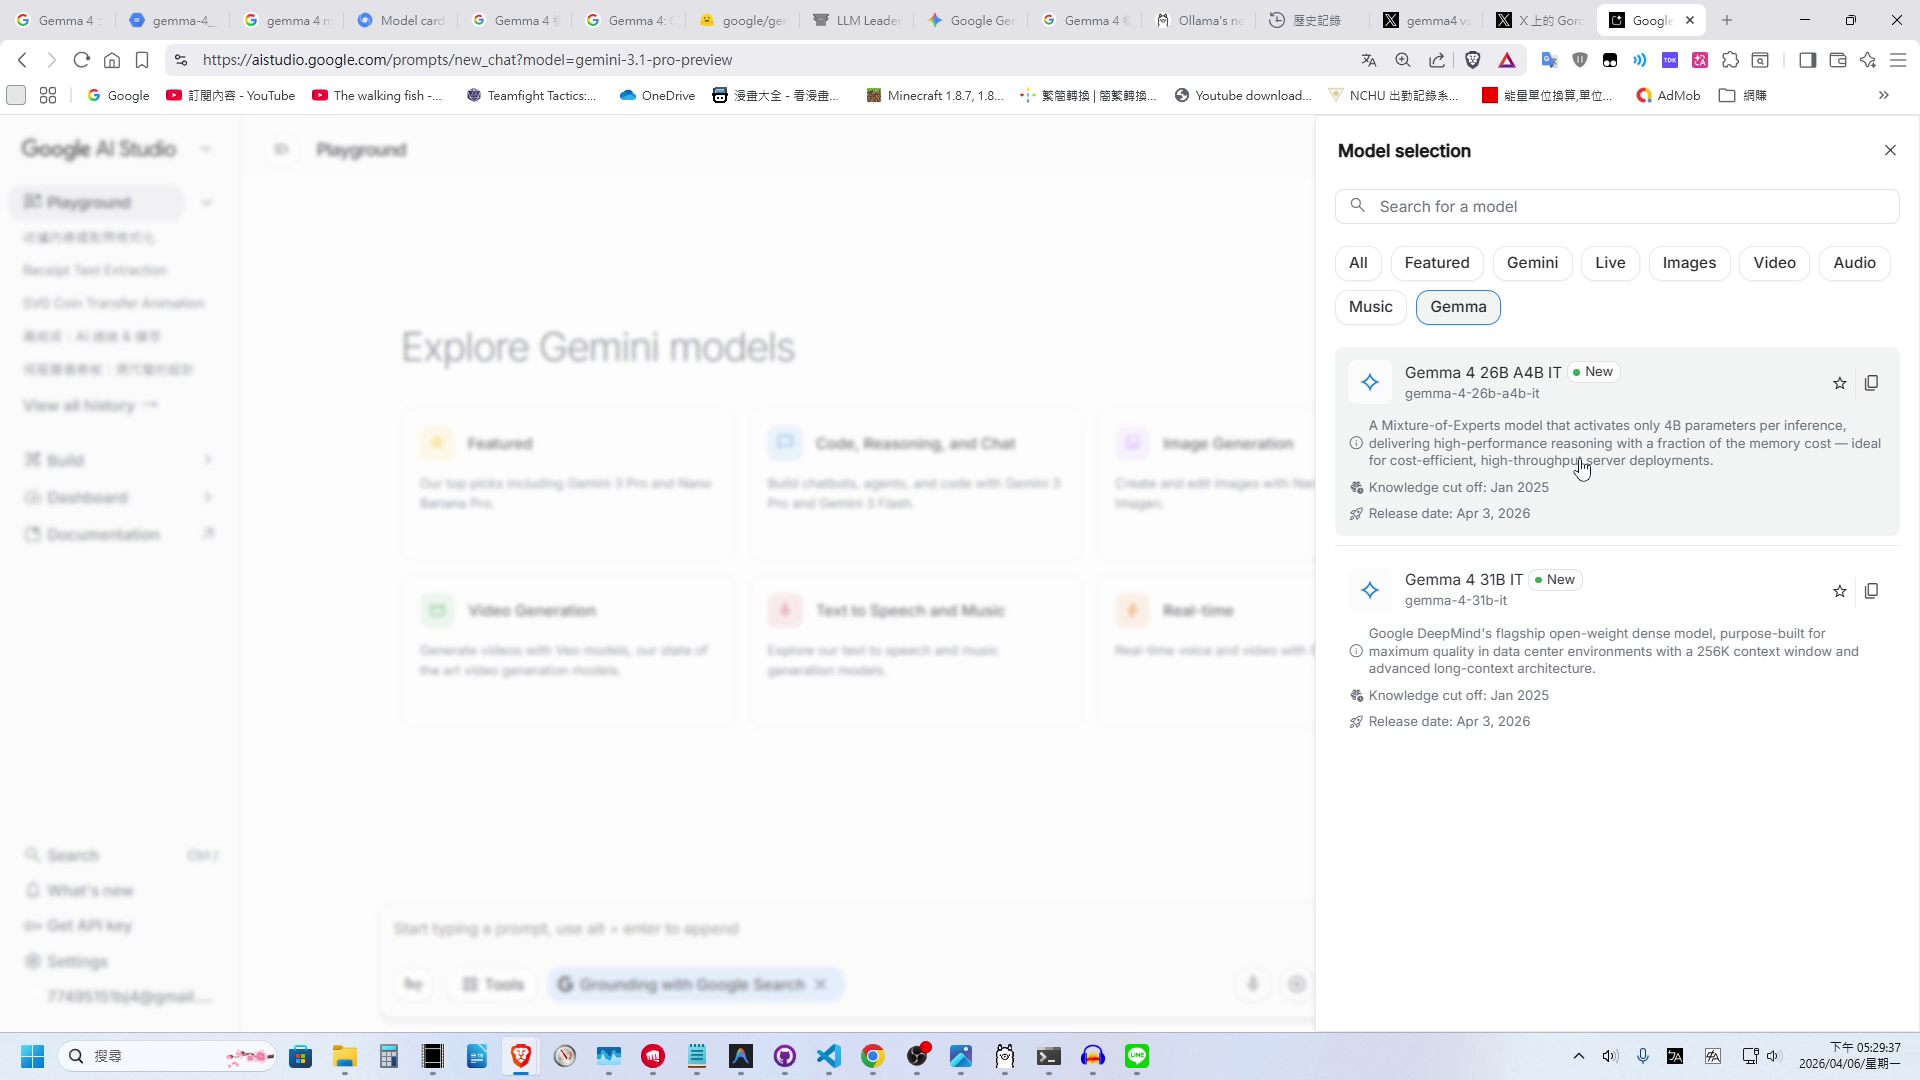
點擊網頁右上角的模型選擇,就可以直接免費用到最強大的 Gemma 4 31B 以及 26B A4B。適合不想佔用電腦資源的用戶。
2. 本機運行部署 (使用 Ollama)
如果你注重資安,想在自己的電腦上離線運行,強烈推薦使用 Ollama。前往官網下載並安裝後,打開終端機輸入指令即可。
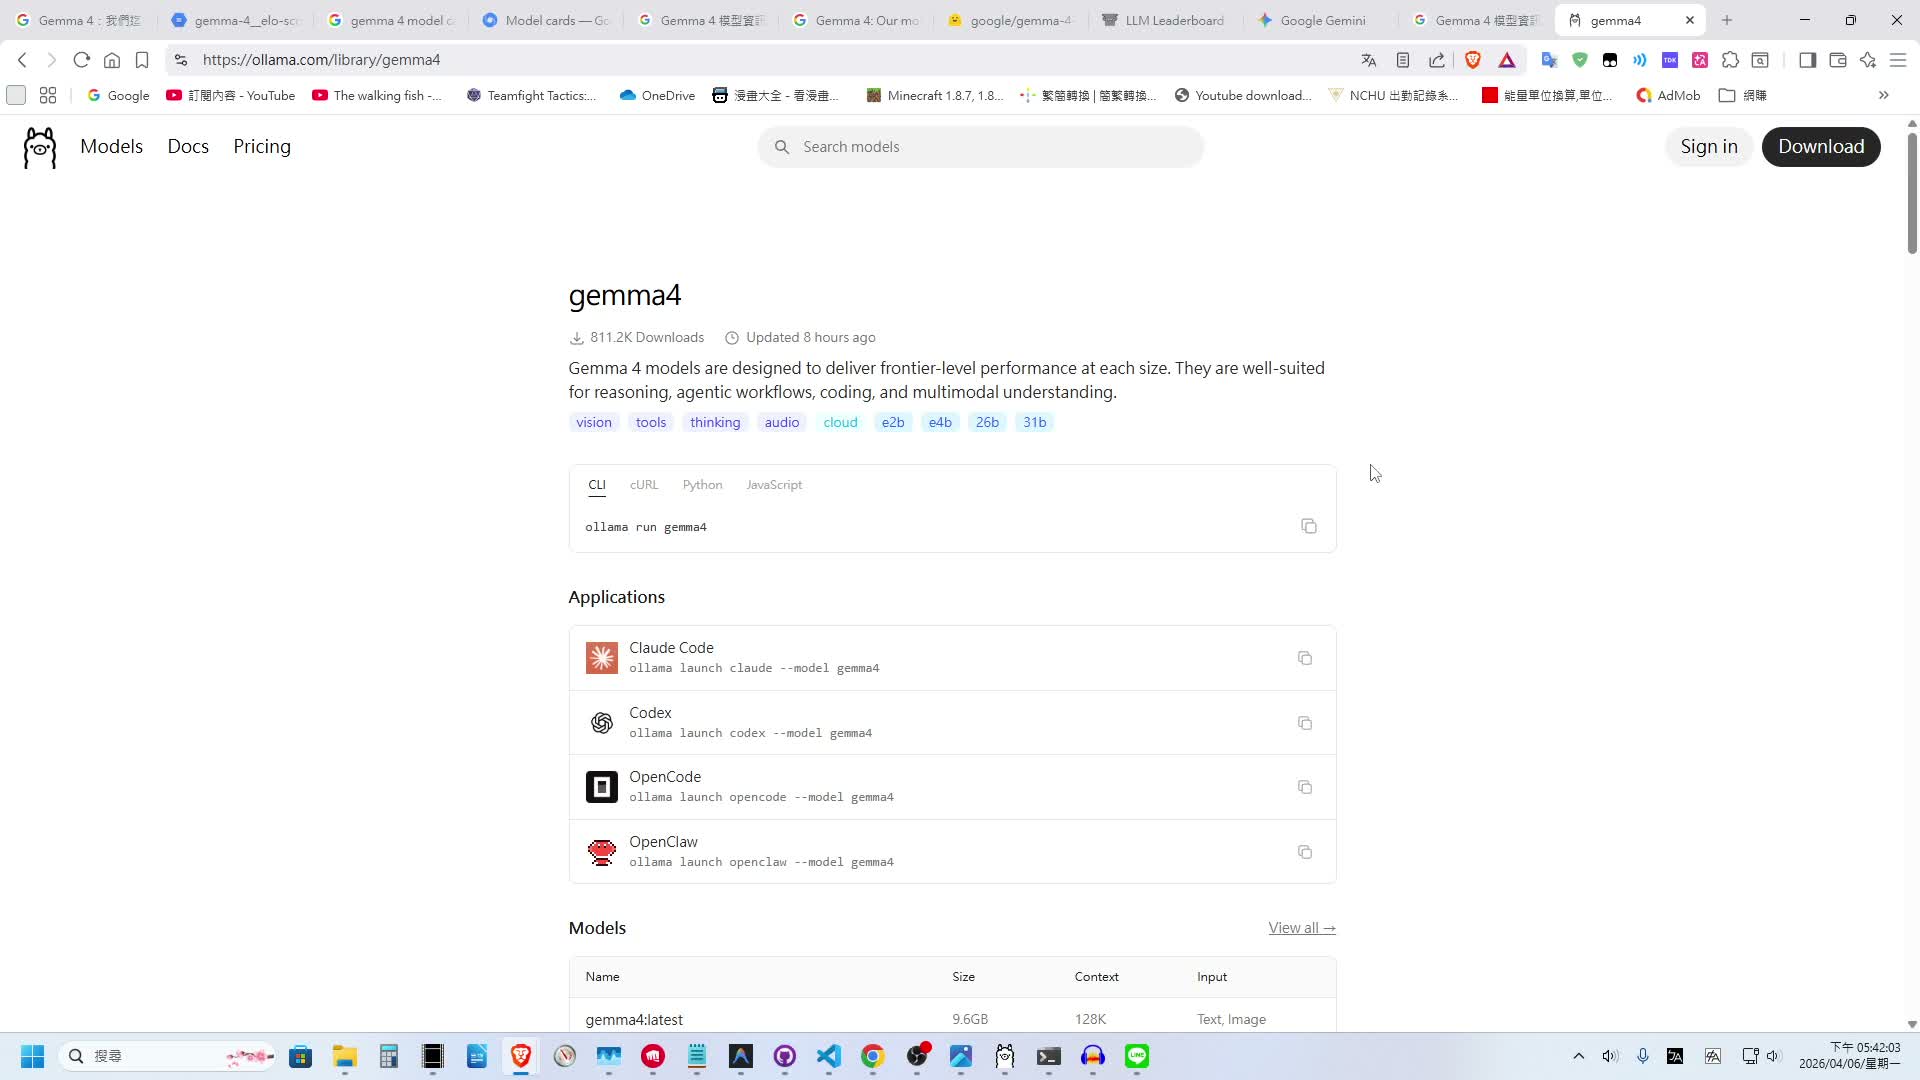
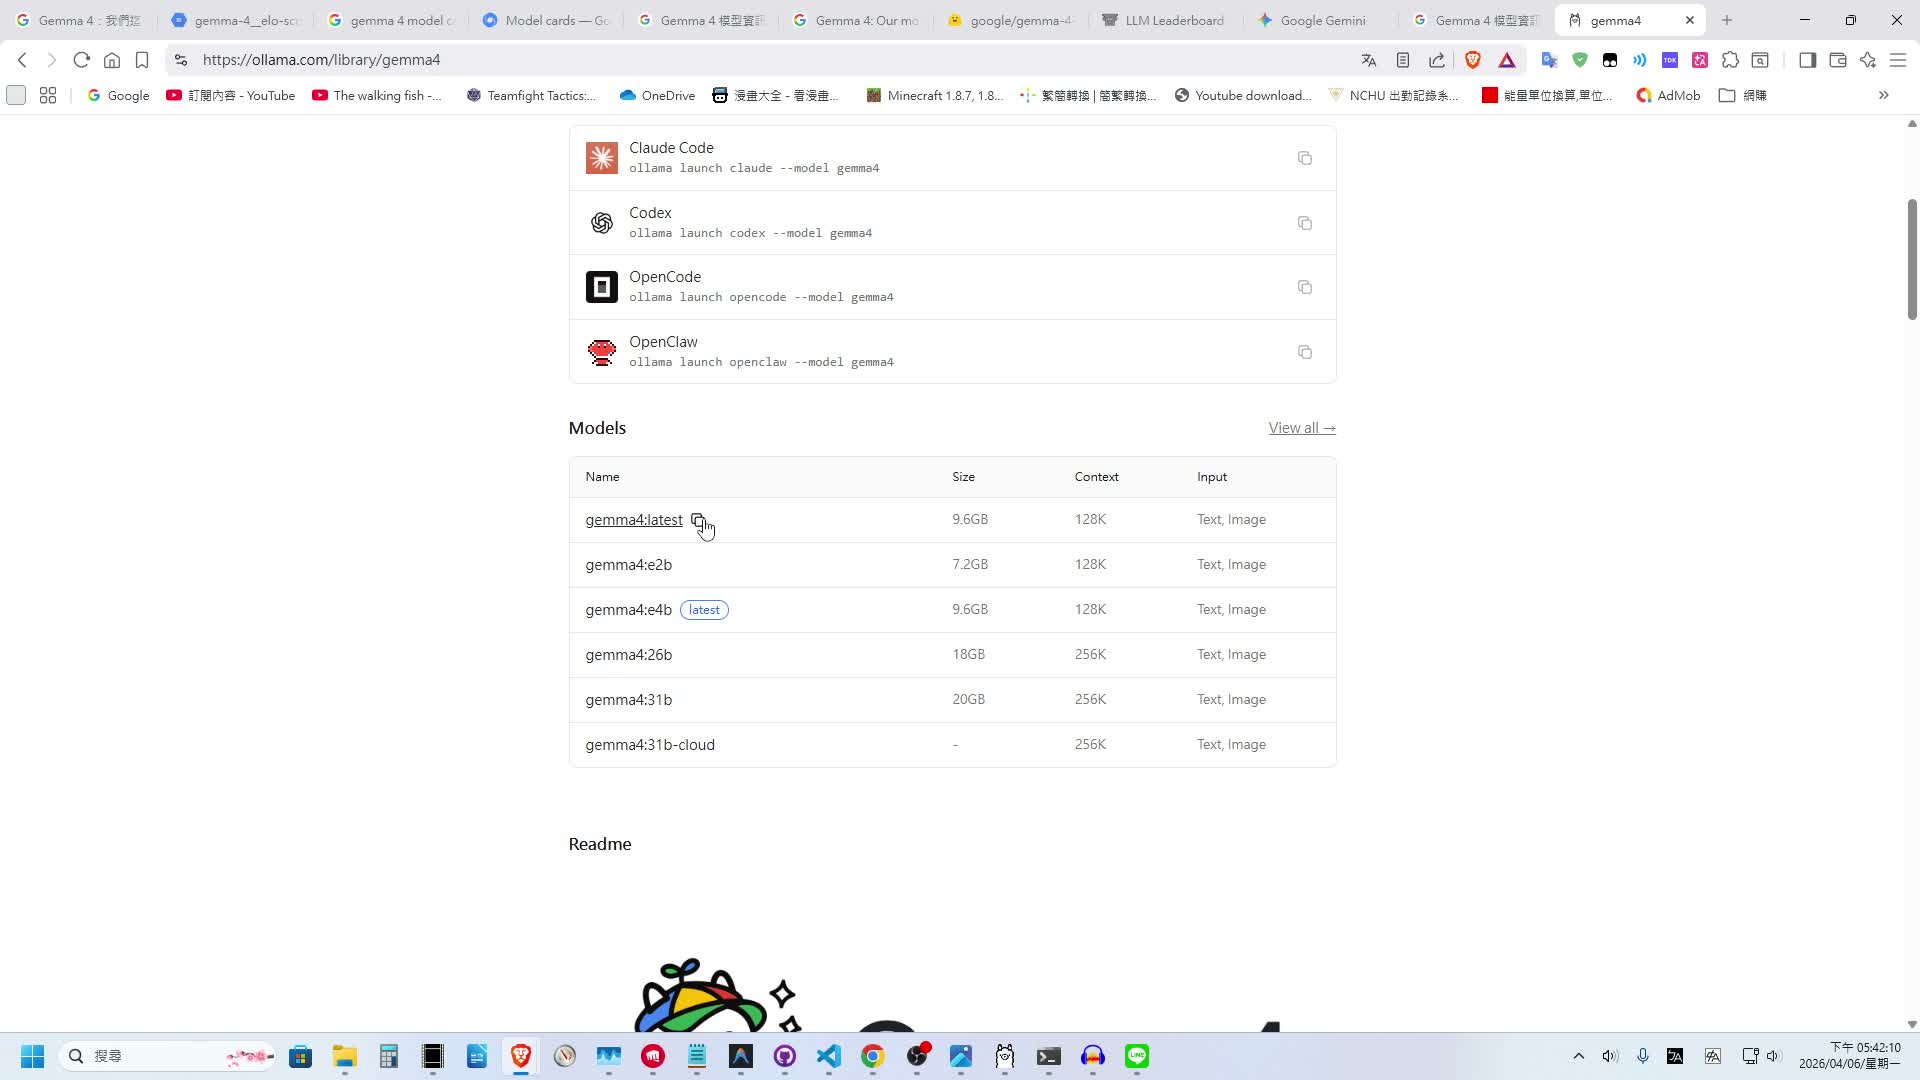
Gemma 4 E4B 下載運行指令:
|
|
💡 溫馨提醒:雖然 E4B 核心運算是 4B,但下載的實體模型約 8B,建議顯示卡 VRAM 至少有 8GB 才能順暢運行(特別是當你開啟大 Context Window 時)。不過受惠於 PLE 技術,即使沒有完全載入 VRAM,運行速度依然不算慢。
Gemma 4 深度實測:邏輯推理、網頁設計與多模態表現
接下來進入重頭戲,我們針對 Gemma 4 E4B 與 26B A4B (Q4 量化版) 進行了一系列極限測試,並以競爭對手 Qwen 3.5 (9B 與 35B) 作為對照組。
1. 網路搜尋與資料整理能力
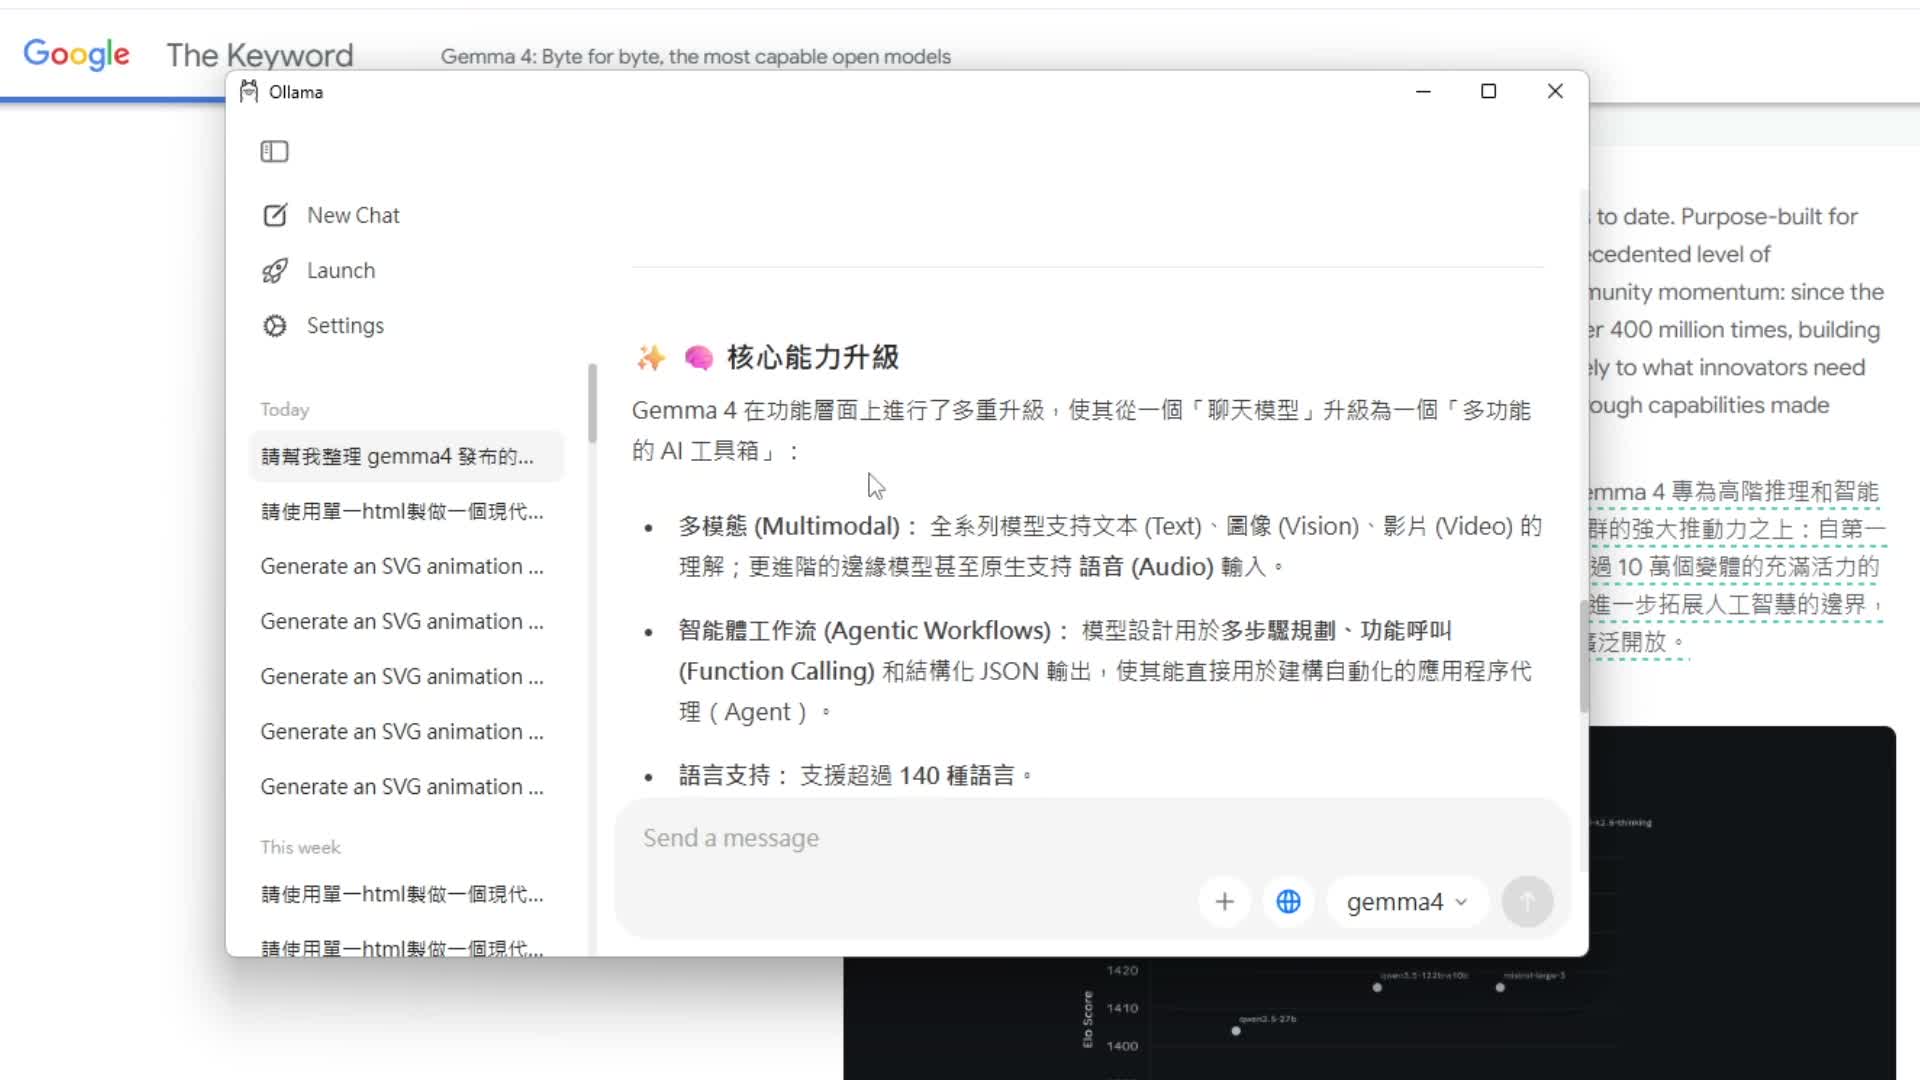
在 Ollama 介面開啟網路搜尋功能,請模型整理近期的新聞。Gemma 4 的兩款模型表現都相當優異,精準抓到了資訊重點,沒有出現明顯的 AI 幻覺。
2. 邏輯推理測試:Gemma 4 意外翻車?
我使用了一套經典的「左輪手槍生死局」邏輯提示詞進行測試,這非常考驗模型的純粹機率計算與邏輯推演能力。
測試提示詞:
現在請回答這個邏輯思考題:
想像你正被綁在椅子上動彈不得,歹徒拿著一把6個槍膛全空的槍,再裝兩顆子彈進兩個緊鄰的槍膛內,並旋轉槍膛。然後對著你的腦袋扣板機一下,很幸運你還活著,這時他說再扣一次板機就放你走,你希望先旋轉後再扣或直接扣板機?為什麼?
本以為現在的模型開啟思考(Thinking)都能輕鬆答對,但 Gemma 4 E4B 竟然無法正確回答! 它一直試圖將這道數學機率題導向「心理博弈」與「犯罪心理學」。反觀對照組 Qwen 3.5,連更小參數的 4B 版本都能正確答對這題。
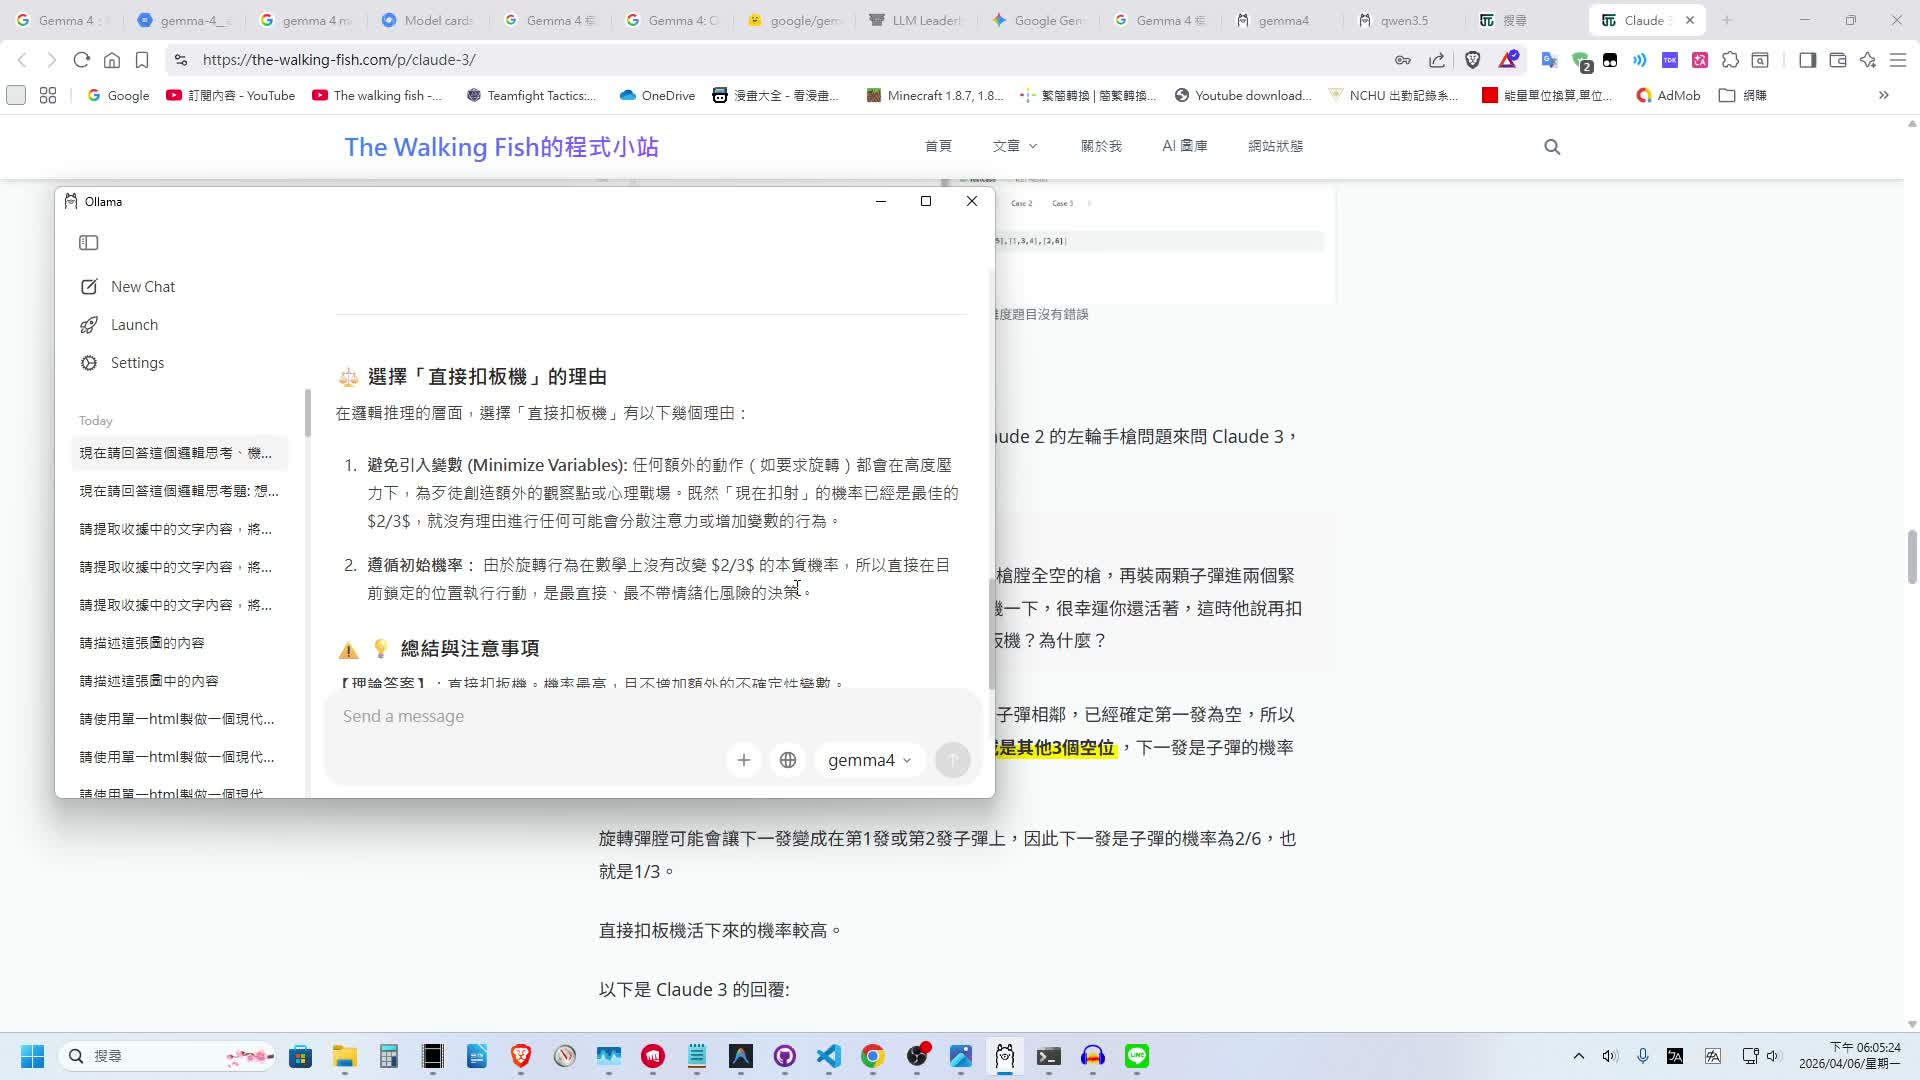
這是一個極端壓力下的邏輯判斷題,涉及到權力結構、恐懼和時間控制。在這種生死攸關的虛擬情境中,我們必須從**「最大化規避錯誤的機率」**角度來思考。
邏輯分析的結論: 你應該立刻要求他扣扳機,不給他旋轉和停頓的機會。
(正如你所見,它完全放棄了數學機率計算,直接把這題當成了犯罪心理學來分析…)
👉 點擊展開查看 Gemma 4 E4B 完整的「心理博弈」胡扯分析
|
|
3. AI 網頁設計與程式碼撰寫實測
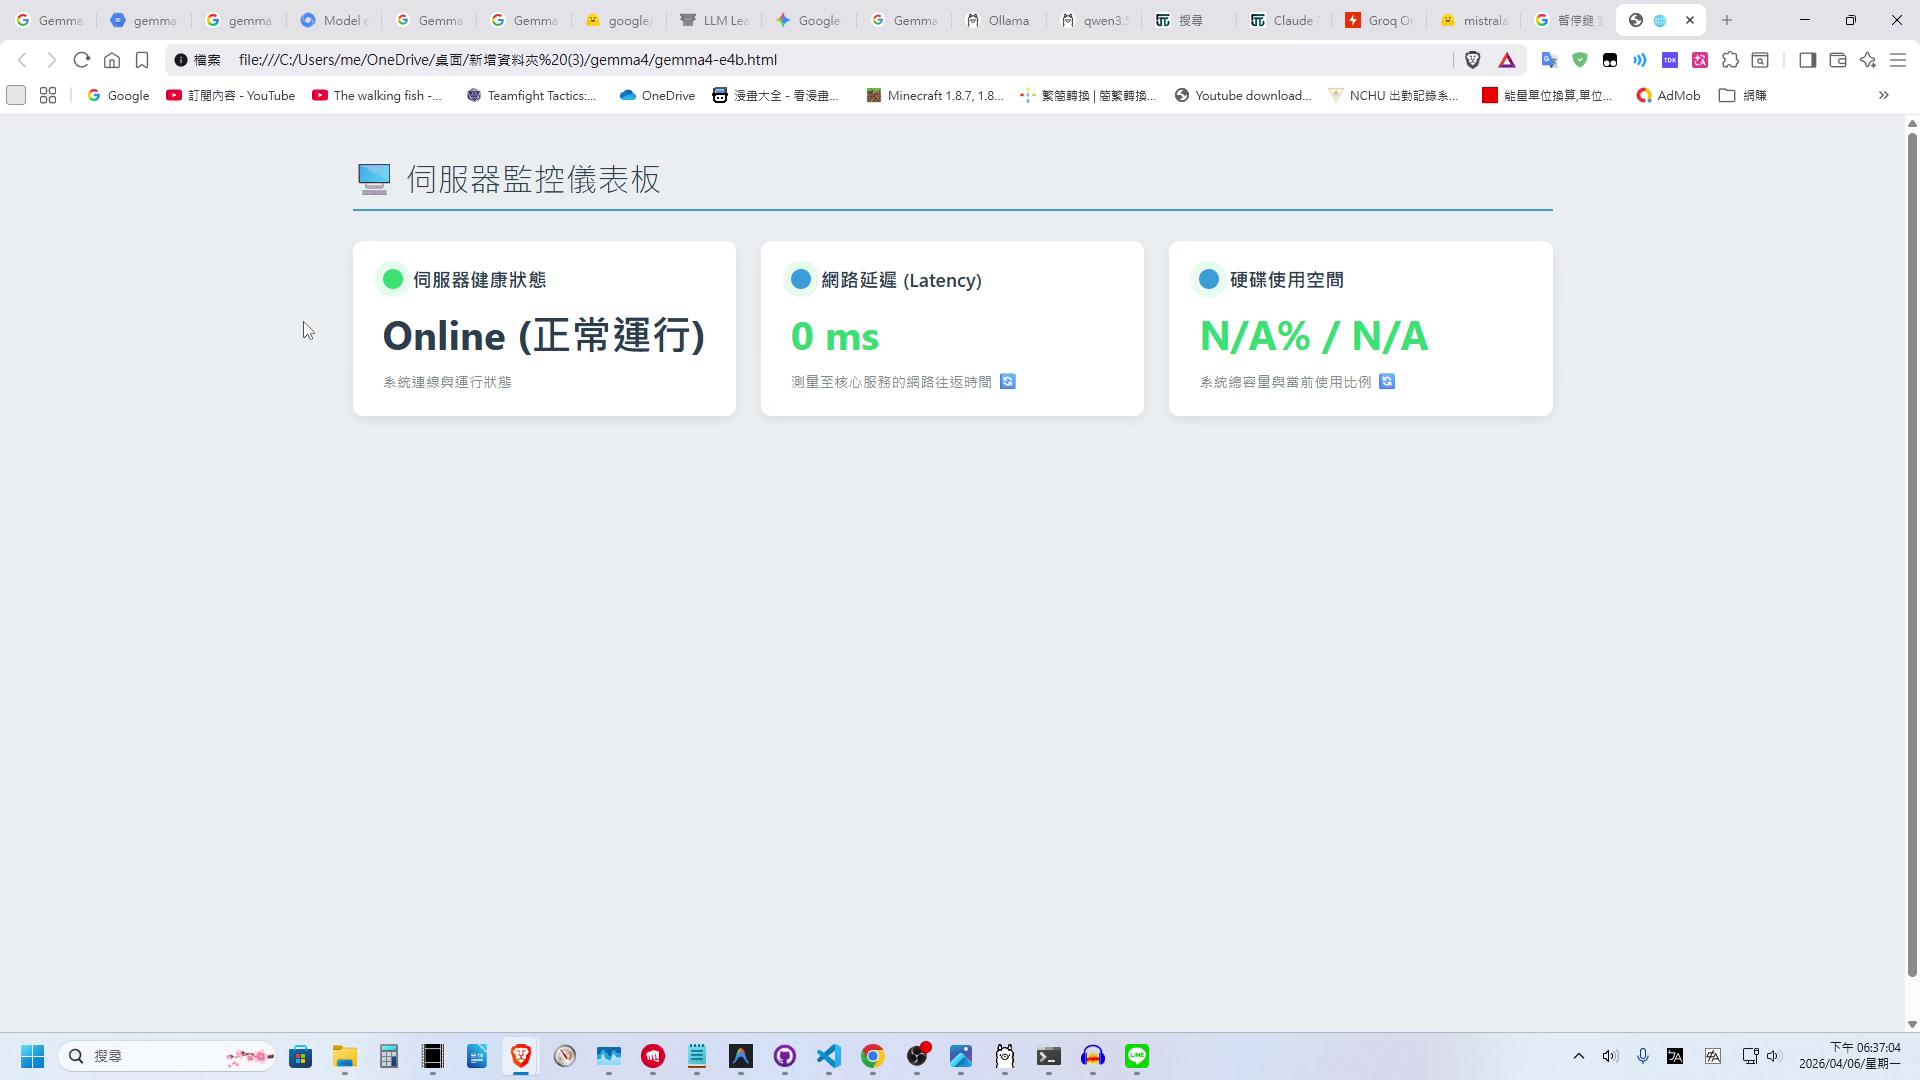
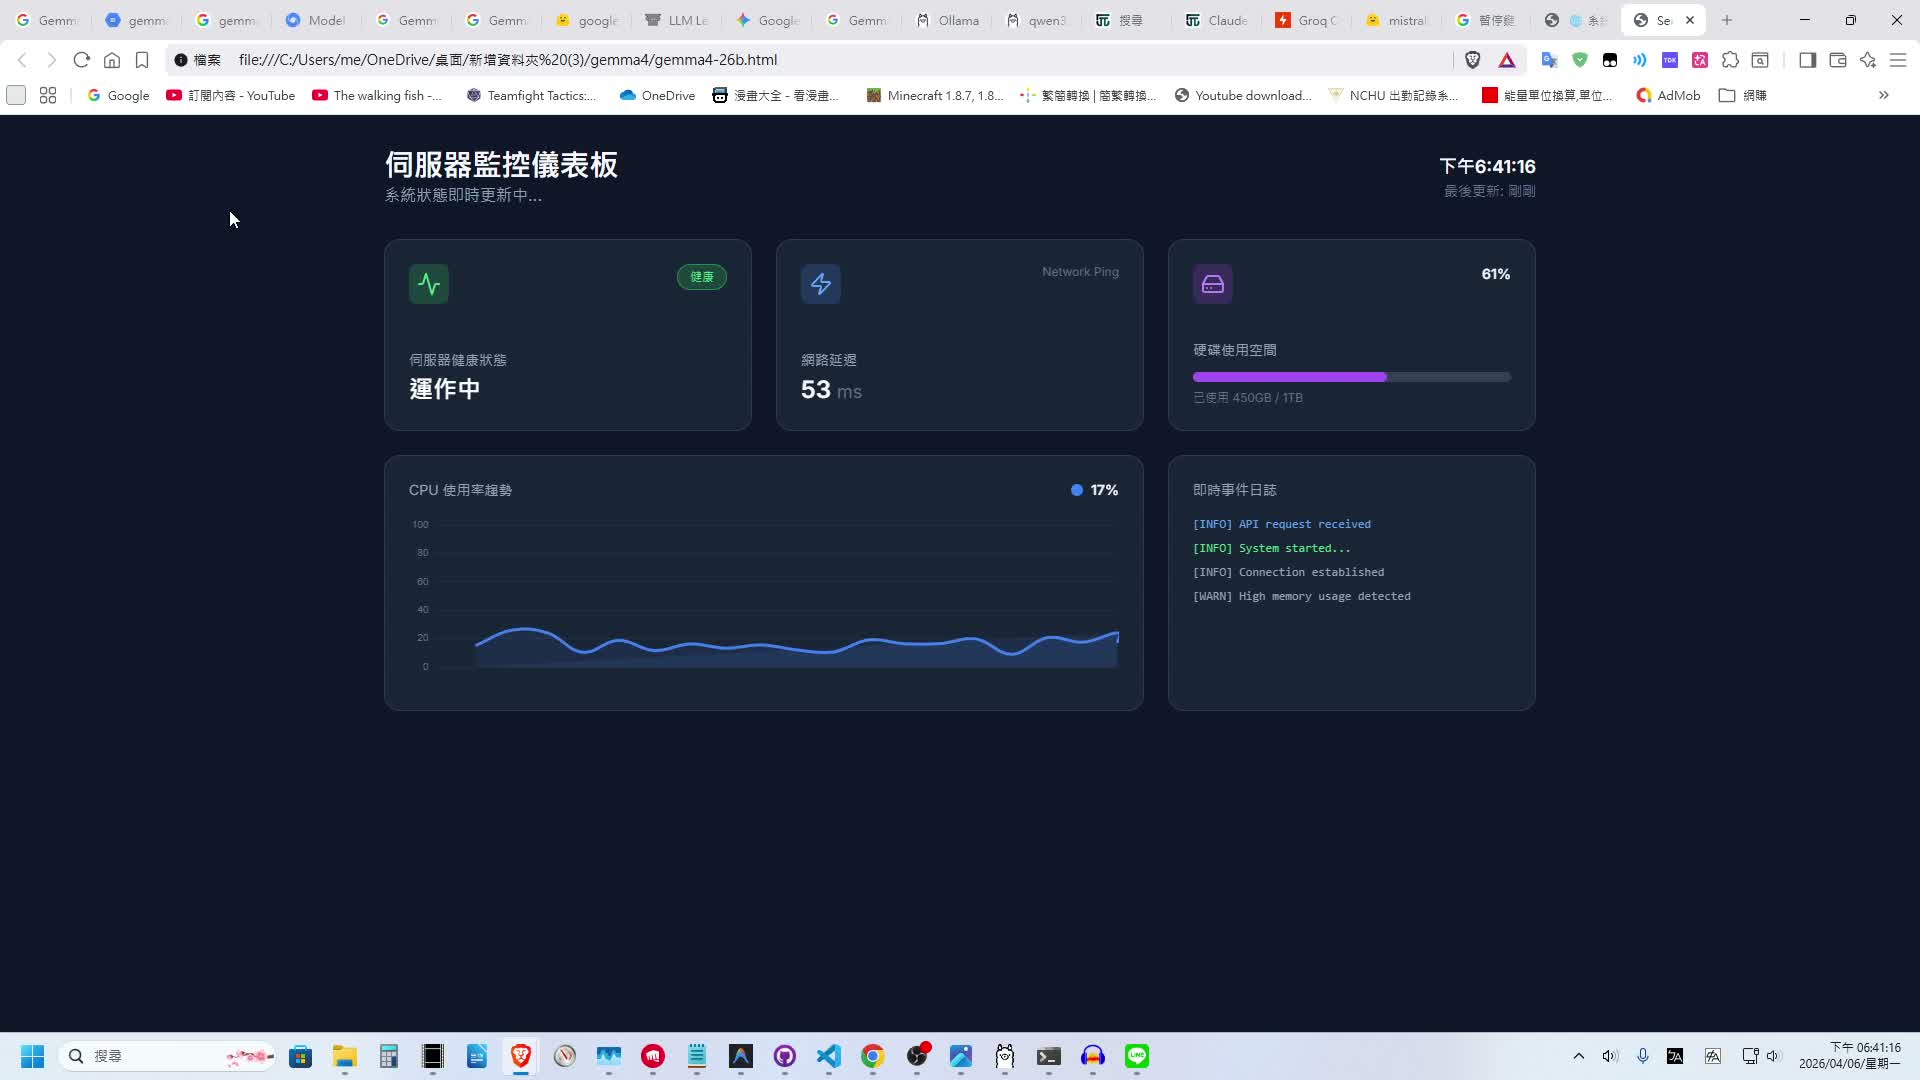
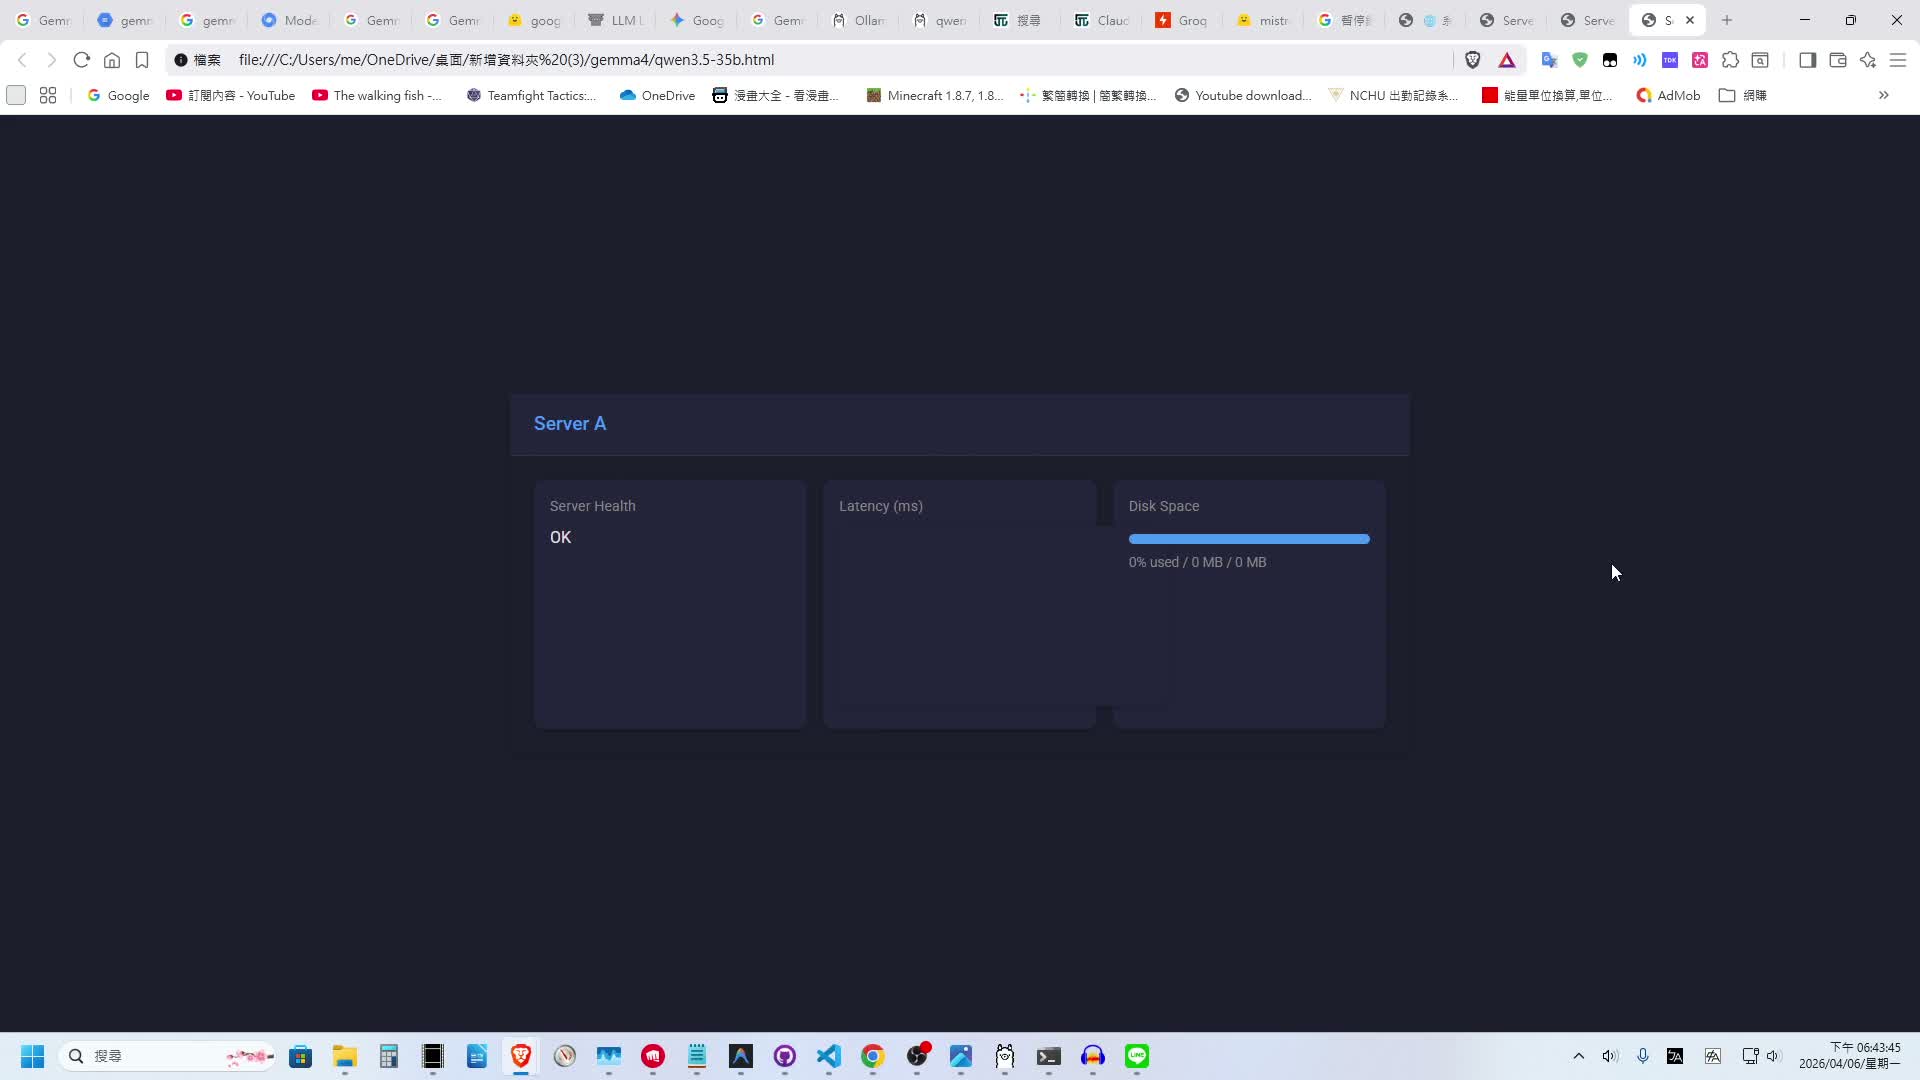
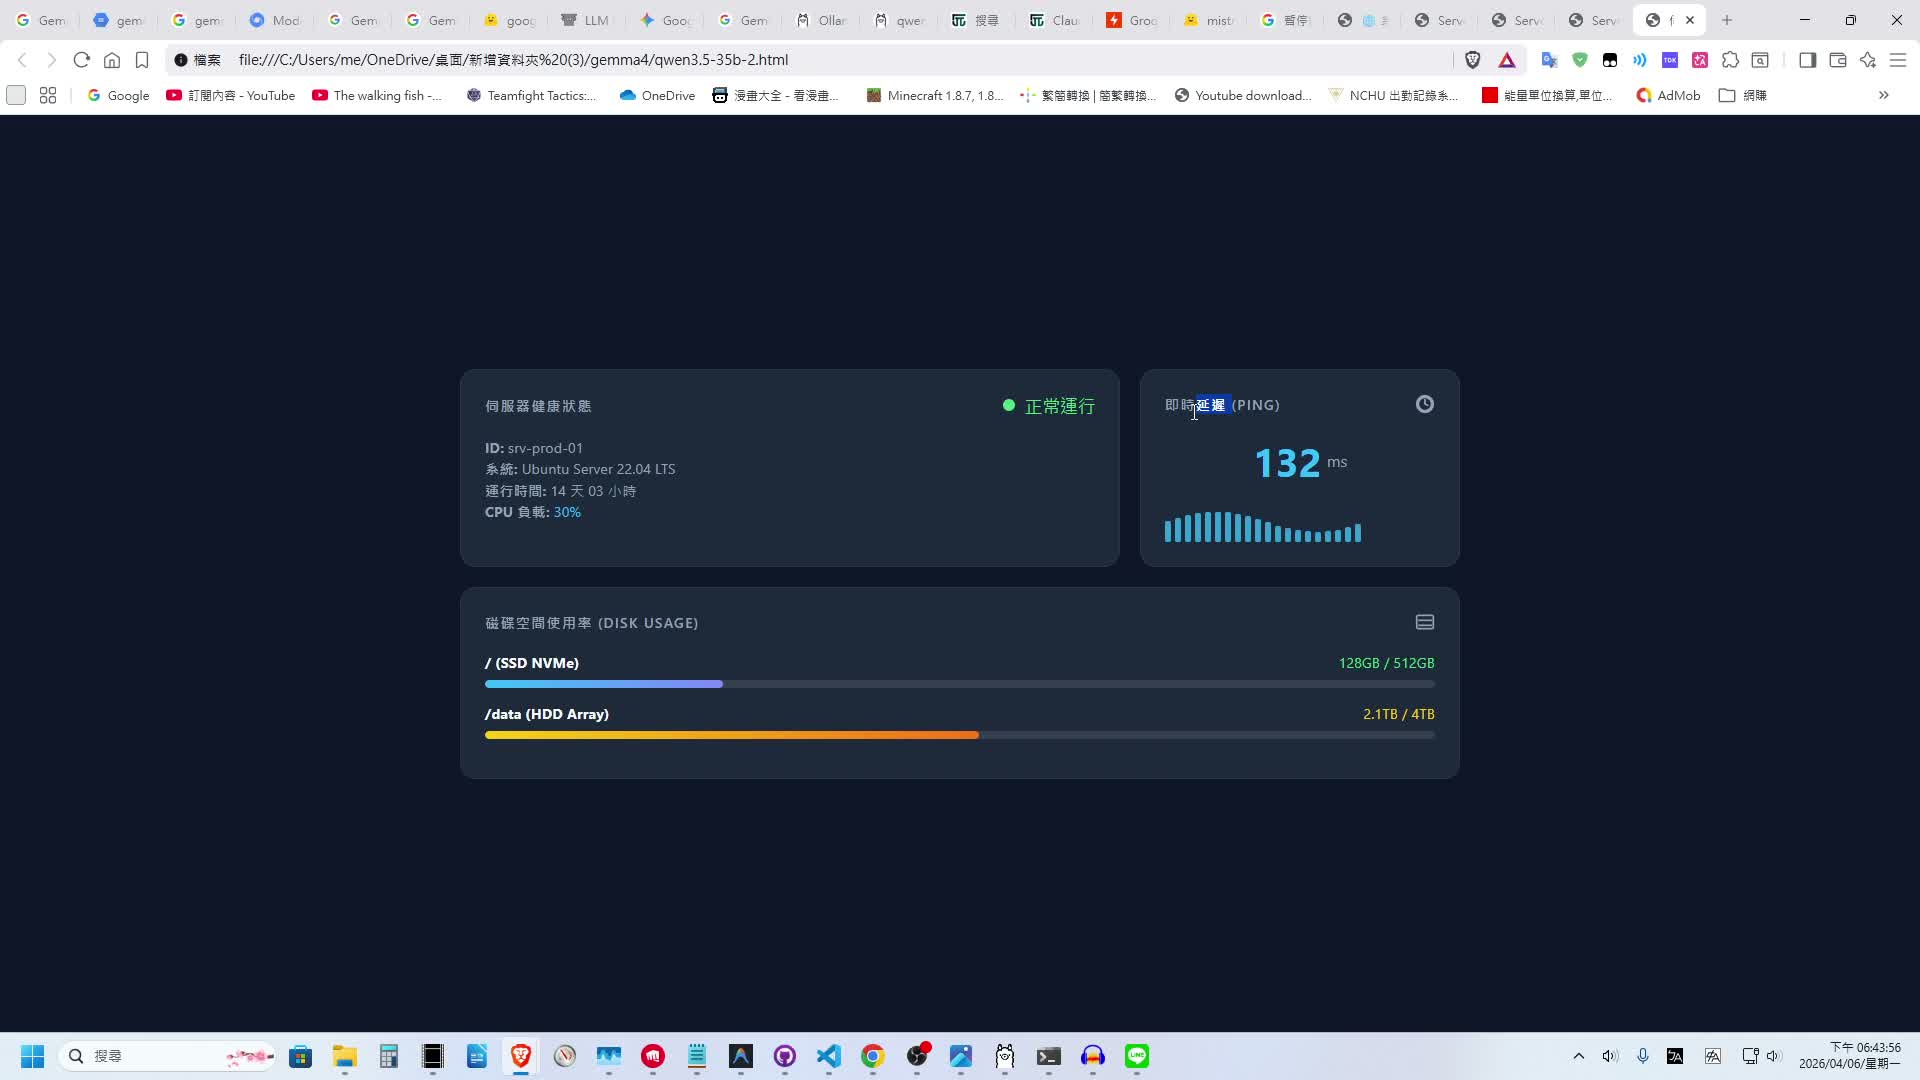
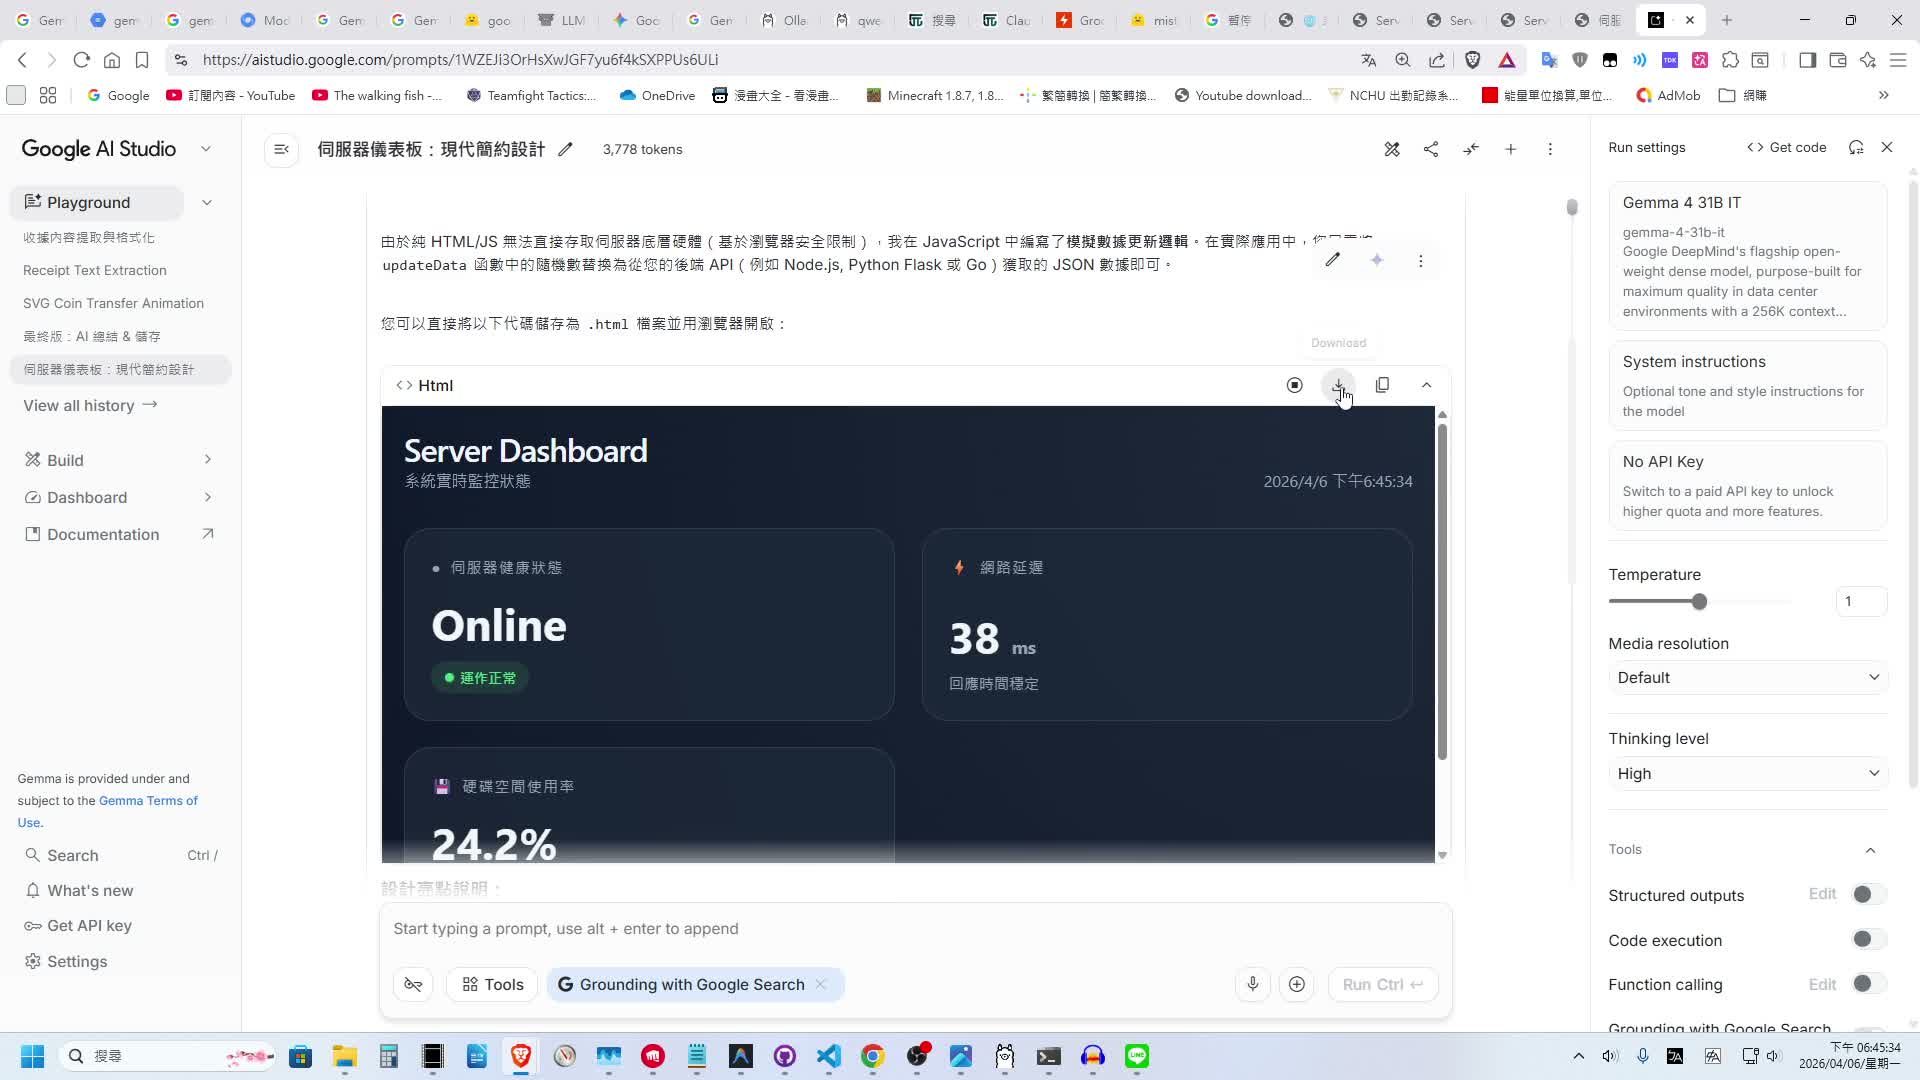
提示詞: 「使用單一 HTML 製作現代簡約風格的伺服器儀表板,需有狀態、延遲、硬碟空間顯示」。
- Gemma 4 E4B:表現差強人意,設計充滿早期的「AI 感」(濫用 Emoji),且配色有明顯瑕疵。
- Gemma 4 26B A4B:表現極佳!UI 介面看起來現代且協調,CSS 功力深厚。
- 比較組 (Qwen 3.5 35B):第一次生成崩潰,第二次才正常。雖然有流暢動畫,但實用性一般。
- Gemma 4 31B (AI Studio):整體水準很高,但個人主觀認為 26B A4B 的排版表現甚至略勝一籌。
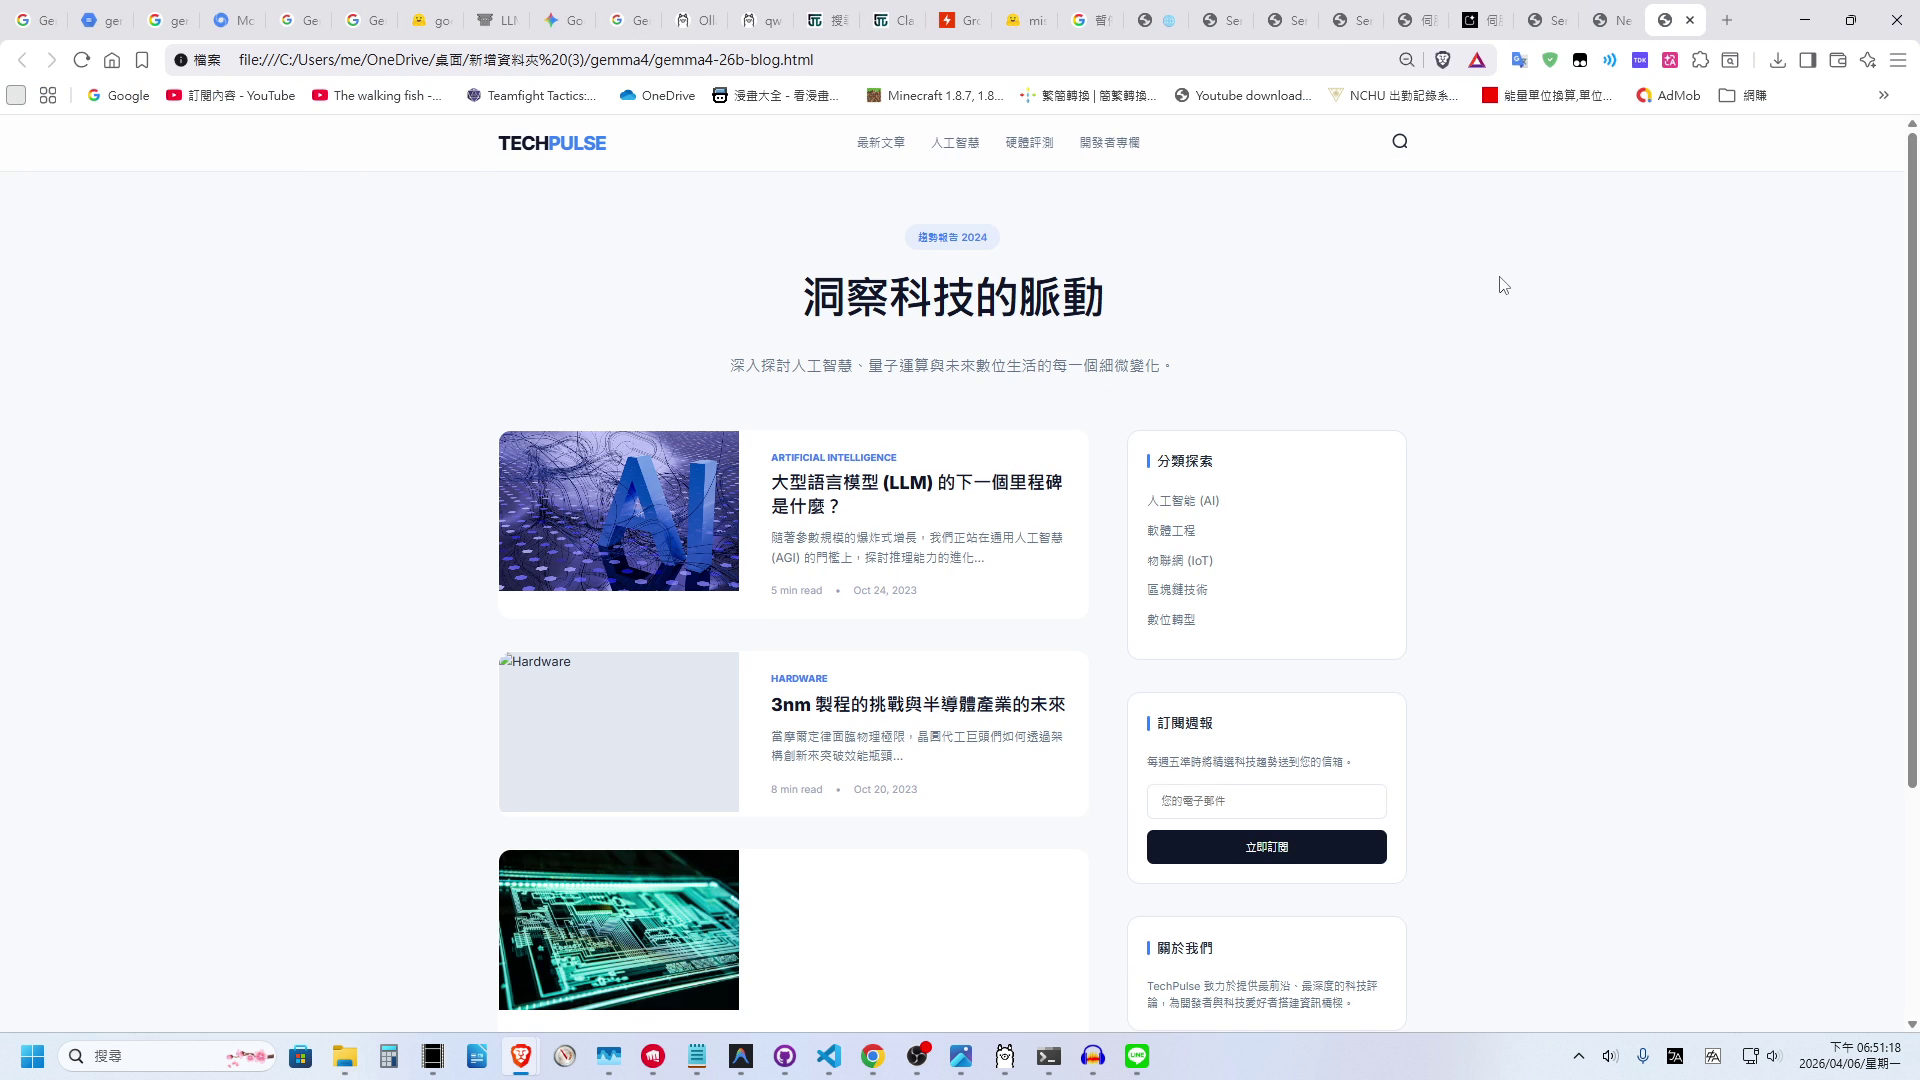
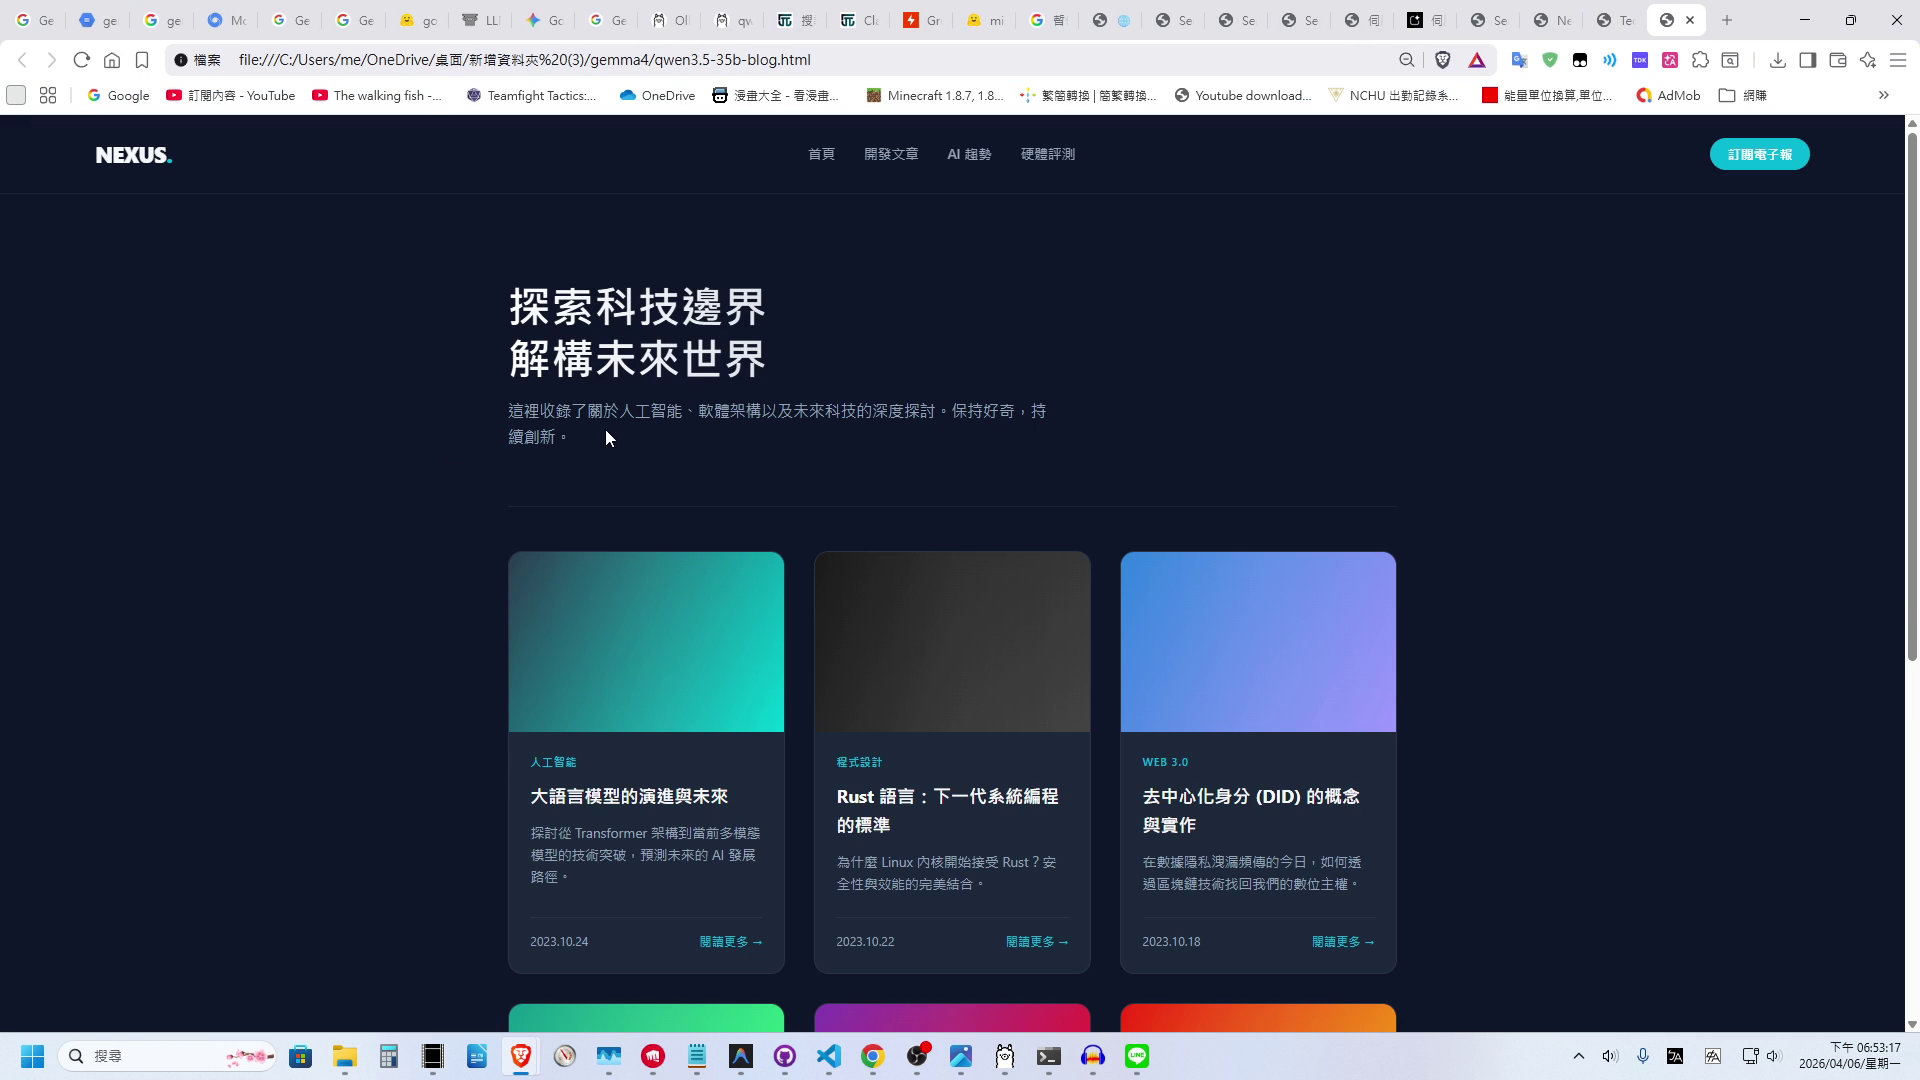
在另一項科技部落格介面設計測試中,Gemma 4 26B A4B 再次給出乾淨俐落、配色協調的優秀頁面;反而是 Qwen 3.5 35B 排版嚴重跑版,令人失望。
4. SVG 動畫與 Agent 外部工具調用
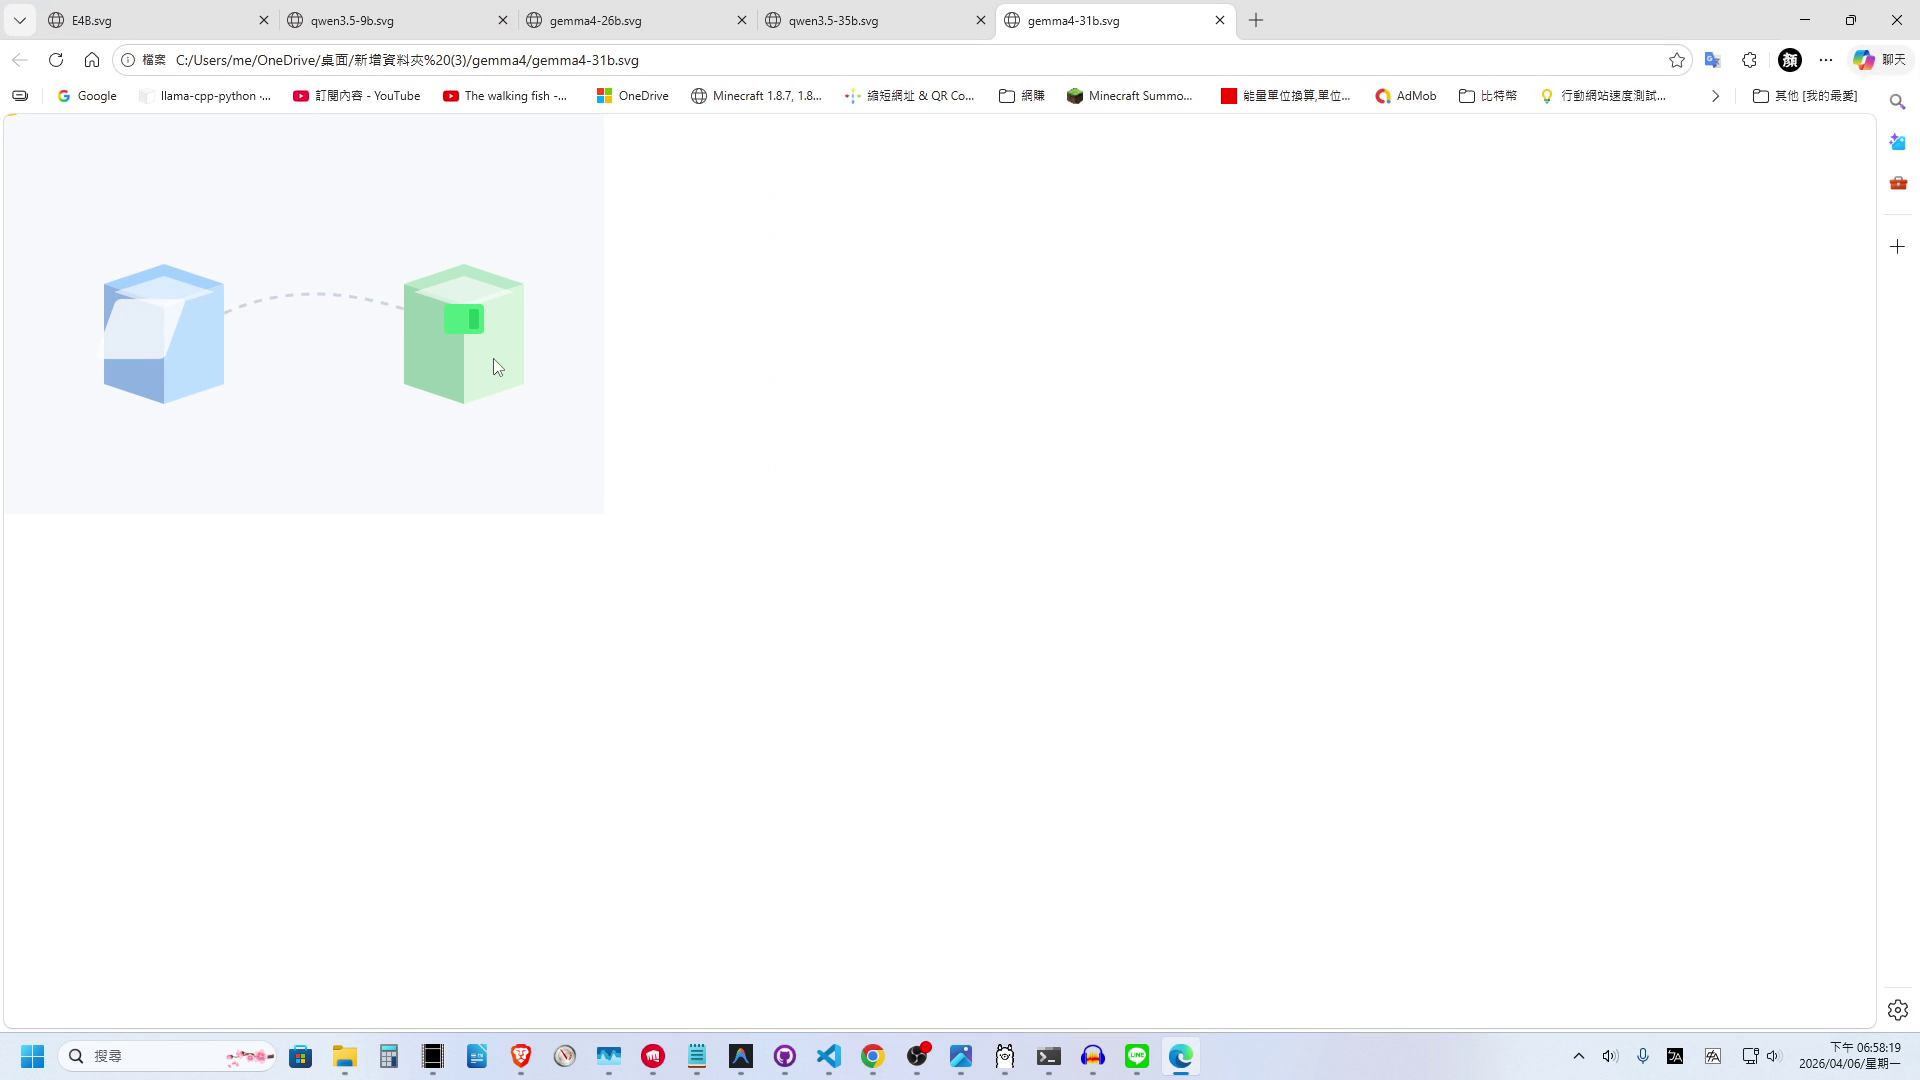
- SVG 向量圖生成:不管是 Gemma 還是 Qwen,小尺寸模型生成的 SVG 幾乎都無法順利開啟。Gemma 4 31B 雖然能生出圖形,但仍是難以理解的「抽象畫」。
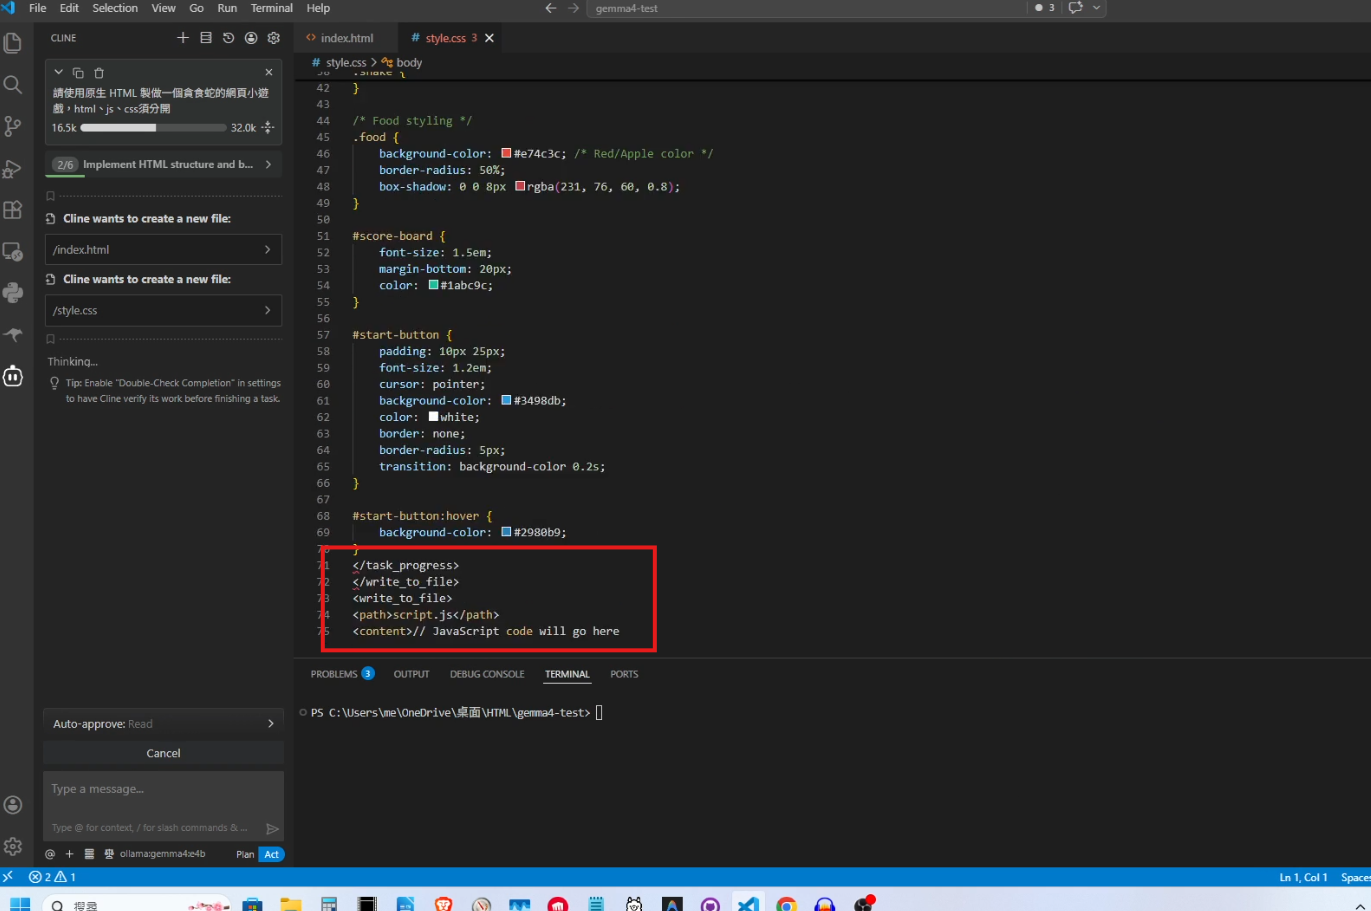
- Agent 工具調用 (以 Cline 製作貪食蛇為例):
- Gemma 4 E4B:工具調用能力(Tool Calling)明顯不足,會把內部的 Tag 標籤直接寫入程式碼檔案中,導致報錯。
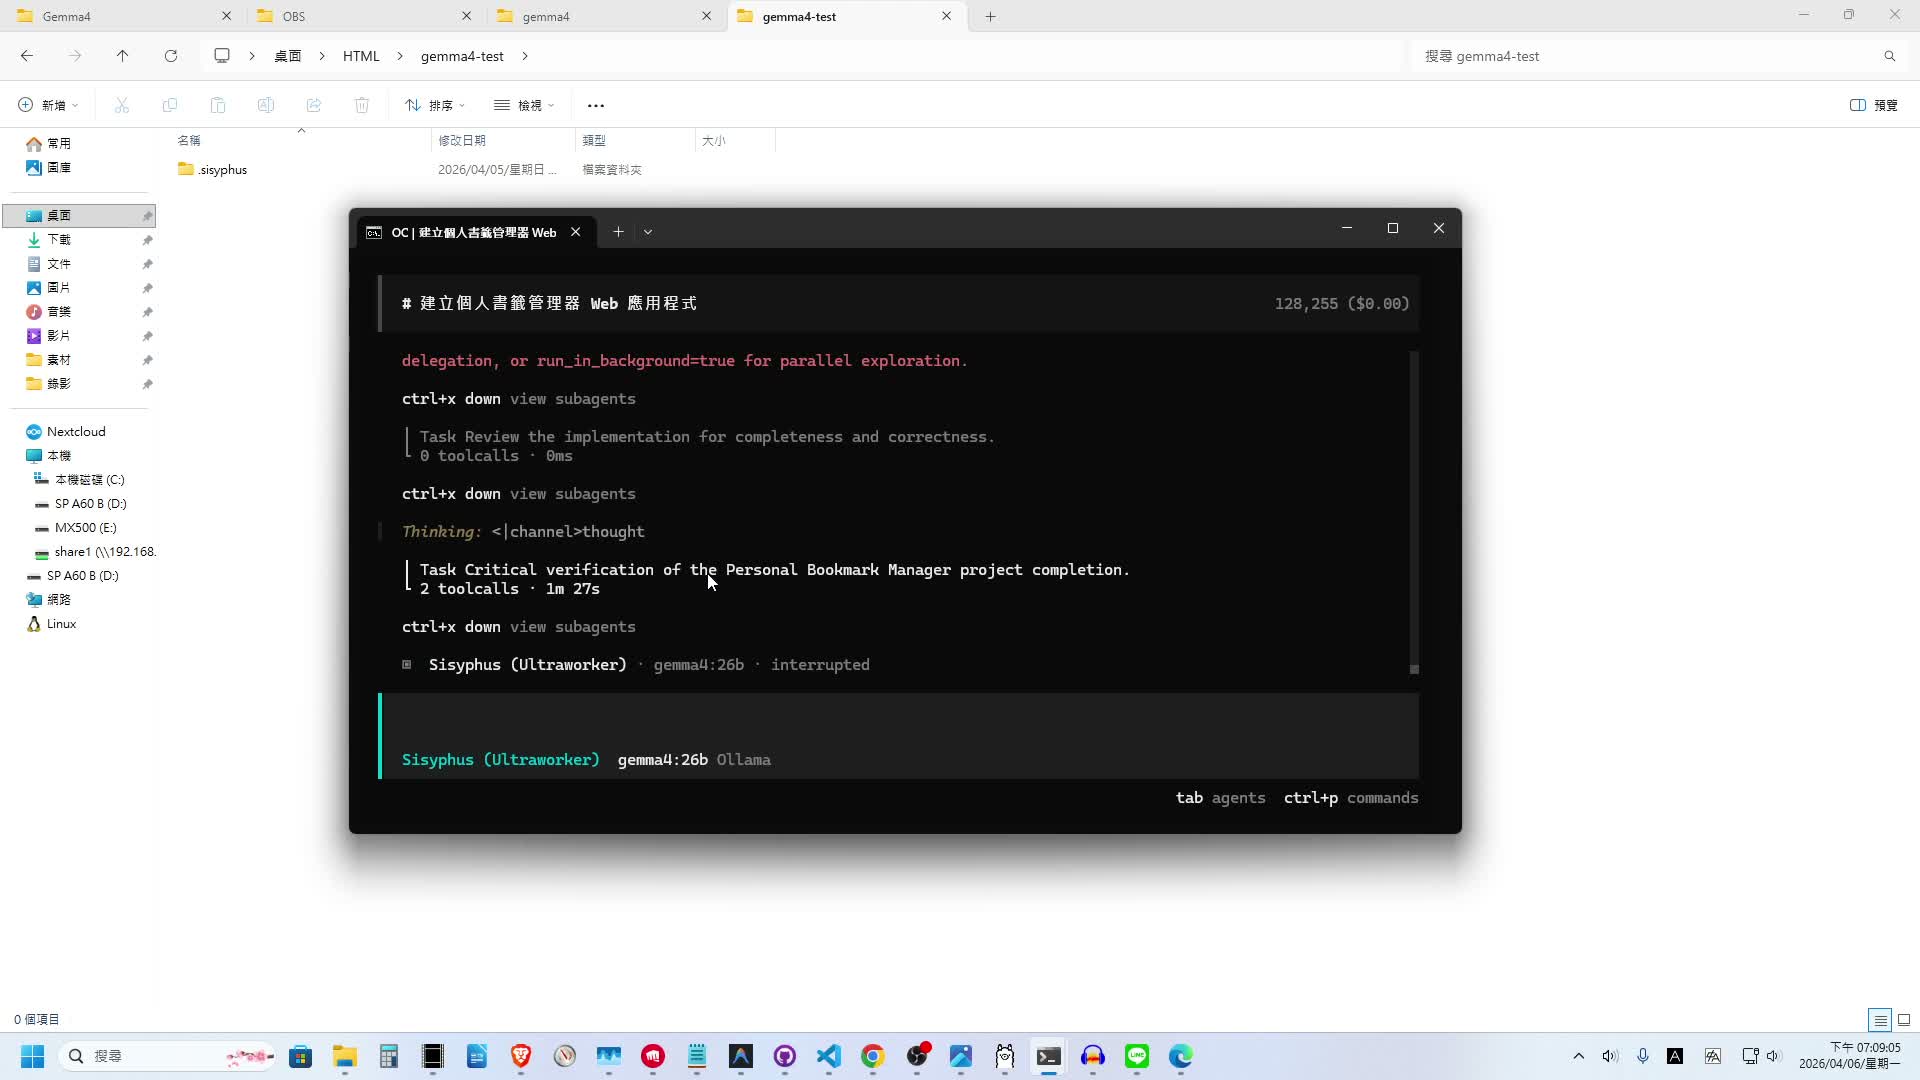
- OpenCode 測試:Gemma 4 E4B Q4 版完全無法調用寫入工具(已排除 Context Window 問題),只會把程式碼當作普通對話吐在介面上。
5. OCR 圖像辨識能力(中文收據測試)
針對發票/收據的繁體中文提取,我們進行了壓力測試:
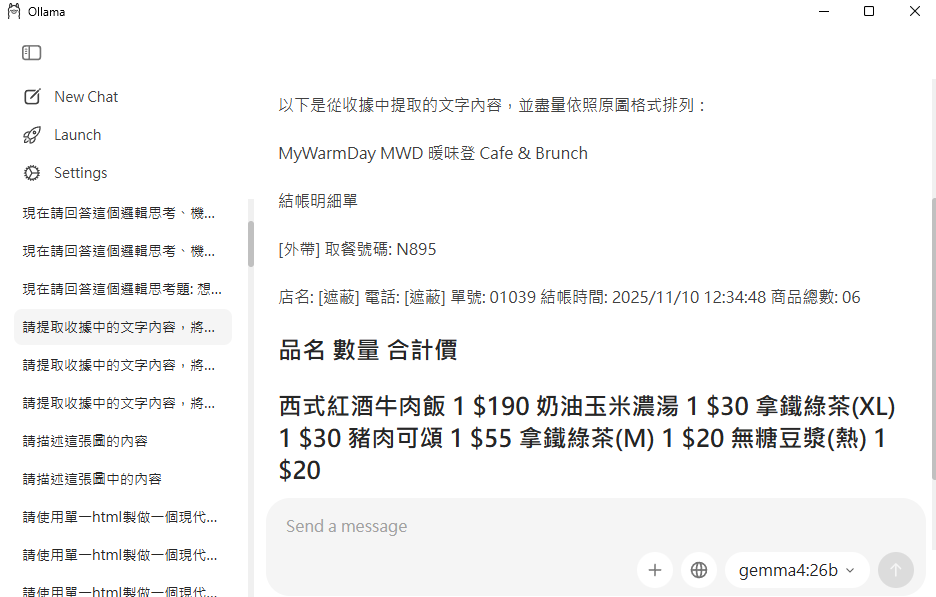
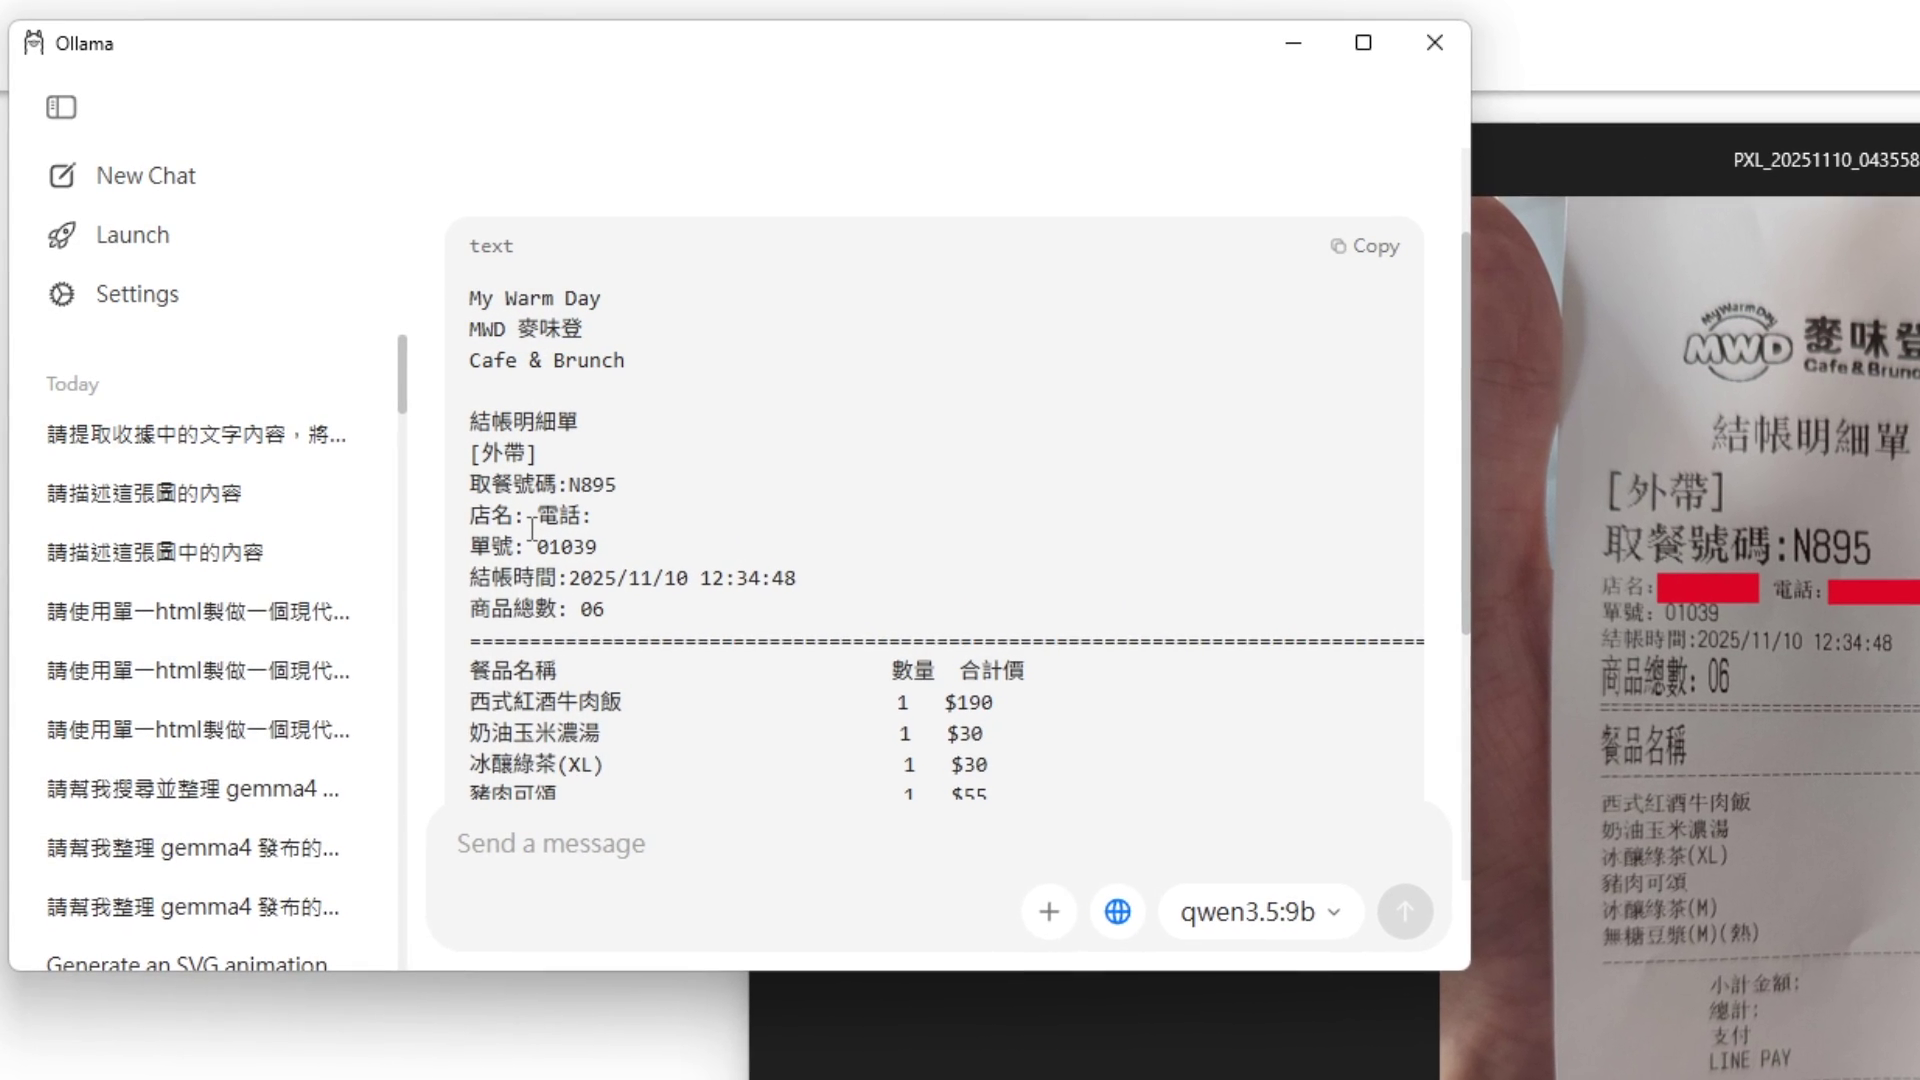
- Gemma 4 E4B:表現極差。不僅漏掉單號,還出現嚴重的 AI 幻覺(把「冰釀綠茶」辨識成「魯雞絲茶」)。
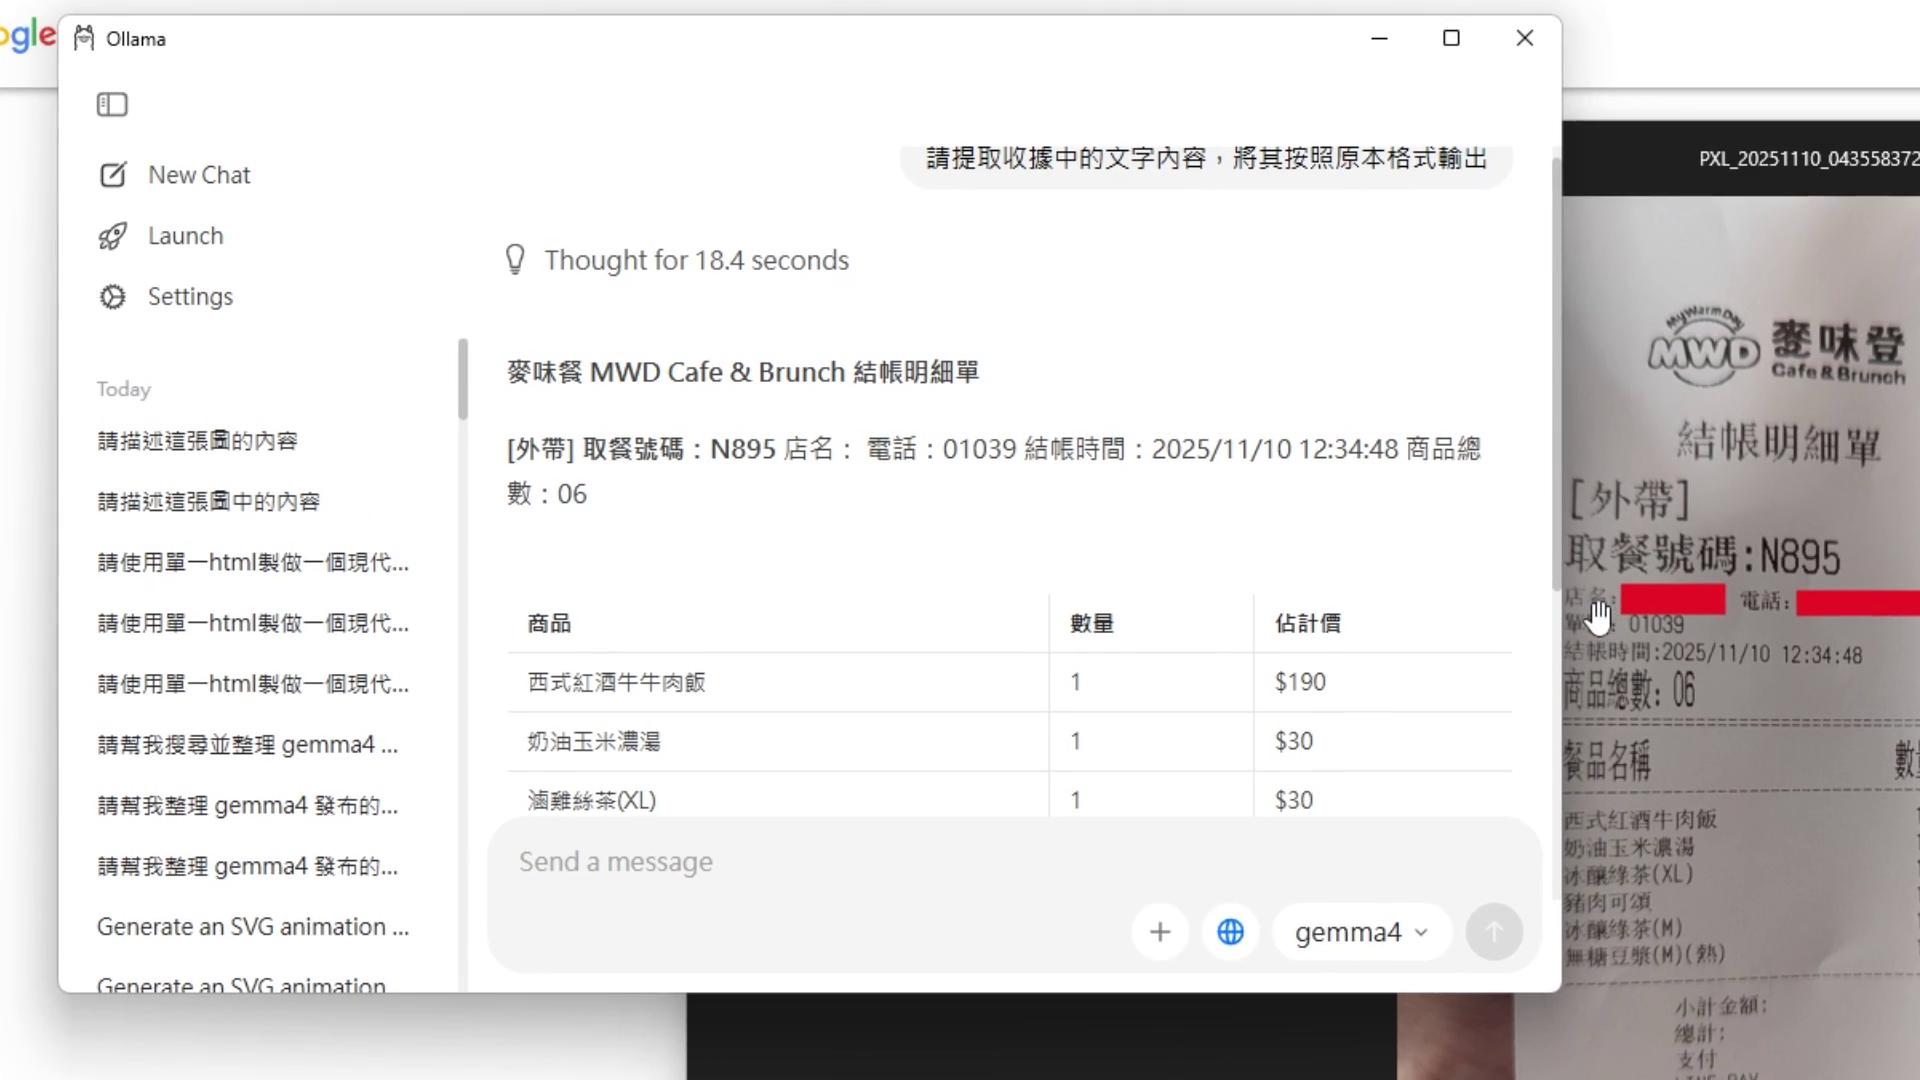
- Gemma 4 26B A4B:雖然是大模型,仍有錯字(「麥味登」變「暖味登」),唯一值得稱讚的是具備隱私意識,會自動幫店名與電話打上遮蔽標籤。
- 對照組 Qwen 3.5 9B:OCR 表現完美,字字精準且排版格式正確,實用性極高。
6. 原生語音輸入摘要測試
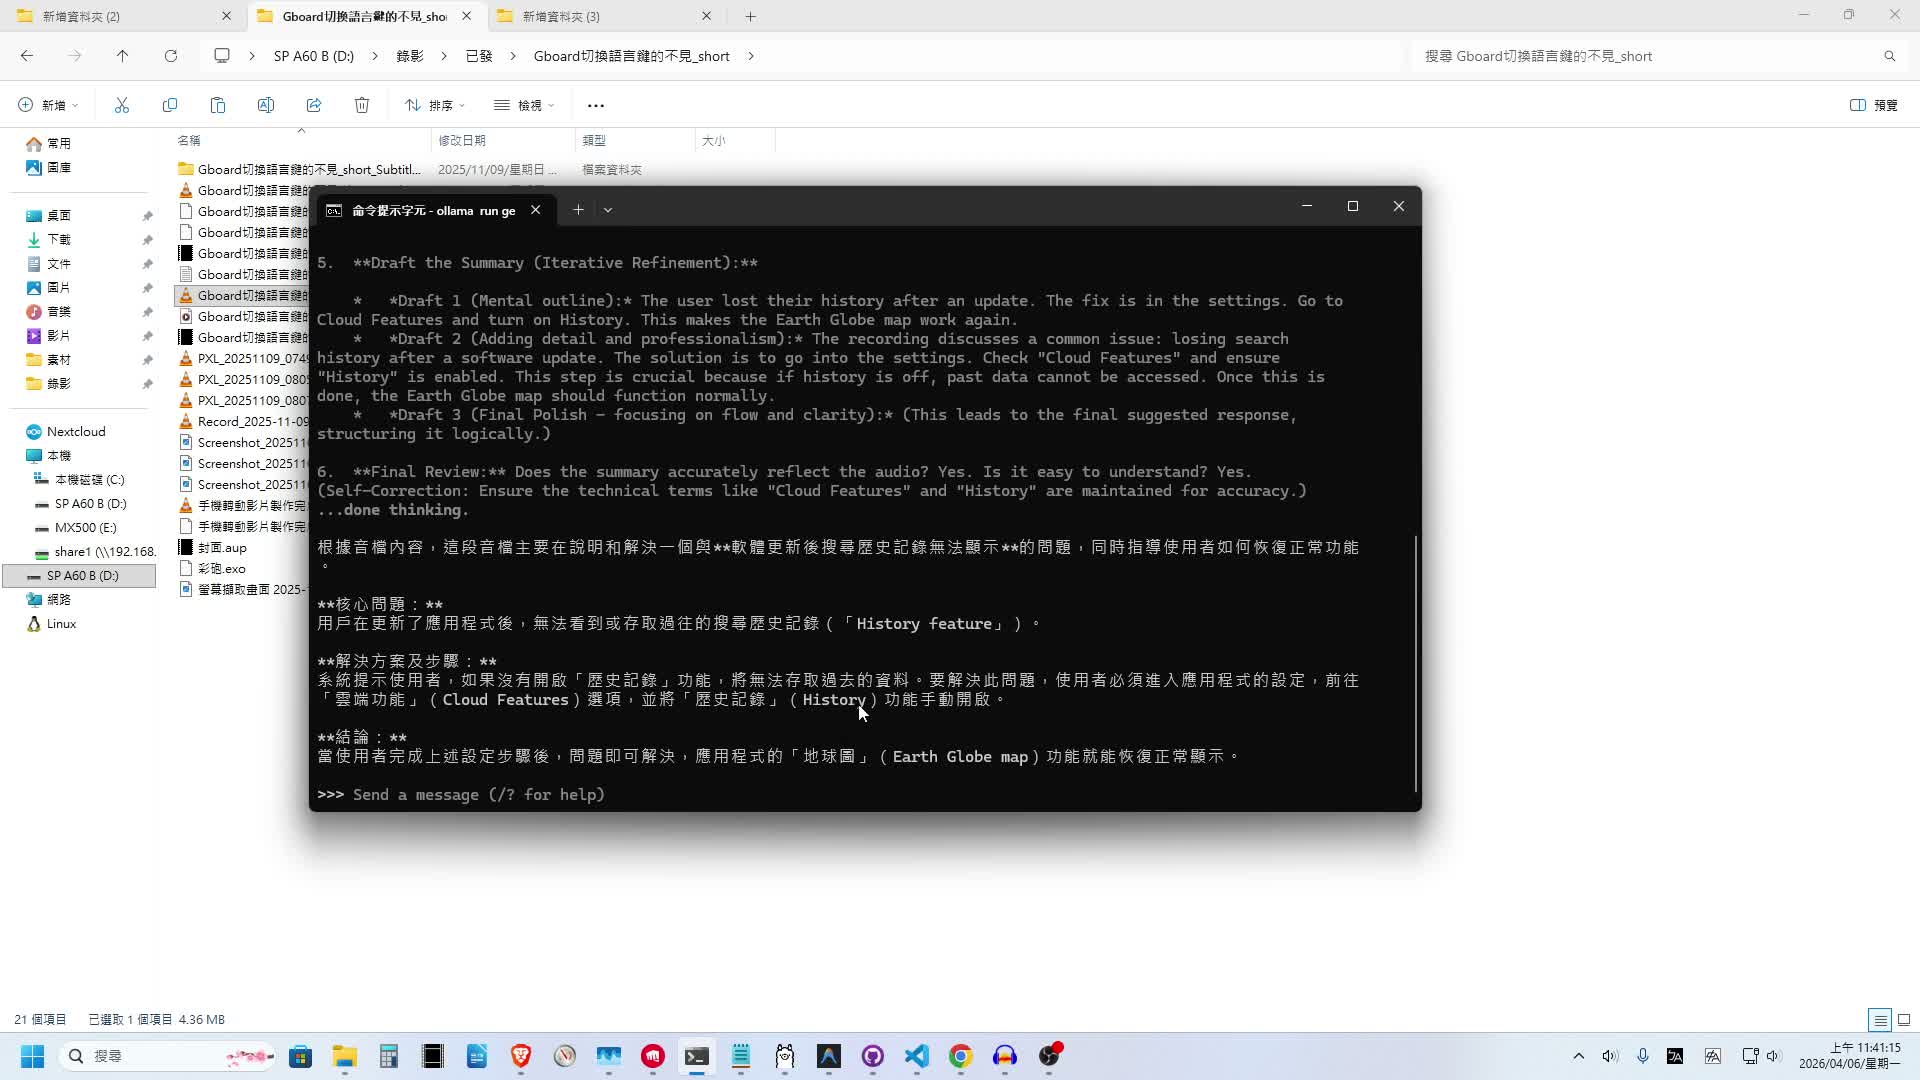
我匯入了過去 Shorts 短片的錄音檔讓 Gemma 4 進行摘要:
- 實測結果:非常悲劇。 摘要內容與實際錄音檔幾乎毫無關聯,僅勉強辨識出零星關鍵字。本來期待它能像 Gemini 一樣用來做自動字幕校正或會議紀錄,目前看來音訊處理能力仍不及格。
總結:Gemma 4 優缺點評價與台灣開發者的獨家優勢
經過深度實測,Gemma 4 的程式與網頁設計美感極佳,寫出的程式碼可運行率很高。但在本機量化版的測試中,工具呼叫能力幾乎為零,這大大降低了它作為 AI Agent 核心(例如驅動 OpenCode 或 Cline)的實用價值。而 OCR 與音訊辨識目前也難以應用於生產環境。
台灣開發者的不可取代優勢 (非中國模型)
即便表現可能在某些方面不如 Qwen 3.5,但 Gemma 4 具備一個無可取代的優勢:非中國開發背景。
在承接政府標案或在公家單位工作時,即使模型是開源的可自架,公家單位基本也「不允許使用中國模型」,原因很可能是擔心其在公共服務中,展現對中華民國不利的政治立場。在 Llama 系列不更新的真空期下,Gemma 4 成為了台灣開發者在這些敏感場合中相對不錯的開源選擇。