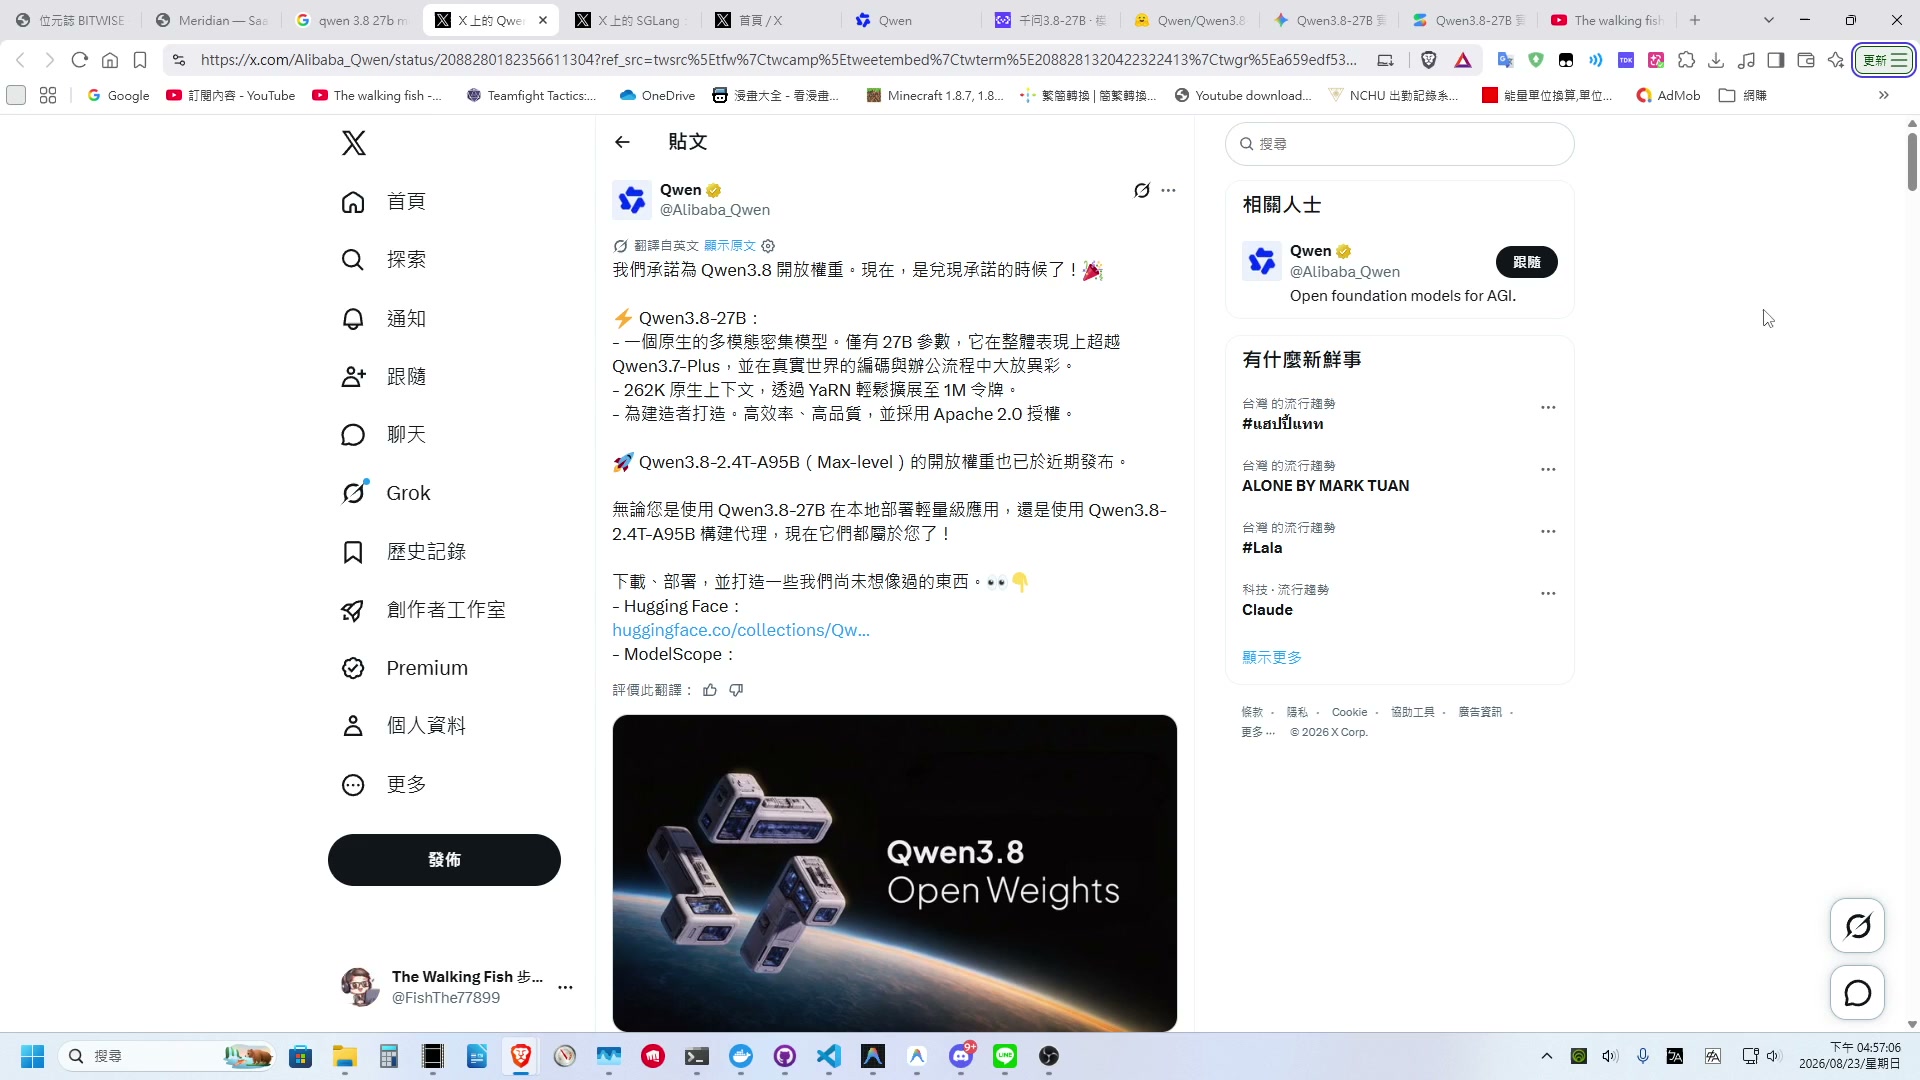
這幾天開源 AI 社群最熱鬧的大事,莫過於阿里巴巴通義千問團隊正式開放了 Qwen 3.8-27B 的模型權重。
在發布前夕,社群上(包括我自己)其實都在盯著 HF 上的倒數。上一代 Qwen 3.6 雖然在中文推理與日常對答上表現不俗,但在碰上真實軟體專案的重構、多檔案依賴排查,或是複雜的 Agent 自主決策時,終究還是離頂級閉源旗艦有一段肉眼可見的差距。
沒想到這次 Qwen 3.8 的更新,官方在跑分表上表示其能力堪比 Claude Opus 4.6,甚至在好幾項長程程式碼修復指標上硬生生超了過去,j雖然 Opus 4.6 已不是當今最新的旗艦模型,但其能力一就有著一定的標誌性,且意義非同小可。
今天,我們就結合官方在 Hugging Face Model Card 揭露的第一手架構規格與跑分數據,並透過一連串實機考題,3D 幾何、Three.js 光影、Minecraft 遊戲引擎、單頁現代科技部落格、SaaS 儀表板,以及多模態繁中菜單轉錄,來驗證它究竟是真有硬實力,還是純粹的跑分行銷。

同時,我也會聊聊我如何把它直接接入日常的專案工作流,與使用她需要知道的一些缺點。
兩階段發布策略:為什麼大家都在等 27B,而不是 2.4T 的 Max?
阿里巴巴這次的發布策略分成兩天進行。
第一天打頭陣的是雲端巨獸 Qwen 3.8-Max。總參數量高達 2.4T,激活參數約 95B。雖然性能強大,但很顯然是針對企業級雲端 API 與資料中心叢集設計的,一般個人開發者就算手上有幾張頂級顯卡,也完全不可能在本地跑起來。
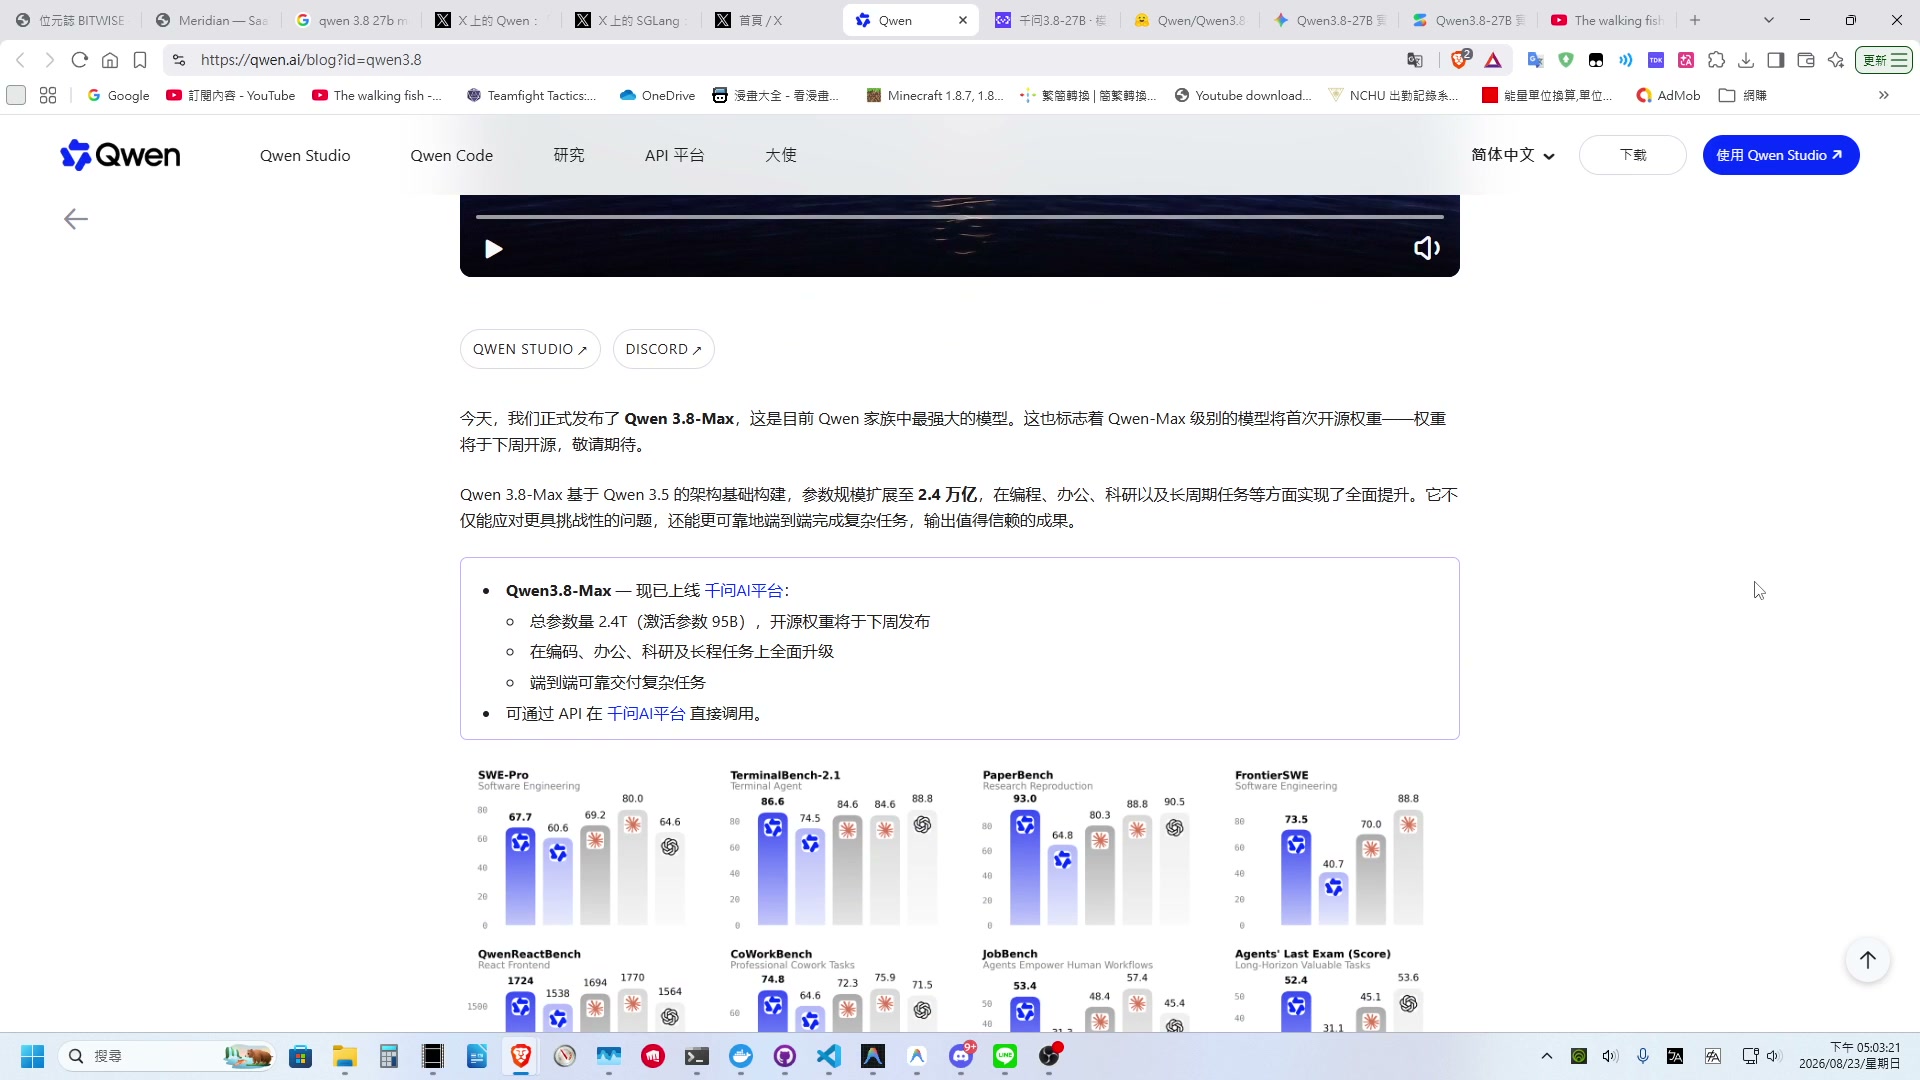
兩天後放出的,才是真正讓我們興奮的重頭戲——Qwen 3.8-27B。
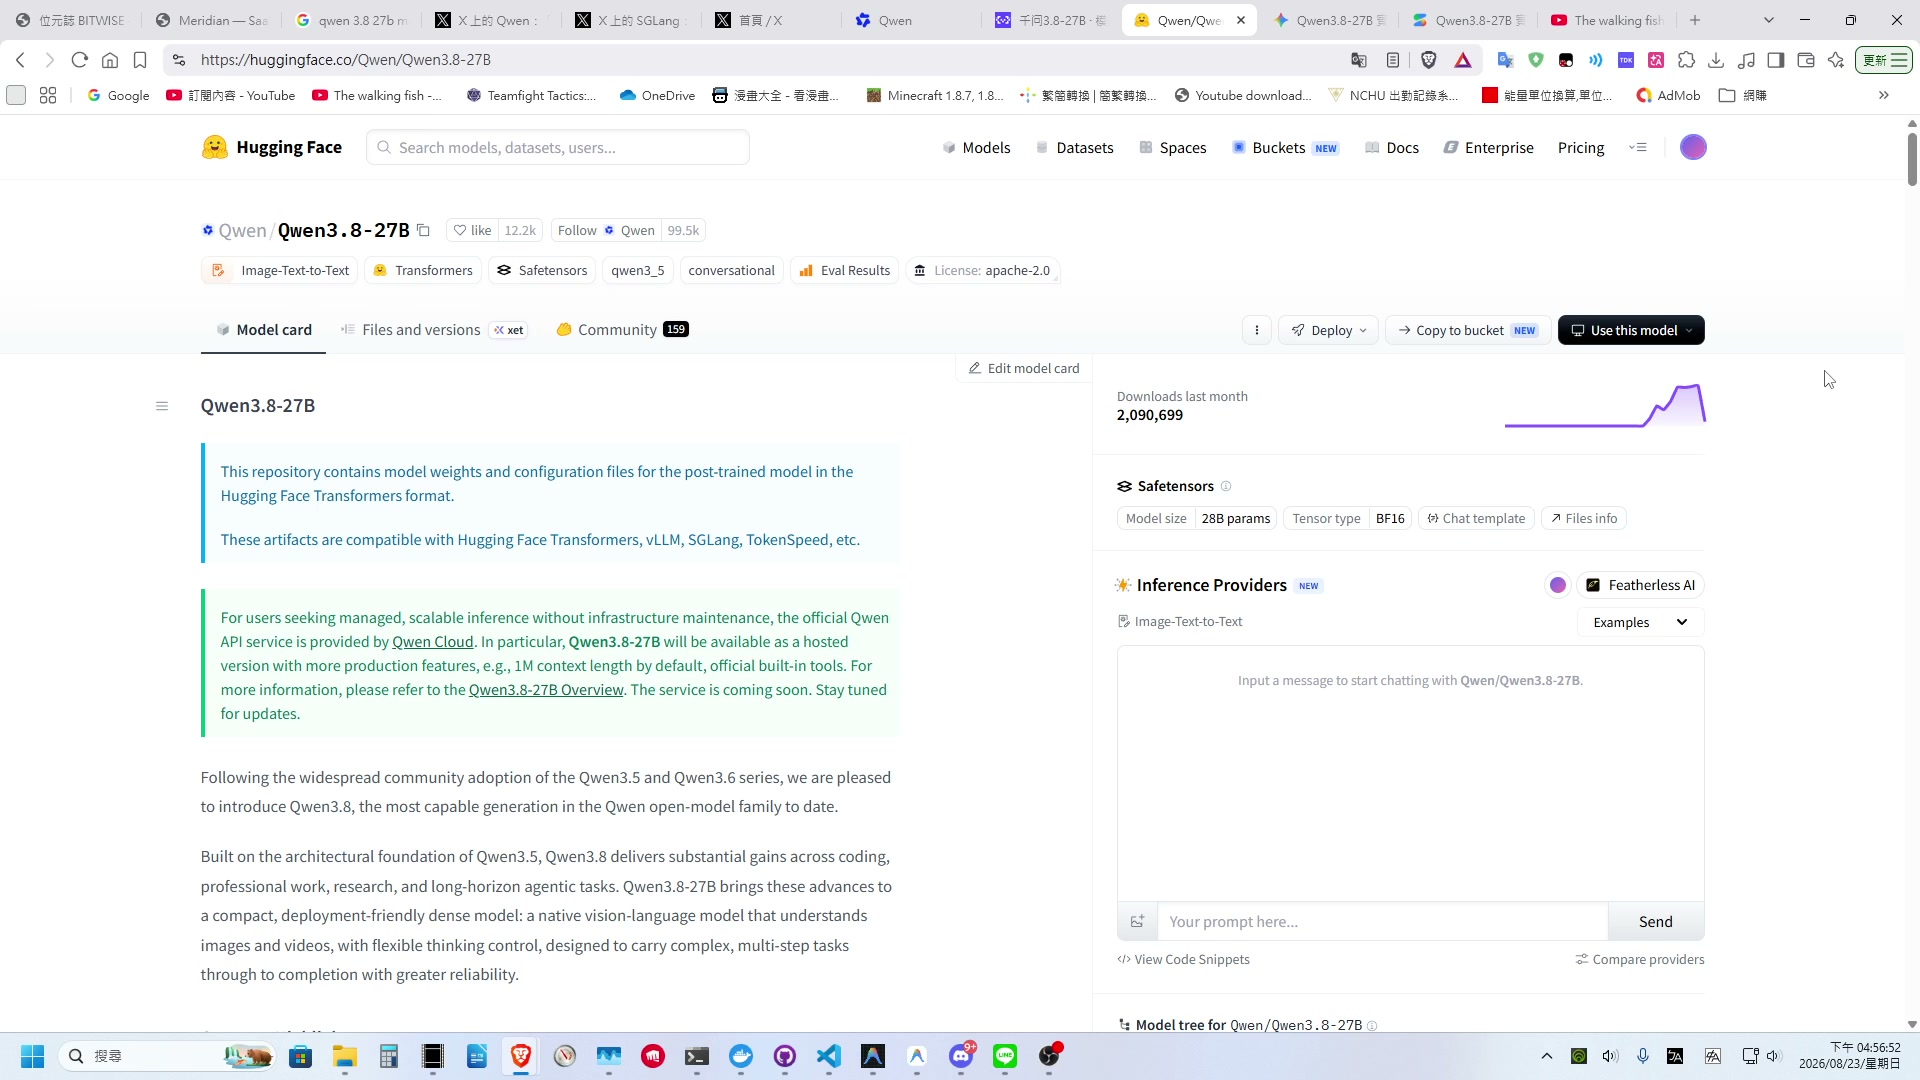
這是一個兼顧了單機部署可能性與極限推理能力的密集(Dense)多模態模型:
- 開源授權協議:採用完全商用友善的 Apache 2.0,意味著無論是個人研究還是整合進商業產品,都沒有授權陷阱。
- 上下文視窗:具備 262,144 Tokens(262K) 的原生上下文長度,透過 YaRN 技術甚至能無痛擴展到 1,000,000 Tokens(1M)。對習慣把整套代碼庫或整份 API 手冊整坨丟給 AI 檢索的開發者而言,這種長度基本解決了上下文截斷的焦慮。
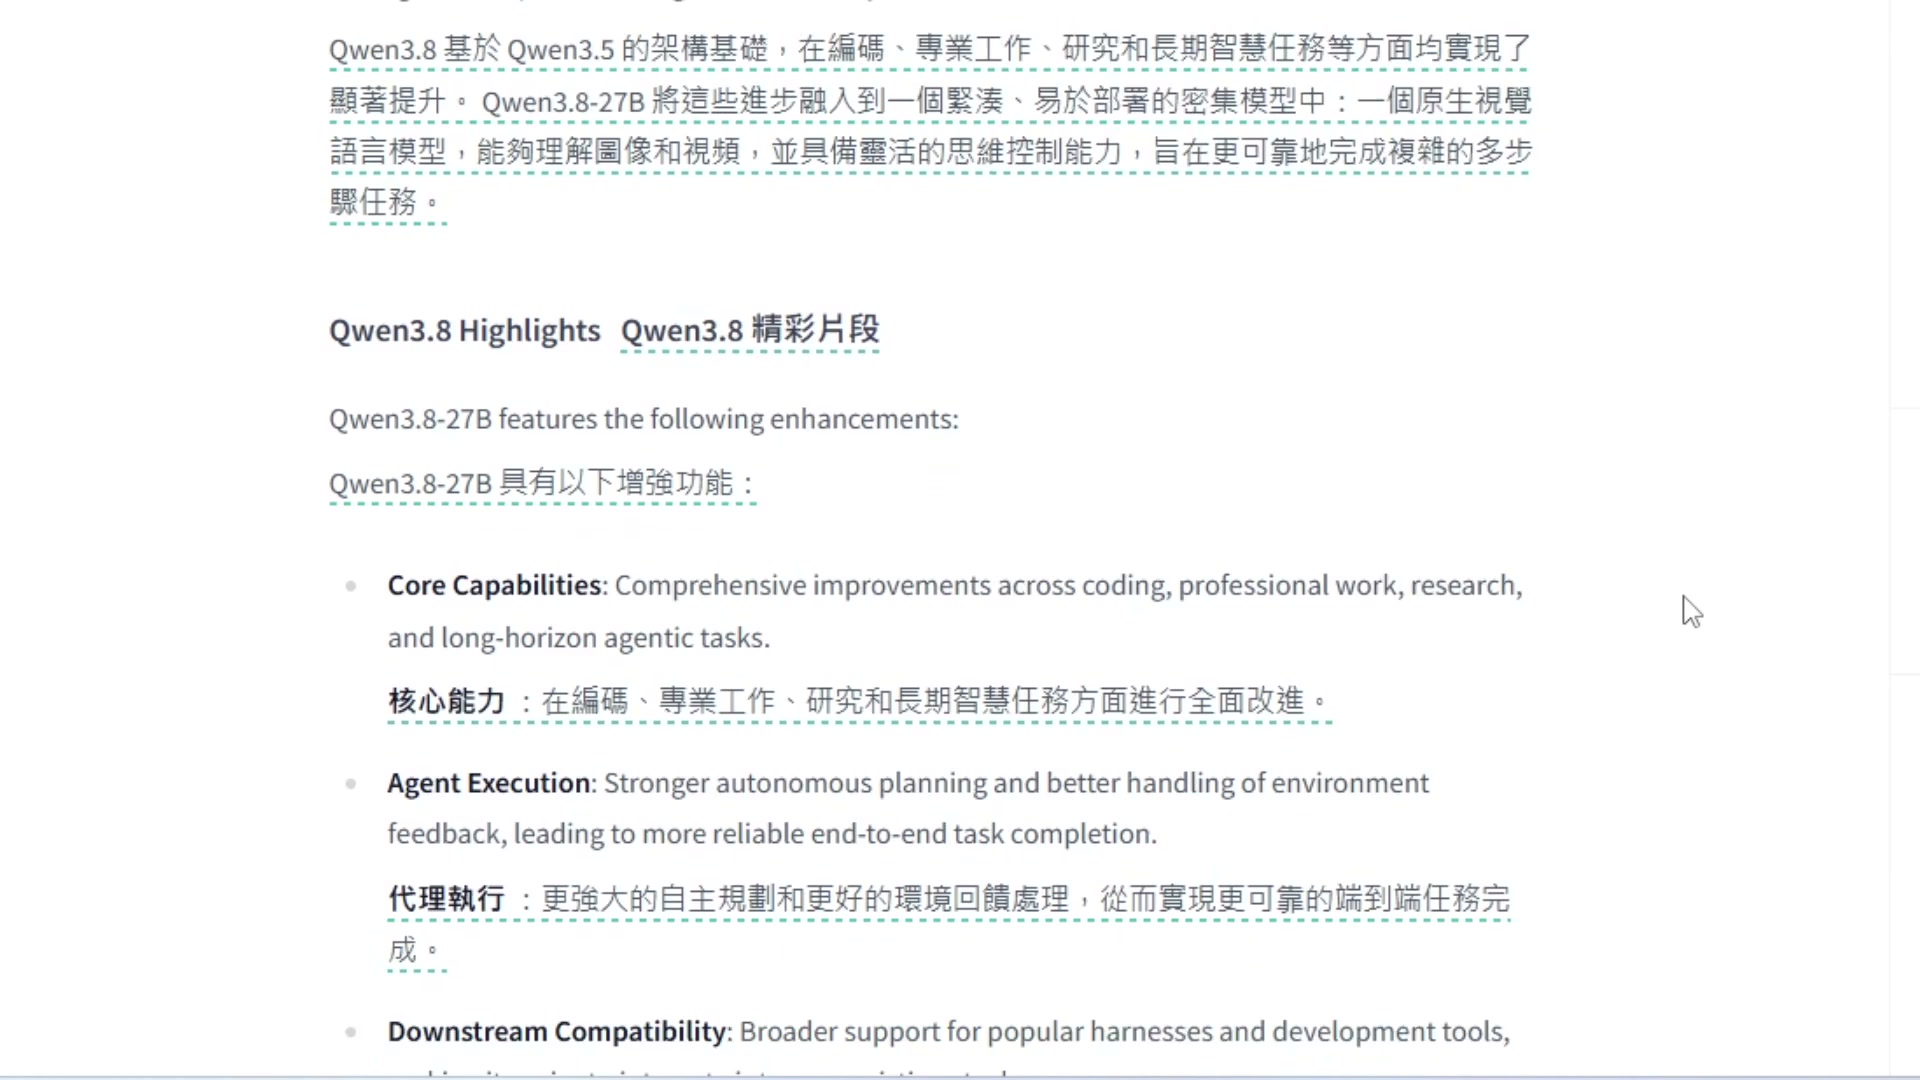
深入 Hugging Face 模型細節:這顆 27B 到底改了什麼?
很多人第一反應會納悶:同樣是 27B 的體量,在短短幾個月內,代碼與 Agent 能力怎麼可能突然出現質的飛躍?
翻開 Hugging Face 官方 Model Card 上的技術規格,可以發現 Qwen 3.8-27B 在模型架構上,與 Qwen 3.6-27B 一致,主要是透過後訓練與強化學習等方式,提升其在程式碼生成、邏輯推理與自主決策上的能力。
後訓練、強化學習與思考模式控制
除了結構創新,決定性關鍵還是在於後訓練(Post-training)與強化學習(RL)。官方這次極為聚焦,全力攻堅「複雜程式邏輯推理」與「長程 Agent 自主修正」兩大核心弱點。
在官方部署建議中,模型原生啟用思維鏈模式(Thinking Mode),輸出時會自帶 <think>...</think> 標籤,並提供了彈性的控制參數:
- 推論深度控制 (
reasoning_effort):xhigh(預設):針對高難度程式重構與邏輯難題,展開深度推演。medium/low:在日常對答中平衡吐字速度與算力消耗。
- 思考上下文繼承 (
preserve_thinking):預設開啟,確保多輪對話時,歷史思考步驟不會被截斷。 - 官方建議取樣參數:
- 思考模式:
temperature=1.0,top_p=0.95,top_k=20,repetition_penalty=1.0 - 非思考模式(Instruct):
temperature=0.7,top_p=0.80,top_k=20,presence_penalty=1.5
- 思考模式:
值得玩味的是,官方特別在 Model Card 中給出了一條給開發者的中肯提醒:在多輪 Agent 任務中,刻意將 reasoning_effort 調低其實不一定能縮短任務總耗時。因為思考深度不足容易導致模型產生錯誤推理,引發後續連鎖重試,反而吃掉更多 Token 與等待時間。
官方跑分數據剖析:27B 真的追平 Claude Opus 4.6 了嗎?
在拉出來實測之前,我們先看看官方在 Hugging Face 上公布的基準評測資料。這份成績單剛出來時,社群普遍以為是誇大宣傳,但細看各項評測基準的測試環境與對照組,會發現內容相當嚴謹。
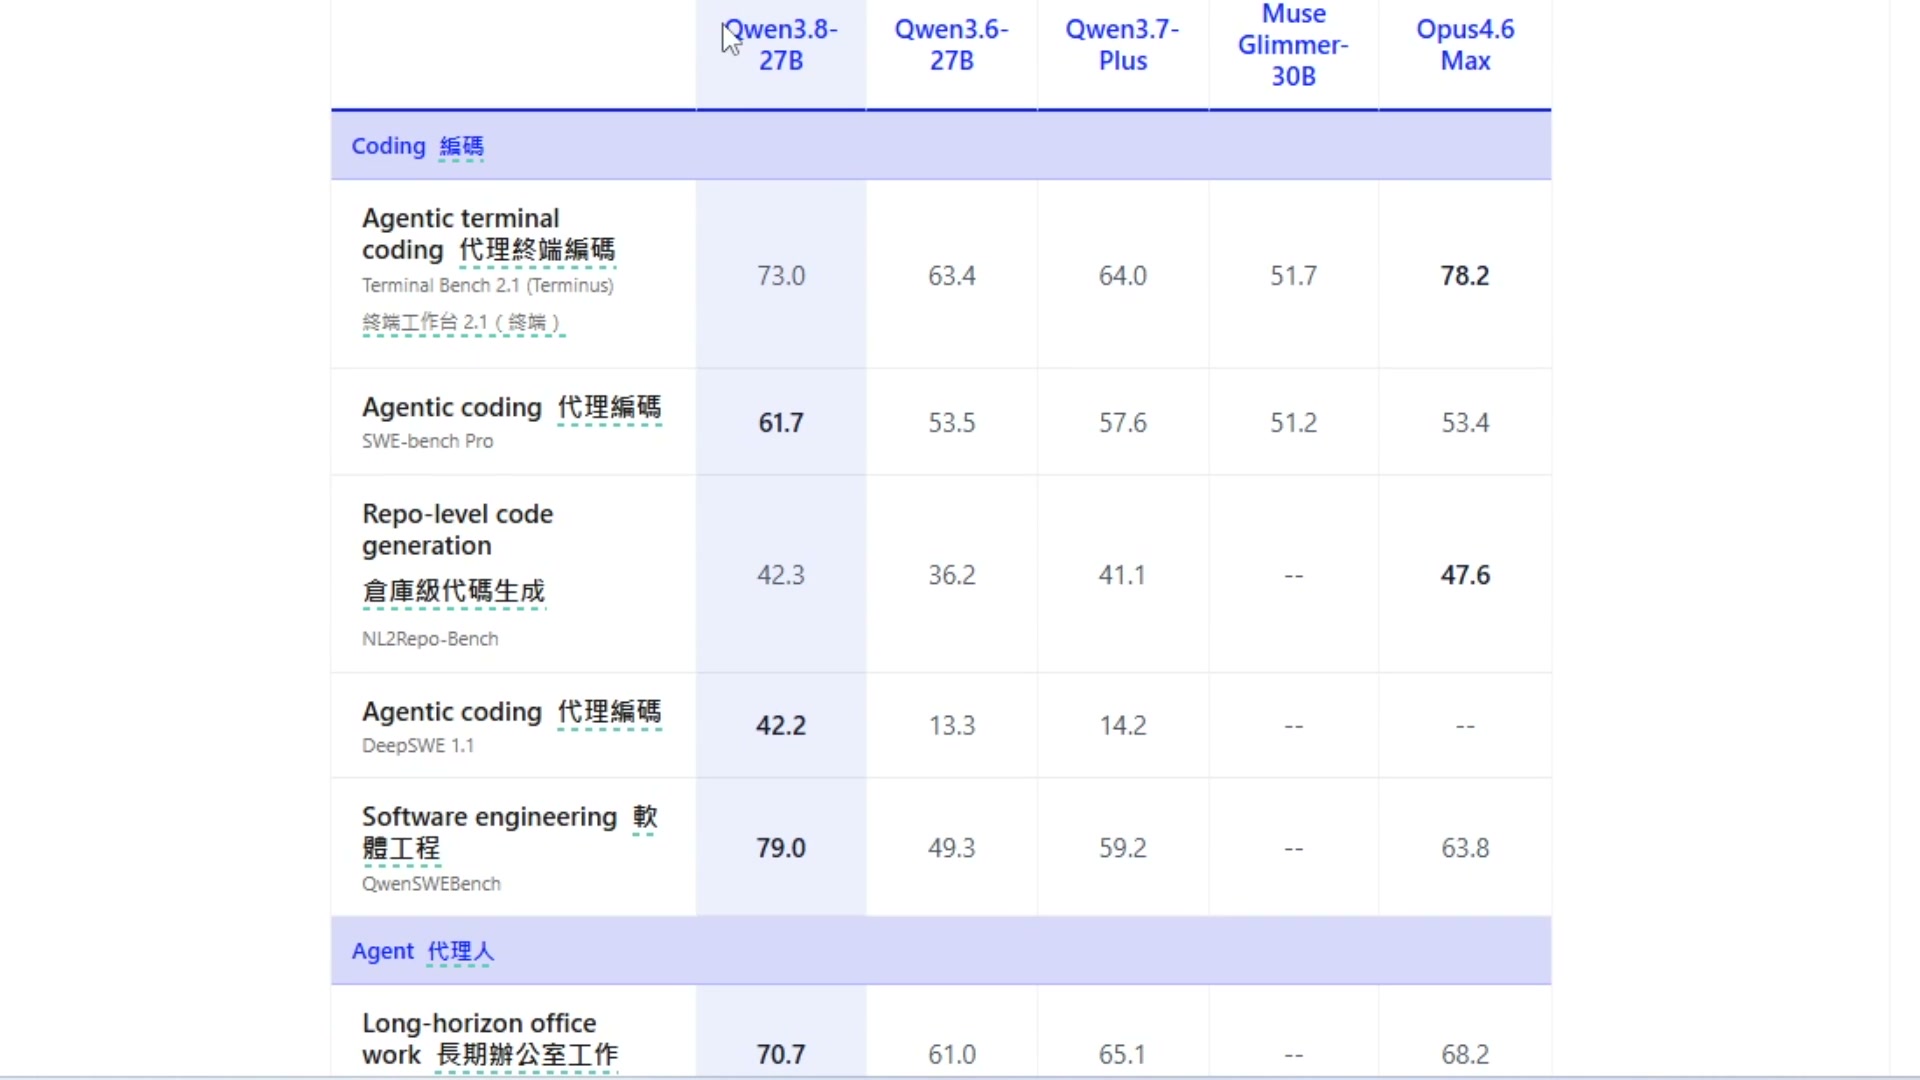
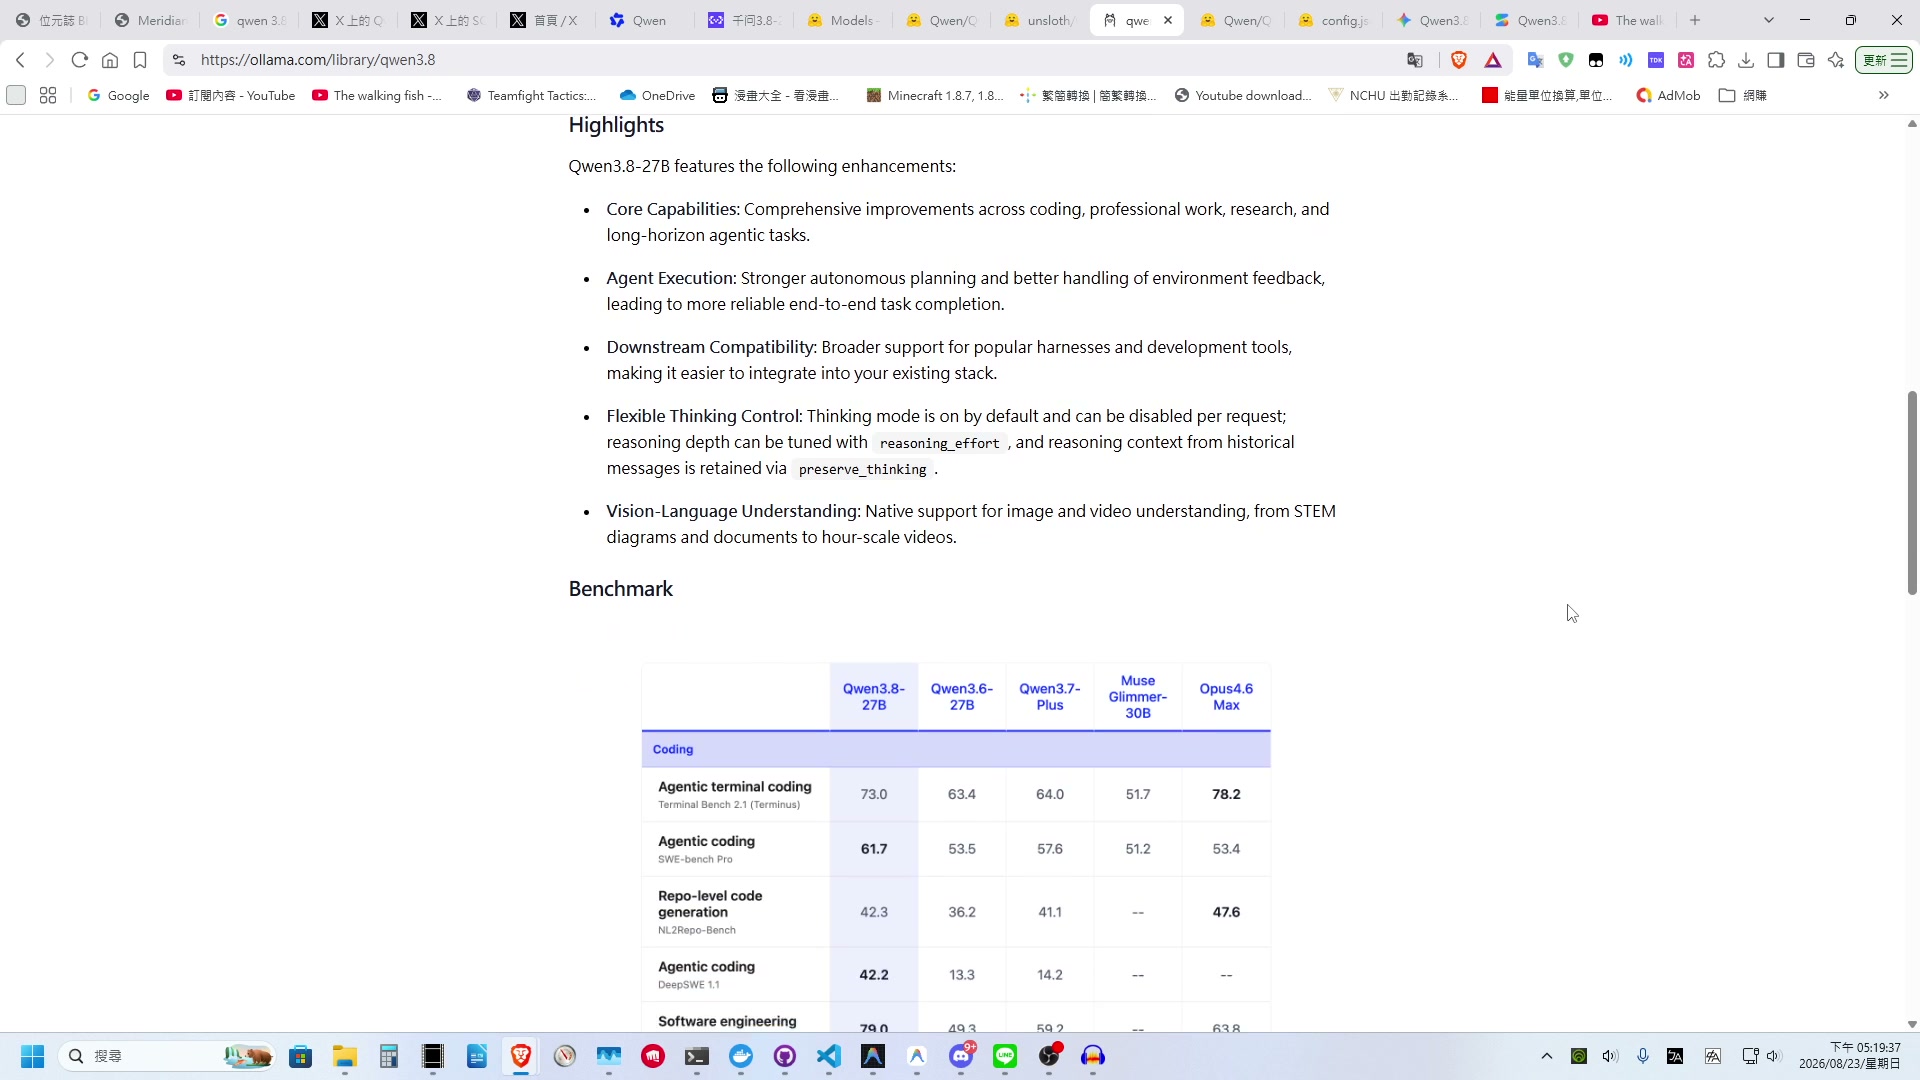
編碼、長程任務與 Agent 基準評測對照表
所有測試均基於官方統一標準(大部分採用 Claude Code 測試架構、256K 上下文、temp=1.0, top_p=0.95):
| 評測能力 / 資料集 | Qwen 3.8-27B | Qwen 3.6-27B | Qwen 3.7-Plus | Muse Glimmer-30B | Claude Opus 4.6 Max |
|---|---|---|---|---|---|
| SWE-bench Pro (實際專案代碼修復) | 61.7 | 53.5 | 57.6 | 51.2 | 53.4 |
| QwenSWEBench (企業級軟體工程) | 79.0 | 49.3 | 59.2 | – | 63.8 |
| LiveCodeBench v6 (競技程式設計) | 90.3 | 83.9 | 89.6 | – | 88.8 |
| Terminal Bench 2.1 (終端代理編程) | 73.0 | 63.4 | 64.0 | 51.7 | 78.2 |
| NL2Repo-Bench (倉庫級代碼生成) | 42.3 | 36.2 | 41.1 | – | 47.6 |
| DeepSWE 1.1 (深度代碼修復) | 42.2 | 13.3 | 14.2 | – | – |
| CoWorkBench (長程辦公協同) | 70.7 | 61.0 | 65.1 | – | 68.2 |
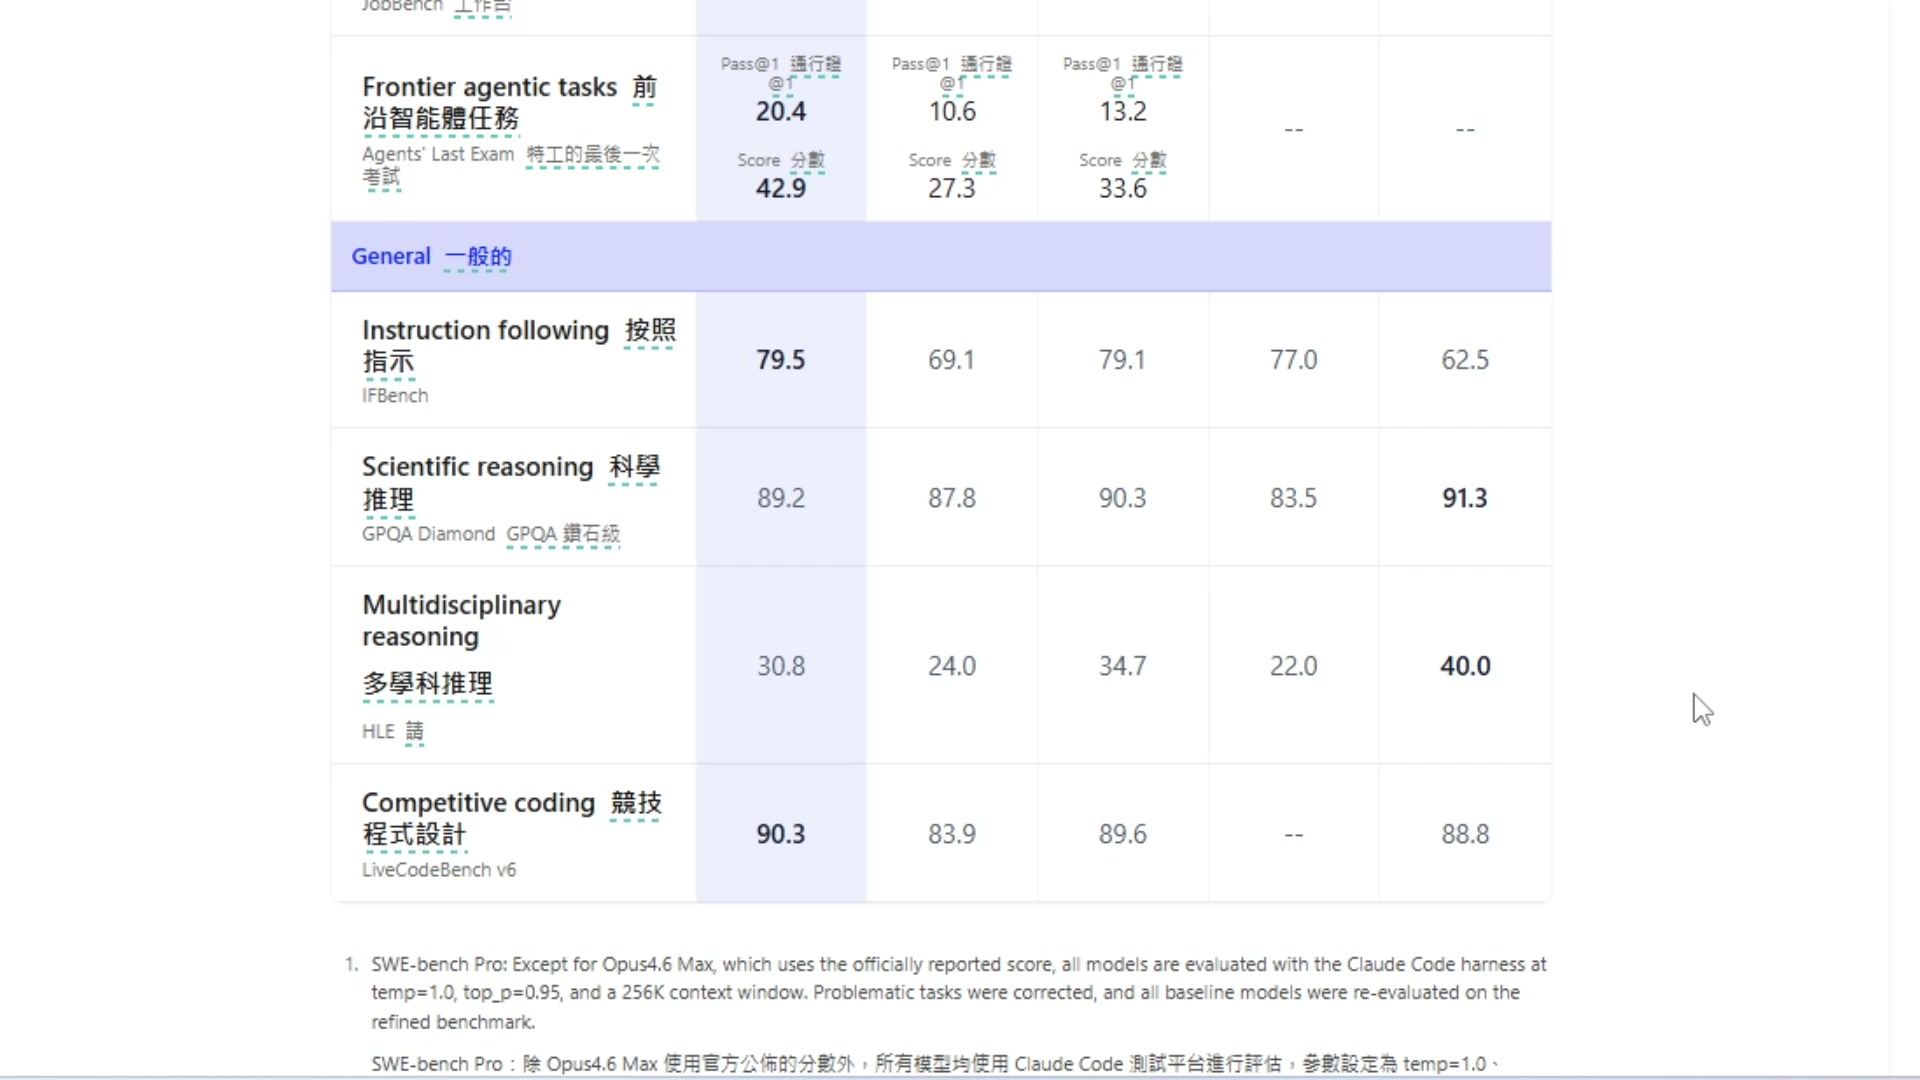
| JobBench (專業工作任務) | 33.4 | 21.8 | 27.6 | – | – |
| Agents’ Last Exam (ALE 綜合得分) | 42.9 (Pass@1: 20.4) | 27.3 (Pass@1: 10.6) | 33.6 (Pass@1: 13.2) | – | – |
| IFBench (嚴格指令遵循) | 79.5 | 69.1 | 79.1 | 77.0 | 62.5 |
| GPQA Diamond (科學推理) | 89.2 | 87.8 | 90.3 | 83.5 | 91.3 |
| HLE (多學科高難度推理) | 30.8 | 24.0 | 34.7 | 22.0 | 40.0 |
這份數據裡有三個非常關鍵的看點:
- 斷崖式甩開前代:比起 Qwen 3.6-27B,3.8 在各項硬核代碼測試上幾乎是翻倍成長。最具指標性的
DeepSWE 1.1,直接從 13.3 暴衝到 42.2,整整翻了三倍有餘。 - 在實際工程修復上超越 Opus 4.6:在軟體工程界公認難度最高的真實 GitHub Issue 修復測試 SWE-bench Pro 中,Qwen 3.8-27B 拿下了 61.7 分,超越了 Opus 4.6 的 53.4 分;在長達 8 小時超時、32K 最大輸出的 QwenSWEBench 更是以 79.0 領先 Opus 的 63.8。在演算法導向的 LiveCodeBench v6 上,也以 90.3 險勝 Opus 的 88.8。
- 終端與全倉庫生成的拉鋸:在
Terminal Bench 2.1(終端指令操作)與NL2Repo-Bench(多檔案倉庫生成)上,Claude Opus 4.6 依然保有些微優勢(分別為 78.2 vs 73.0 與 47.6 vs 42.3)。這說明在純指令鏈工具熟練度上,頂規雲端旗艦的經驗累積還是不可小覷,但兩者的差距已經被拉平到同一梯隊。
多模態能力:不只看圖,還能操控介面與寫前端
除了純文字代碼,Qwen 3.8-27B 本身就是一顆原生視覺語言模型(Vision-Language Model),不需要外掛任何 Adapter,就能原生解析高解析度圖像與長度達數小時的影片。
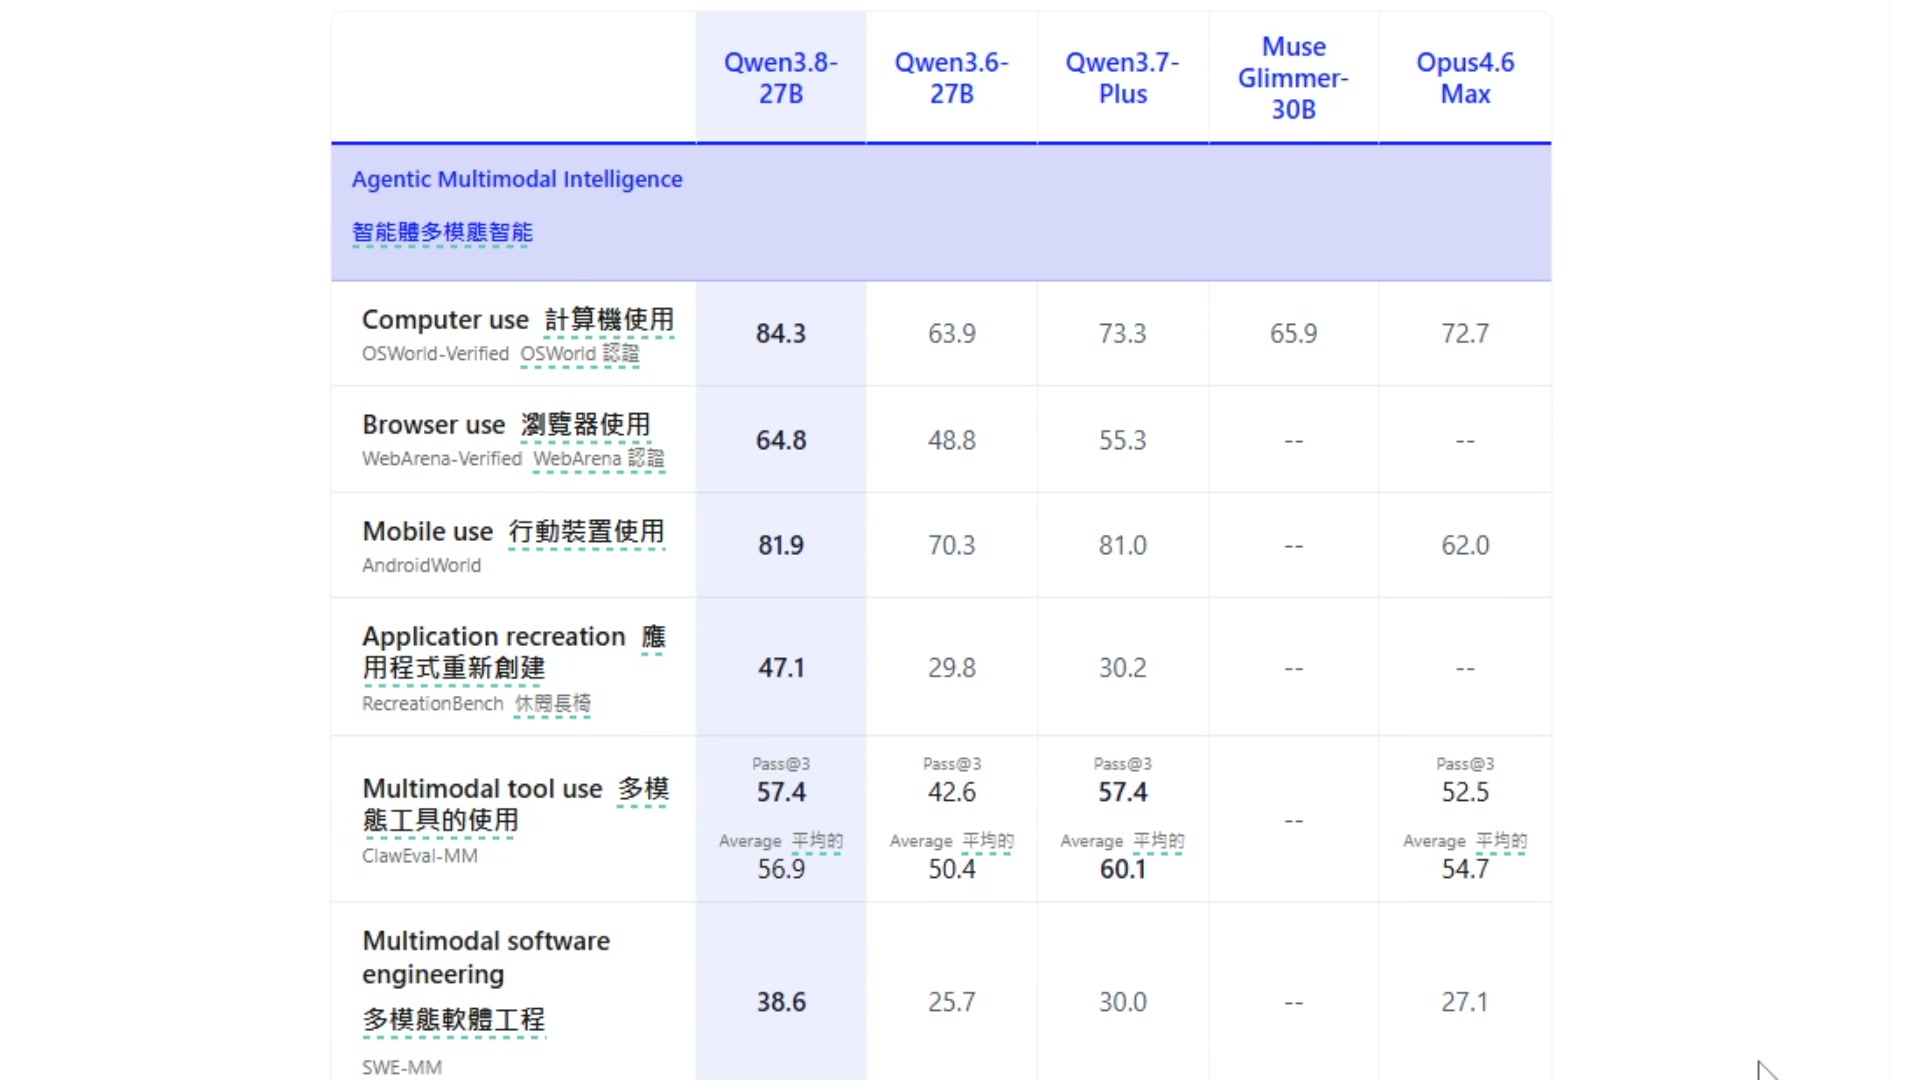
多模態智能體與視覺推理跑分對照表
| 評測維度 / 資料集 | Qwen 3.8-27B | Qwen 3.6-27B | Qwen 3.7-Plus | Opus 4.6 Max |
|---|---|---|---|---|
| OSWorld-Verified (電腦系統操作) | 84.3 | 63.9 | 73.3 | 72.7 |
| WebArena-Verified (瀏覽器網頁操作) | 64.8 | 48.8 | 55.3 | – |
| AndroidWorld (手機行動系統操作) | 81.9 | 70.3 | 81.0 | 62.0 |
| Vision2Web (視覺化網頁開發) | 62.9 | 45.0 | 42.1 | – |
| RecreationBench (應用程式跨平台復刻) | 47.1 | 29.8 | 30.2 | – |
| SWE-MM (多模態軟體工程修復) | 38.6 | 25.7 | 30.0 | 27.1 |
| MathVision (幾何與視覺數學 / 含代碼解釋器) | 94.6 | 85.1 | 90.3 | 65.5 |
| BabyVision (通用視覺推理 / 含代碼解釋器) | 85.6 | 28.9 | 70.4 | 12.6 |
| CharXiv (科學圖表深度分析 / 含代碼解釋器) | 90.2 | 78.4 | 85.9 | 66.0 |
| OmniDocBench 1.5 (複雜文檔解析與版面分析) | 91.1 | 89.4 | 91.4 | 86.6 |
從 Vision2Web(62.9)與 RecreationBench(47.1)的分數可以看出來,它在「看著介面截圖復刻前端」以及「利用視覺反饋自主 Debug CSS 跑版」這兩件事上,打下了非常堅實的基礎。這意味著未來的本機前端 Agent,真正具備了寫完程式碼後自動開瀏覽器截圖、肉眼校對跑版、再自己把 CSS 修好的閉環能力。
本機部署環境與硬體門檻
目前 Qwen 3.8 已經全面進駐 Ollama,一行指令就能直接拉取運行:
|
|
顯存門檻與實測設備
不過老實說,27B 的 Dense 模型食量依然不可小看。即便採用 4-bit 量化,顯卡的 VRAM 門檻基本還是要在 24GB 以上(例如 RTX 3090 或 4090)。如果顯存低於 24GB,光是載入模型權重後剩下的顯存,只要丟稍微長一點的上下文或是碰到展開數千 Token 的思維鏈,顯存就會瞬間溢出導致崩潰。
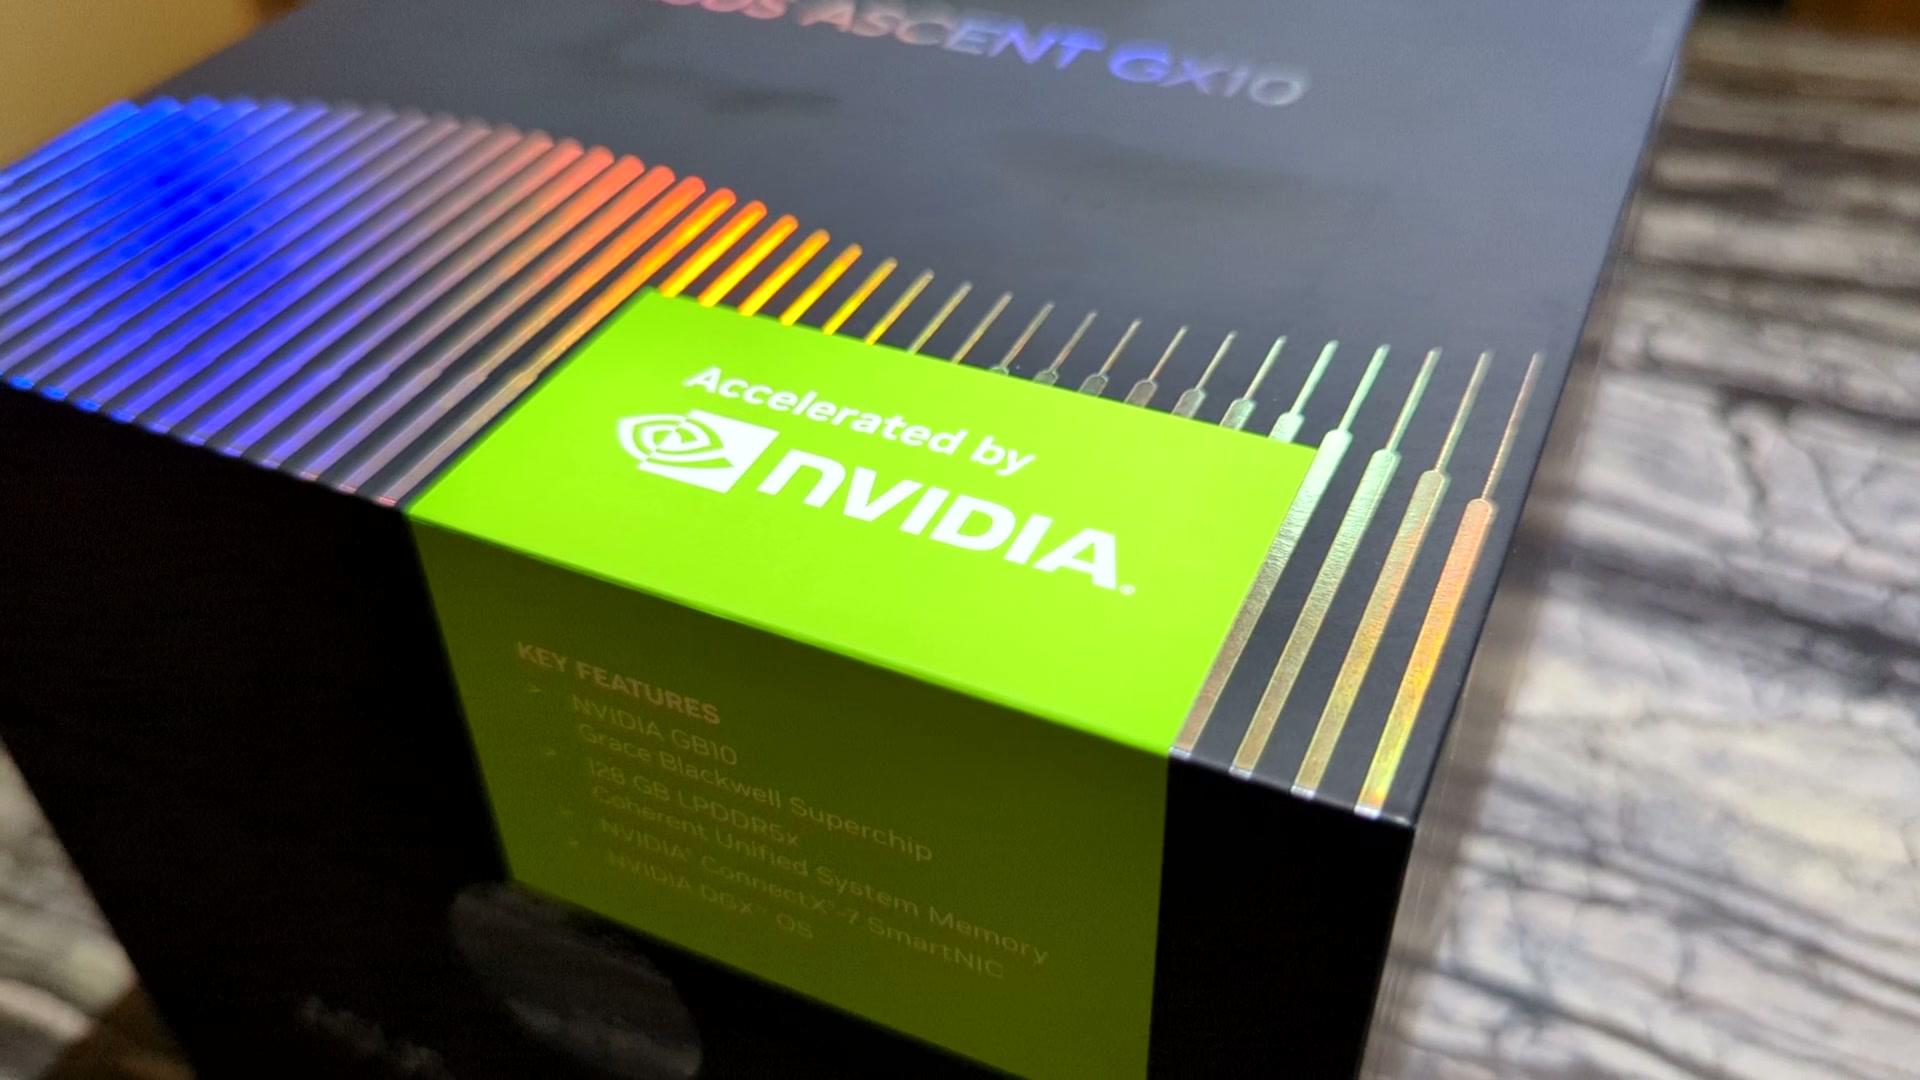
這次我的實機測試環境,是使用我先前開箱分享過的迷你工作站 ASUS Ascent GX10(DGX Spark):
- 運算核心:NVIDIA GB10 (Grace Blackwell Superchip)
- 記憶體架構:128GB LPDDR5x 統一系統記憶體(Unified Memory)
- 高速互連:NVIDIA ConnectX-7 SmartNIC
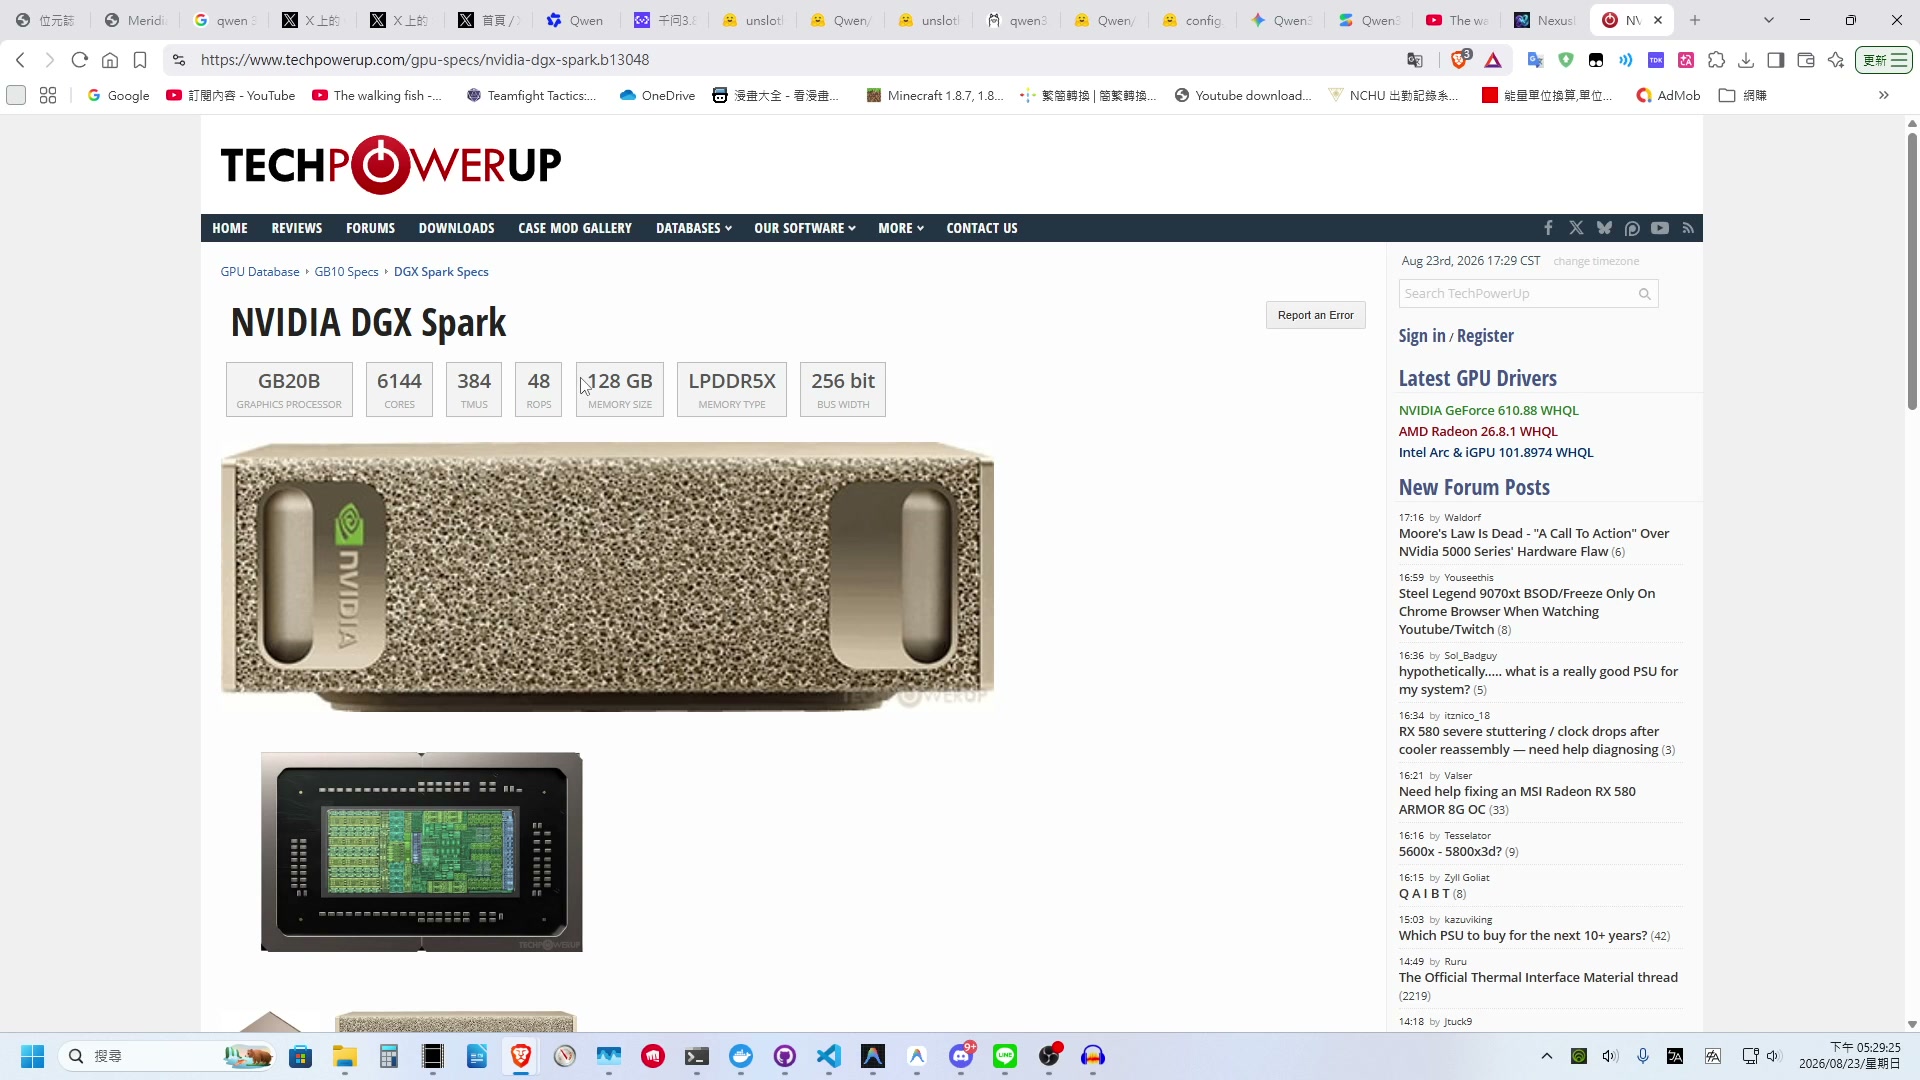
雖然統一記憶體在純顯存頻寬的吞吐極限上不如專用的雙卡伺服器,但它最大的殺手級優勢就是 128GB 的統一顯存空間。我可以完全無視上下文長度限制,肆無忌憚地把 262K 原生 Context Window 開滿,再也不用每天看著顯存報警而小心翼翼。
在精度選擇上,我平時主力都是跑官方的 FP8 精度;但這次為了探究極限壓縮對代碼生成與視覺審美的影響,我也特別載入了 NVFP4 量化版本進行對照實測。
實機實測:六大極限前端與代碼驗收
跑分只是參考,寫程式是拿來用的,不是拿來拜的。接下來我們透過六個難度不一的考題,看看 Qwen 3.8-27B 在前端代碼、3D 幾何、遊戲邏輯與中文視覺上的真實功底。
考題一:櫻花寶塔庭園——體素與光影的跨模型硬碰硬
第一題是最近在社群上很紅的「櫻花寶塔測試」,考驗模型能否在乾淨的單頁 HTML 內,用 Three.js 建構出日式庭園、光影與體素(Voxel)建築。
我透過 Hermes Agent 發出測試指令:
|
|
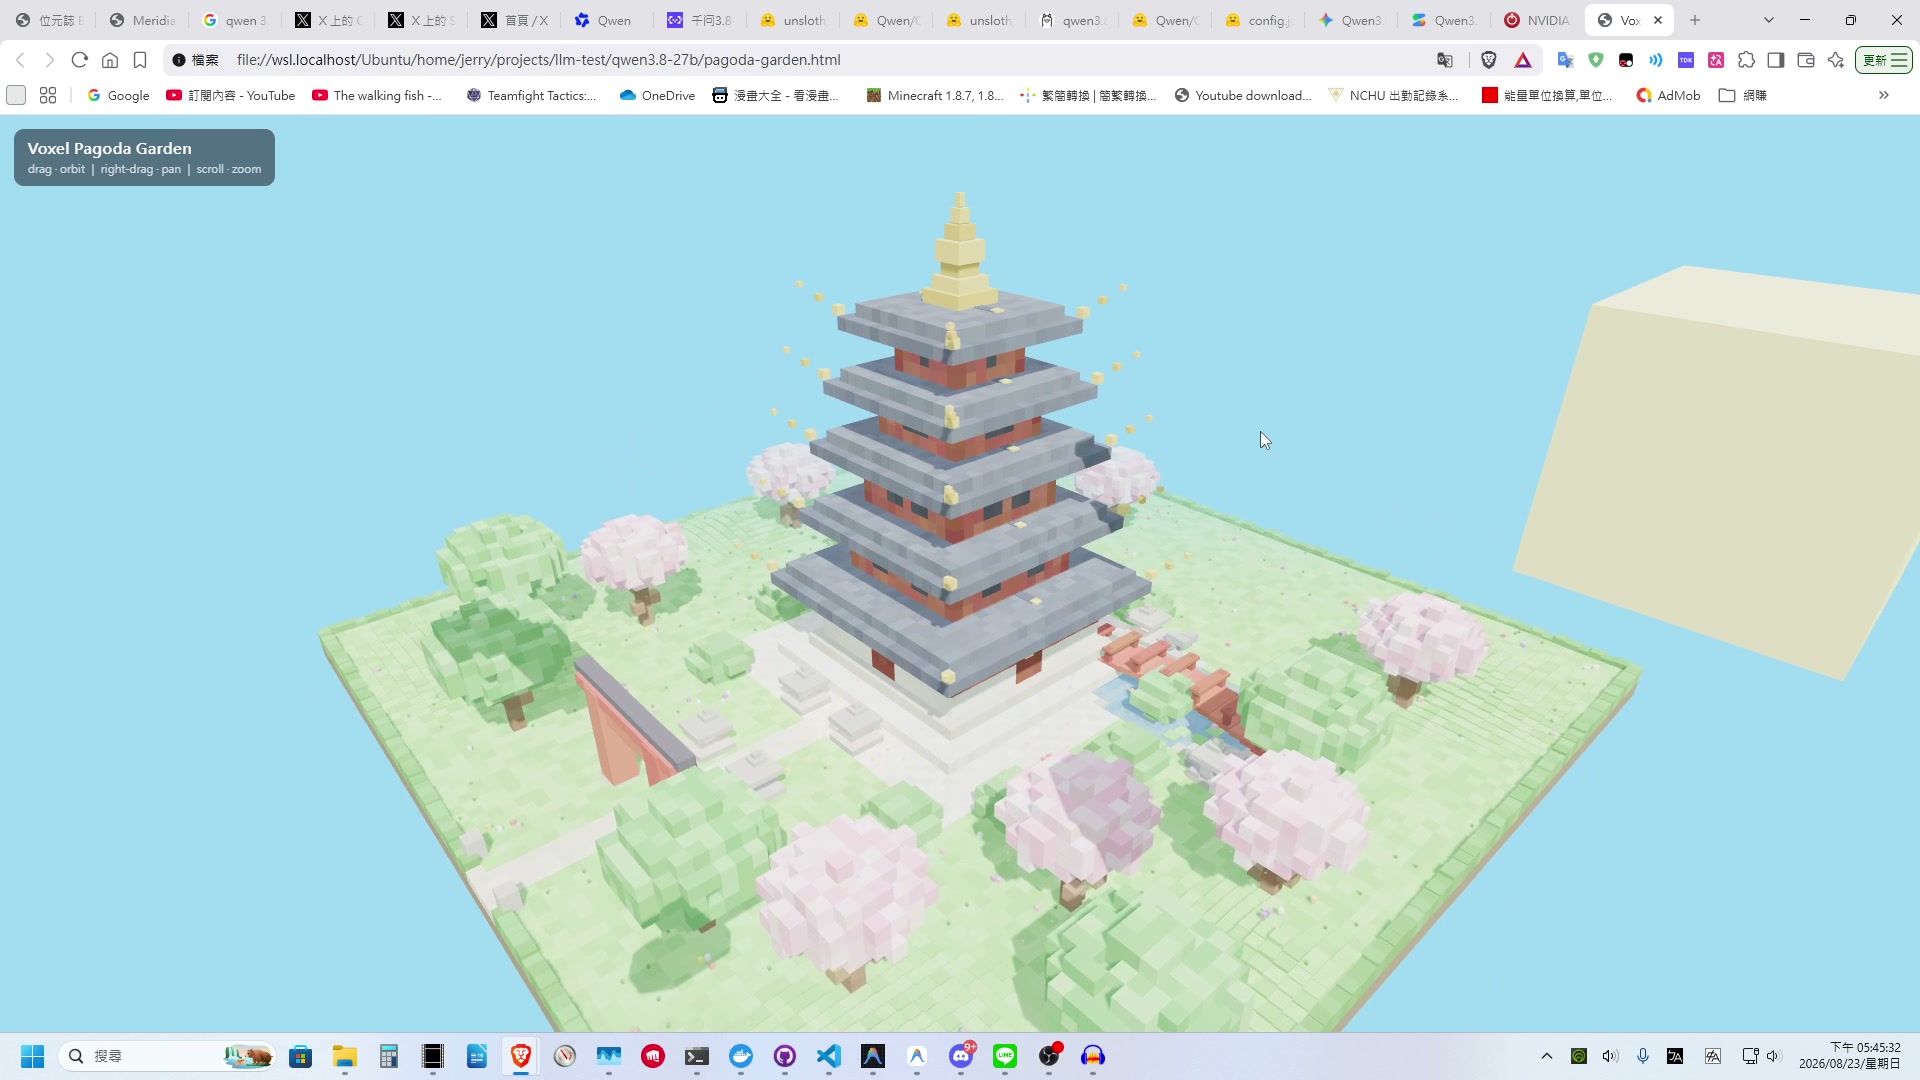
Qwen 3.8-27B (FP8 標準版)
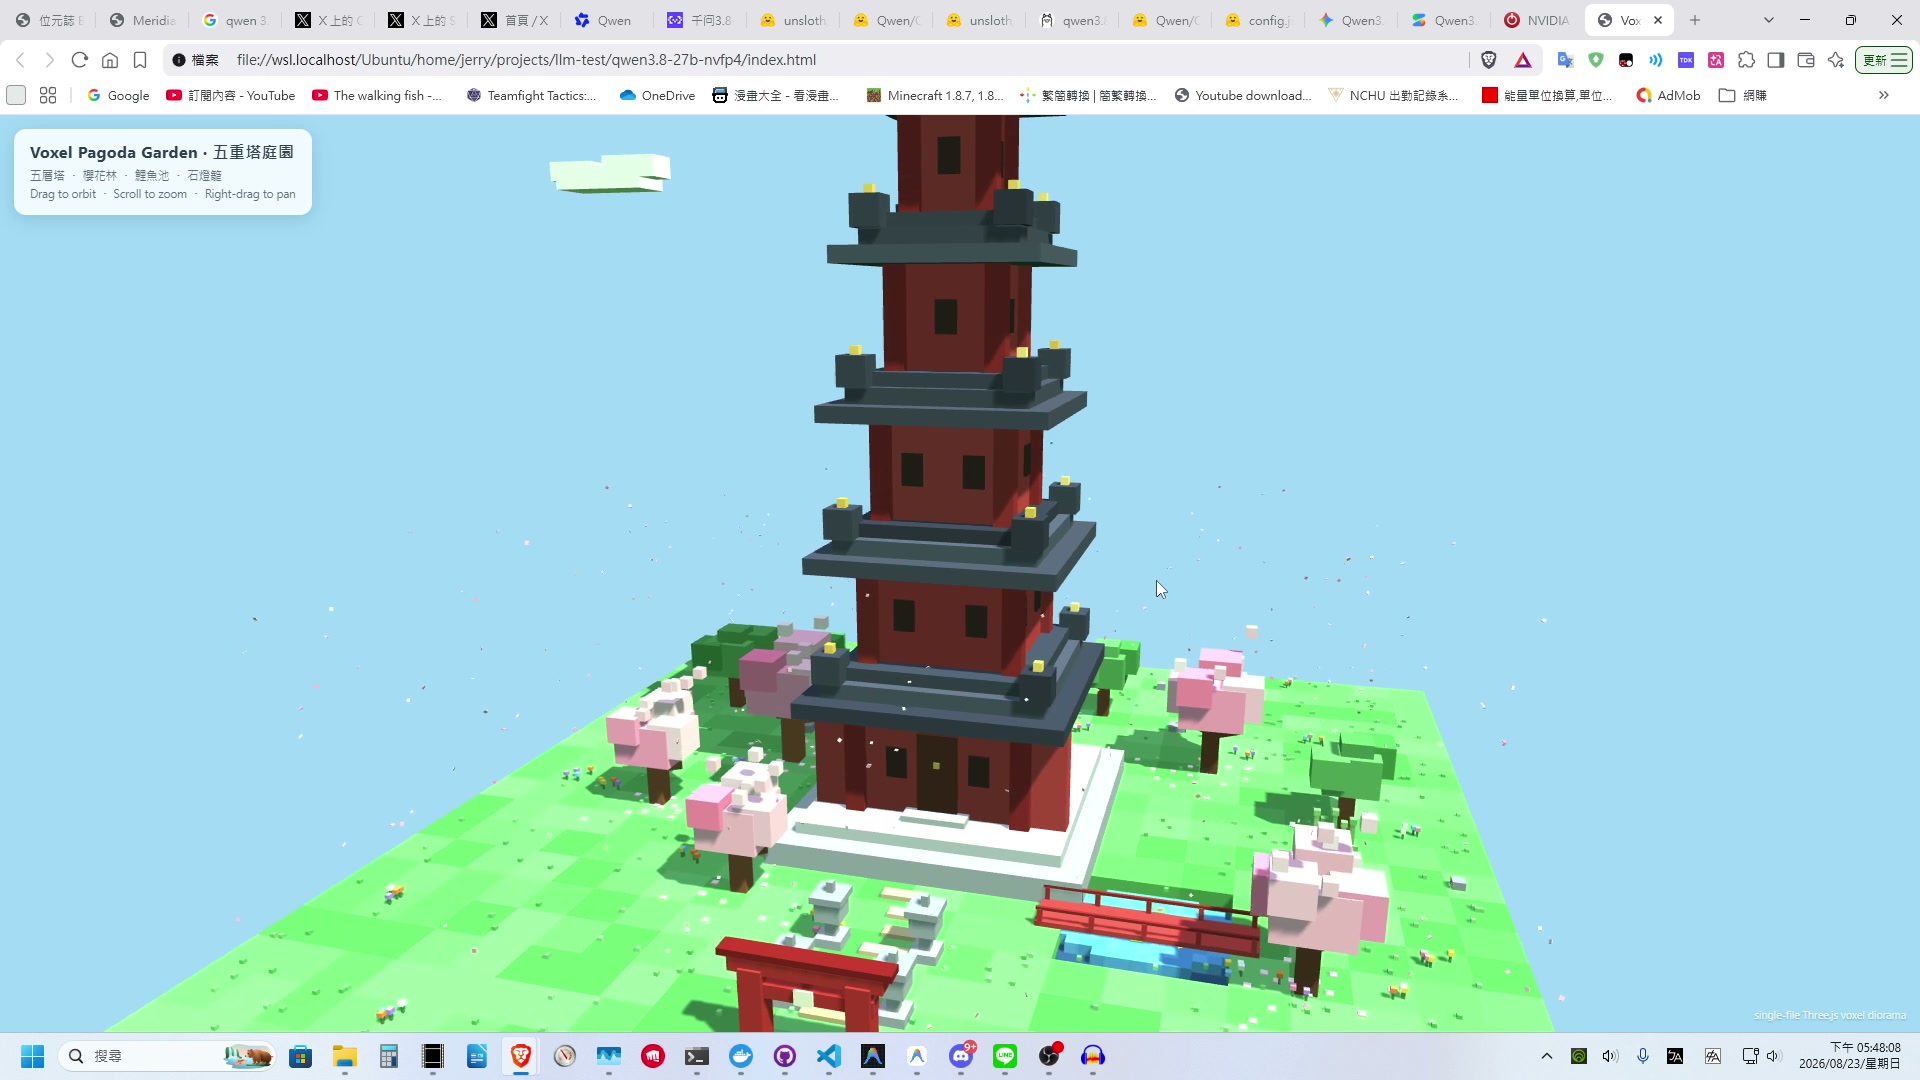
成果讓人相當驚豔。畫面生成出一座五層木質寶塔,庭園四周點綴了粉紅色的櫻花樹、石燈籠、紅色小拱橋與石板步道。整體色調溫潤,滑鼠拖曳視角時流暢順滑,光影的層次感非常豐富。
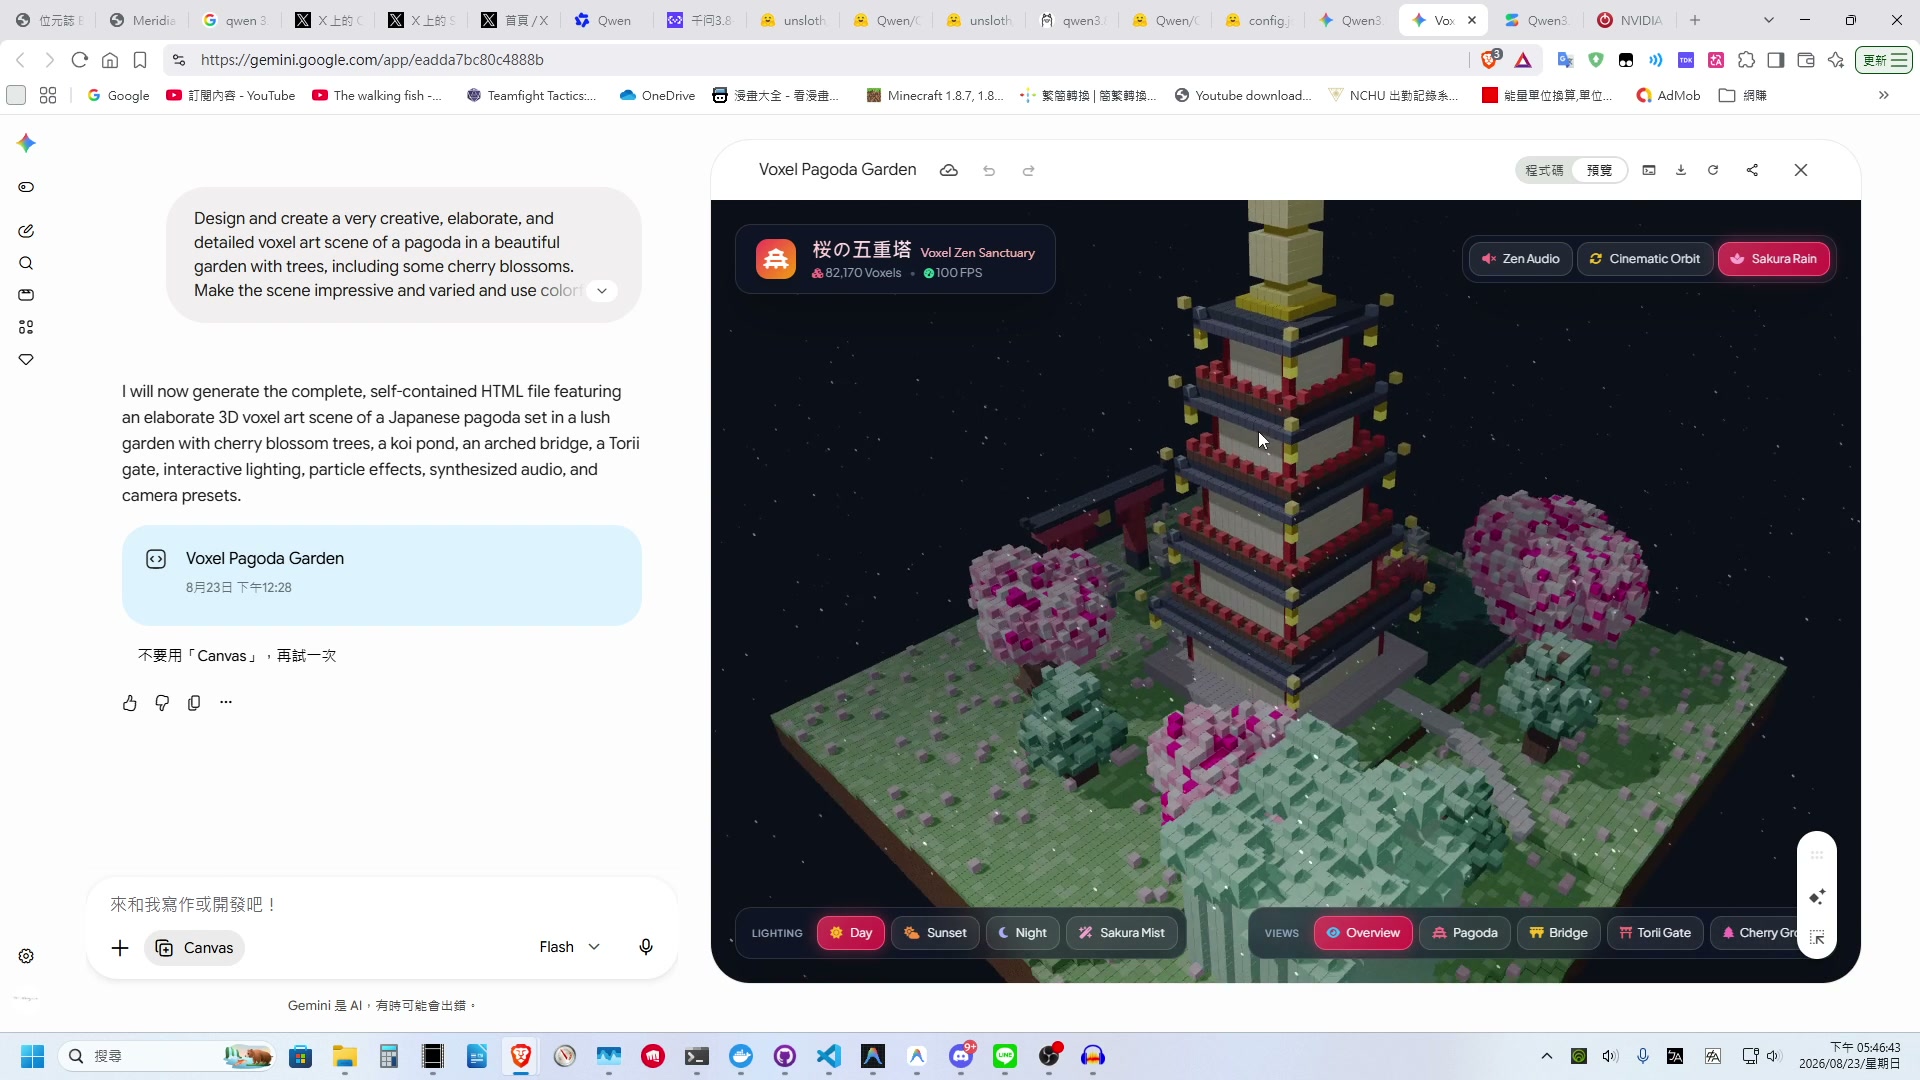
對照組:Gemini 3.7 Flash
餵入一模一樣的提示詞給 Gemini 3.7 Flash。Gemini 產出的「桜の五重塔」在功能互動按鈕上做得比較花俏(自帶黃昏/黑夜切換、櫻花雨粒子動效開關、甚至還有背景禪風音效)。但如果回歸到純粹的體素造型美感、光影質感與建築本身的比例平衡,我個人主觀覺得 Qwen 3.8-27B 的視覺成果更具手工刻劃的扎實感。
NVFP4 量化版本對比
換成 NVFP4 極限 4-bit 量化版本後,整體光影架構依然在,但瑕疵肉眼可見:體素的配色開始顯得生硬,庭園植被與屋簷結構也出現了明顯的簡化。這證實了極限量化確實會輕微磨損模型在複雜 3D 空間美學上的細微判斷力。
考題二:Three.js 天空懸島——自發光水晶與虛空瀑布
第二題我們進一步加強對動態光影與幾何層次的要求,要求它製作一個浮空島嶼,並且一定要有中世紀風車、墜入虛空的瀑布以及發光水晶。
|
|
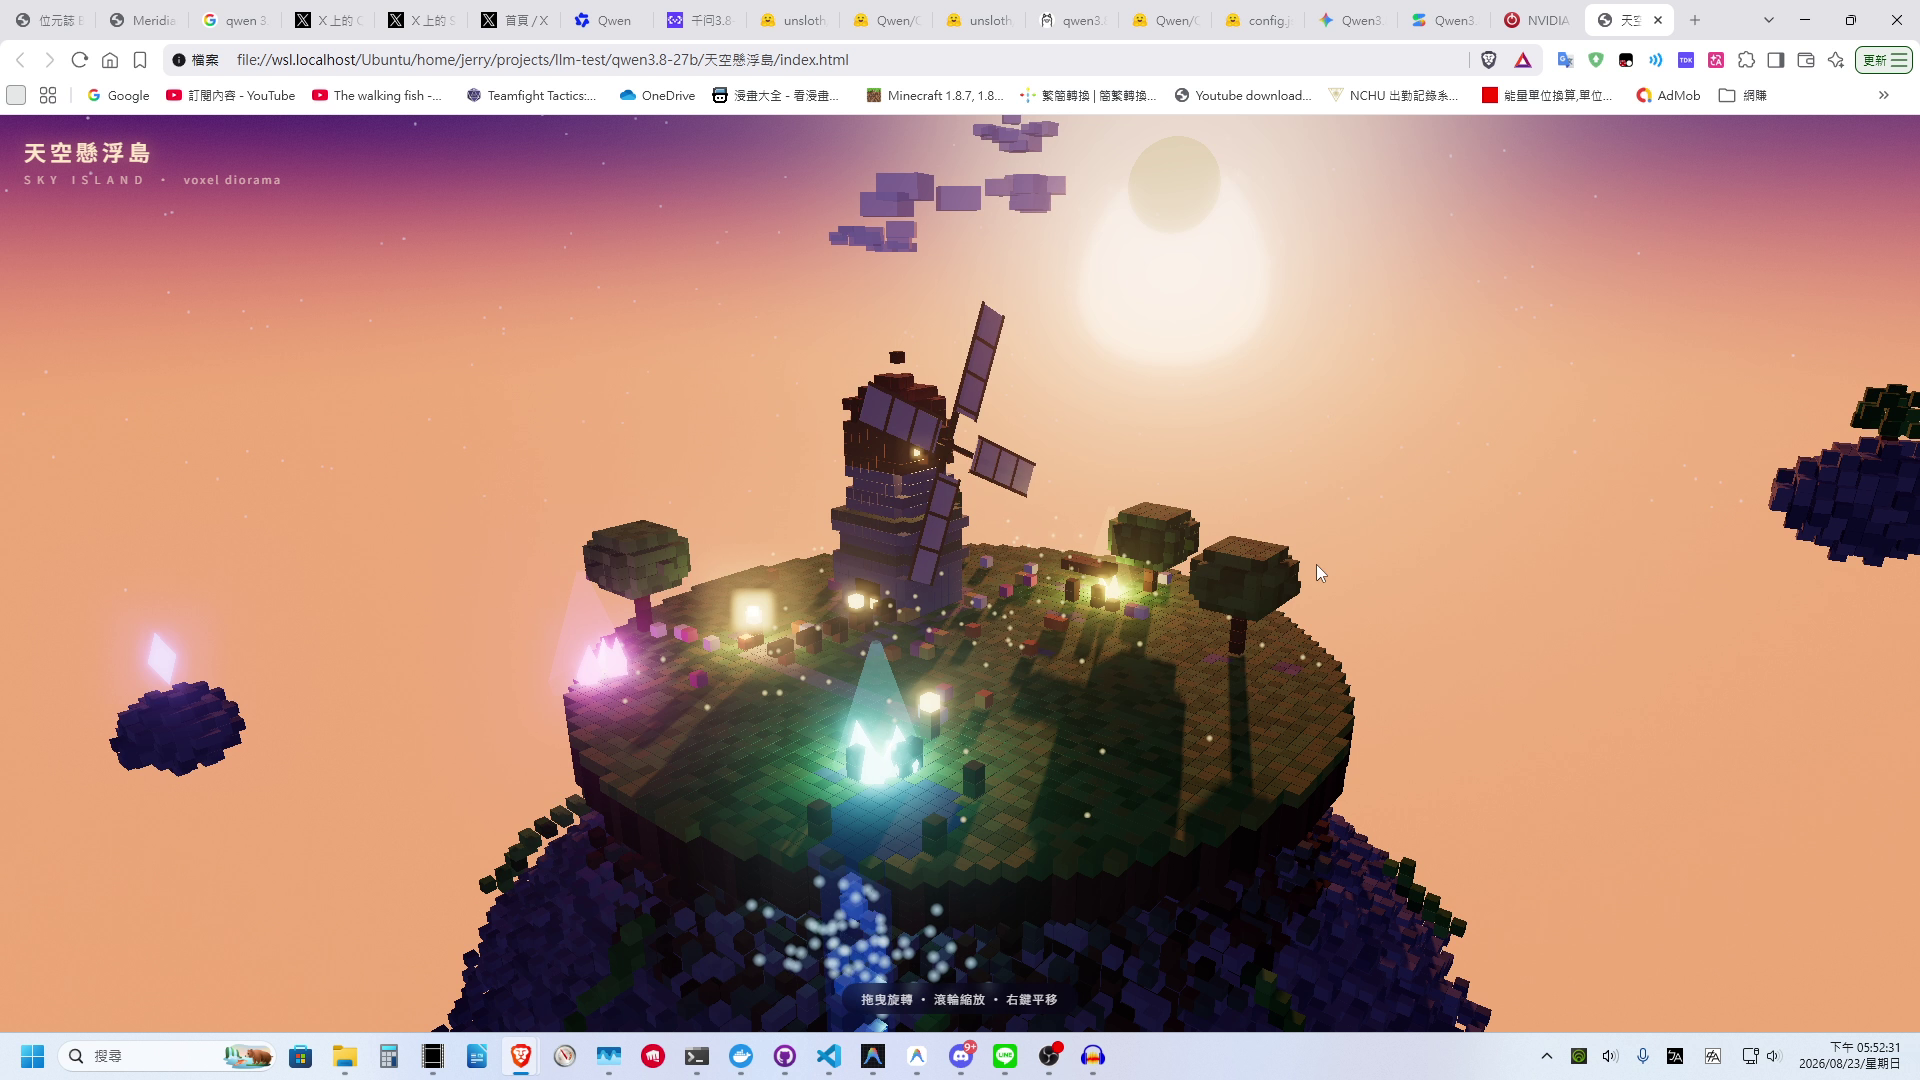
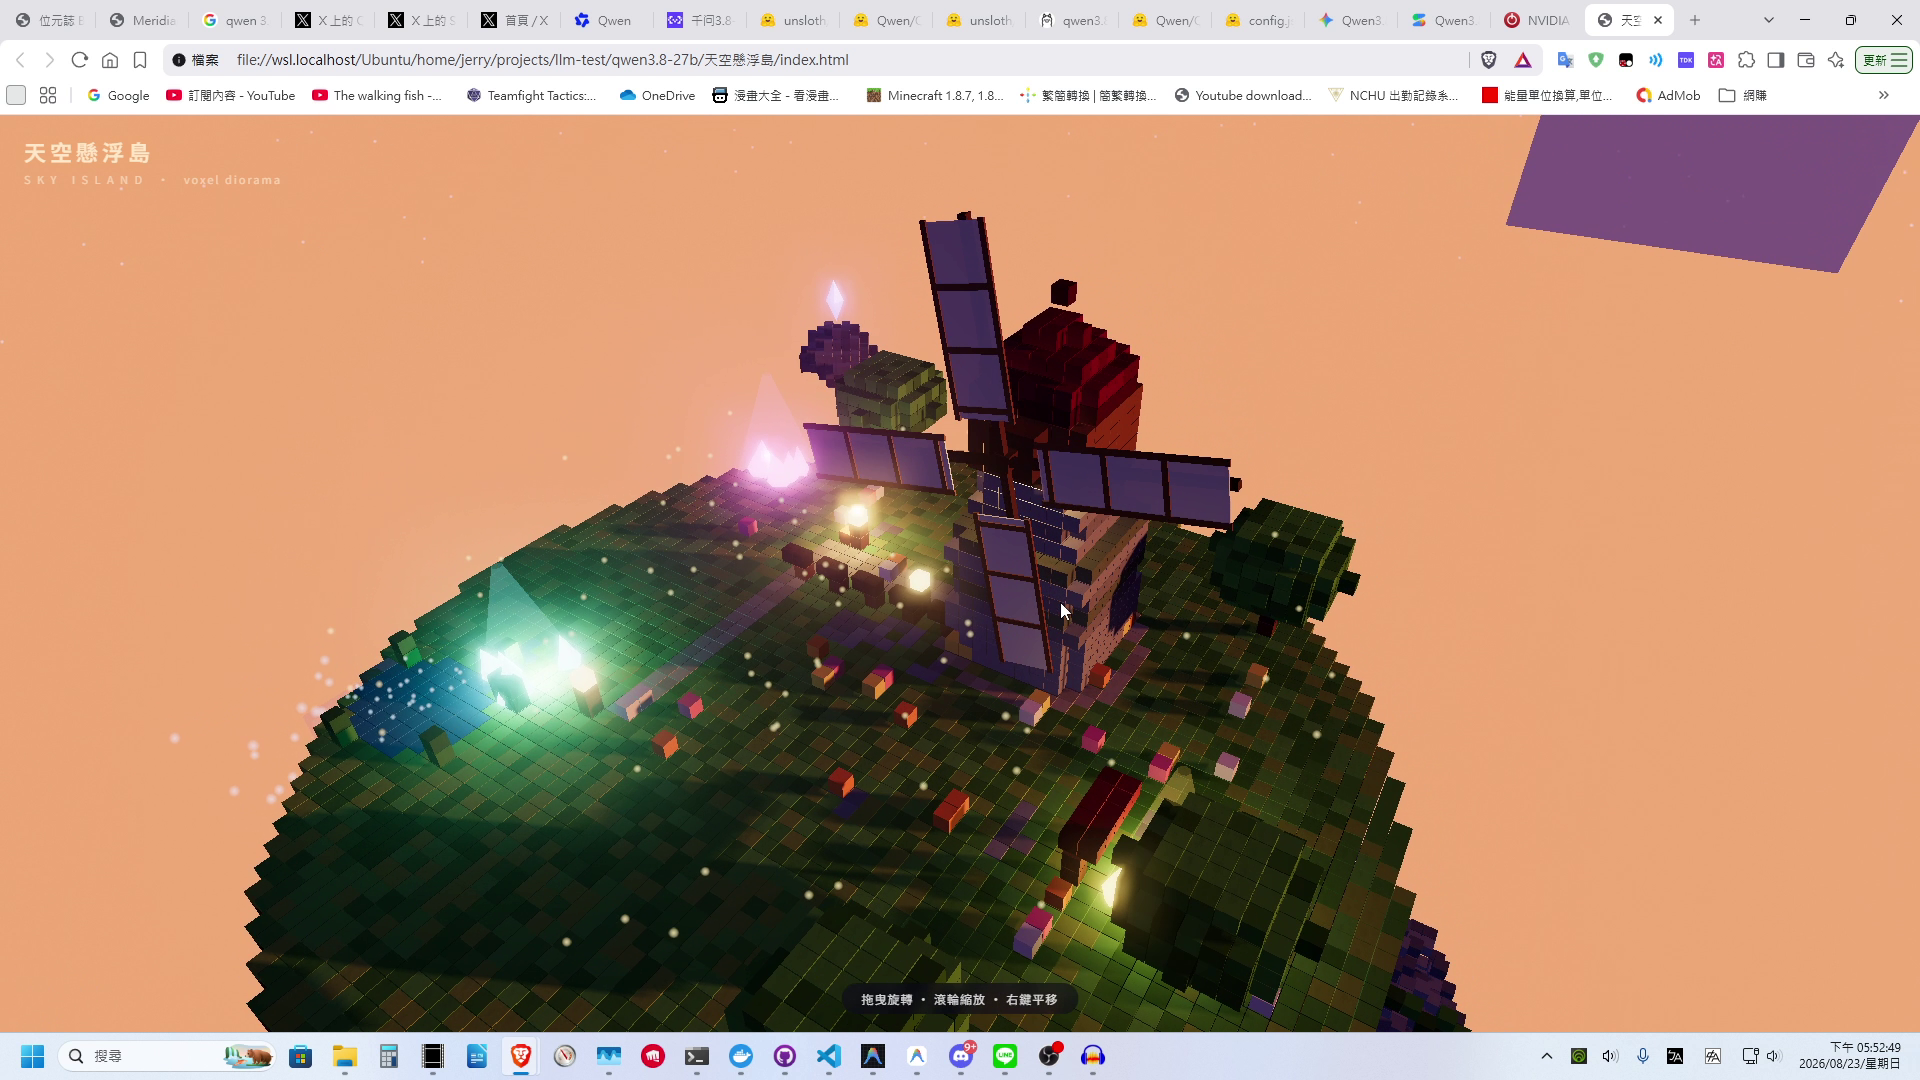
產出的「天空懸島 SKY ISLAND」同樣給了我很大的驚喜:
- 浮島底部的泥土斷層具有立體的岩層節奏,不再是一塊平整的立方體。
- 風車本體與轉軸幾何結構完整,周圍散佈了數顆自發光水晶,並且自帶了柔和的動態點光源渲染。
- 瀑布從島嶼懸崖邊緣傾瀉而下並墜入虛空,水流與周邊草皮的交界處理得很自然。
考題三:復刻網頁版 Minecraft——790 行 JS 引擎與材質貼圖小翻車
第三題我想測試它手刻可玩性遊戲的能力。提示詞非常簡單直接:「build a Minecraft clone with web」。
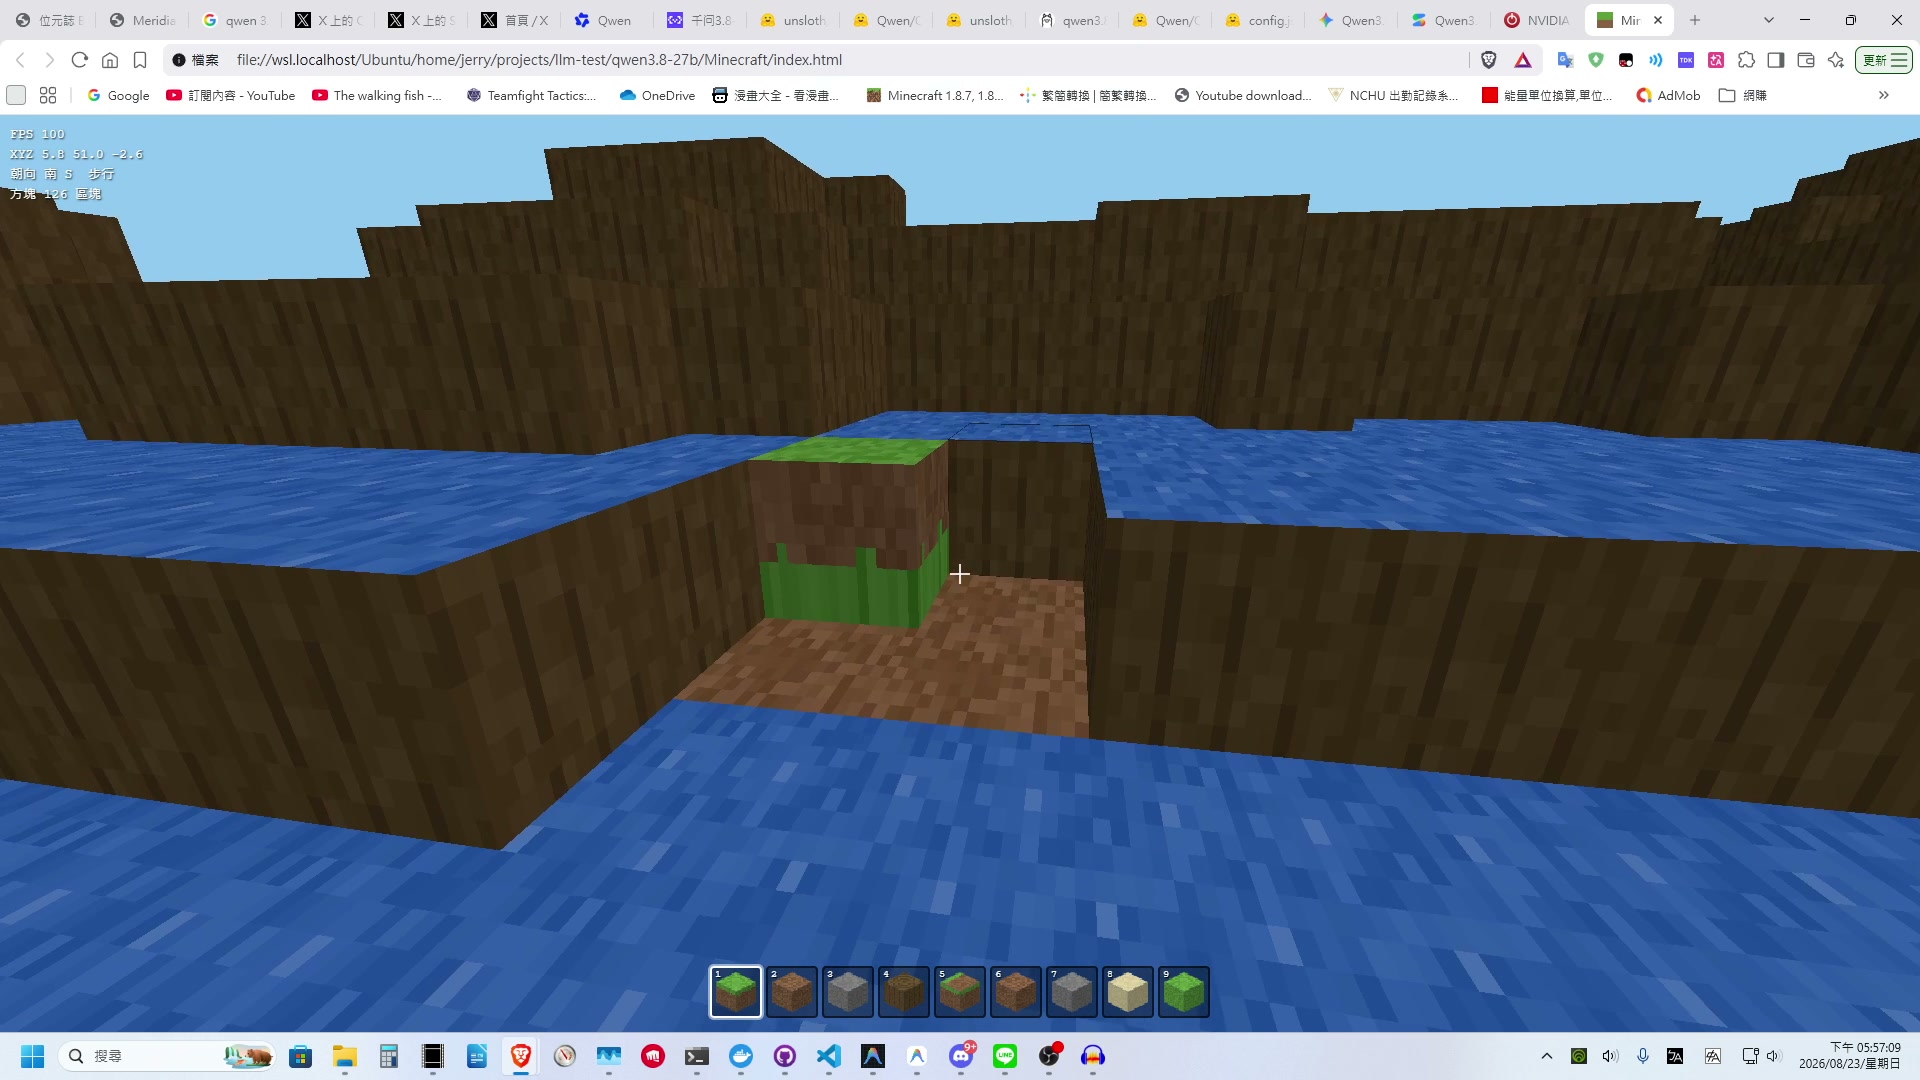
這次沒有限制只能單檔案。Qwen 3.8-27B 沉思了一陣子後,在資料夾中開始製作:
- 整合了原生指針鎖定(Pointer Lock API),滑鼠點擊即可鎖定第一人稱視角。
- 鍵盤 WASD 移動、空白鍵跳躍、重力加速度與方塊碰撞判定全數正常。
- 滑鼠左鍵破壞方塊、右鍵放置方塊,畫面底部還貼心實作了 9 格快捷物品欄,可以自由切換泥土、石塊與草地。
踩坑插曲:材質索引映射的小翻車
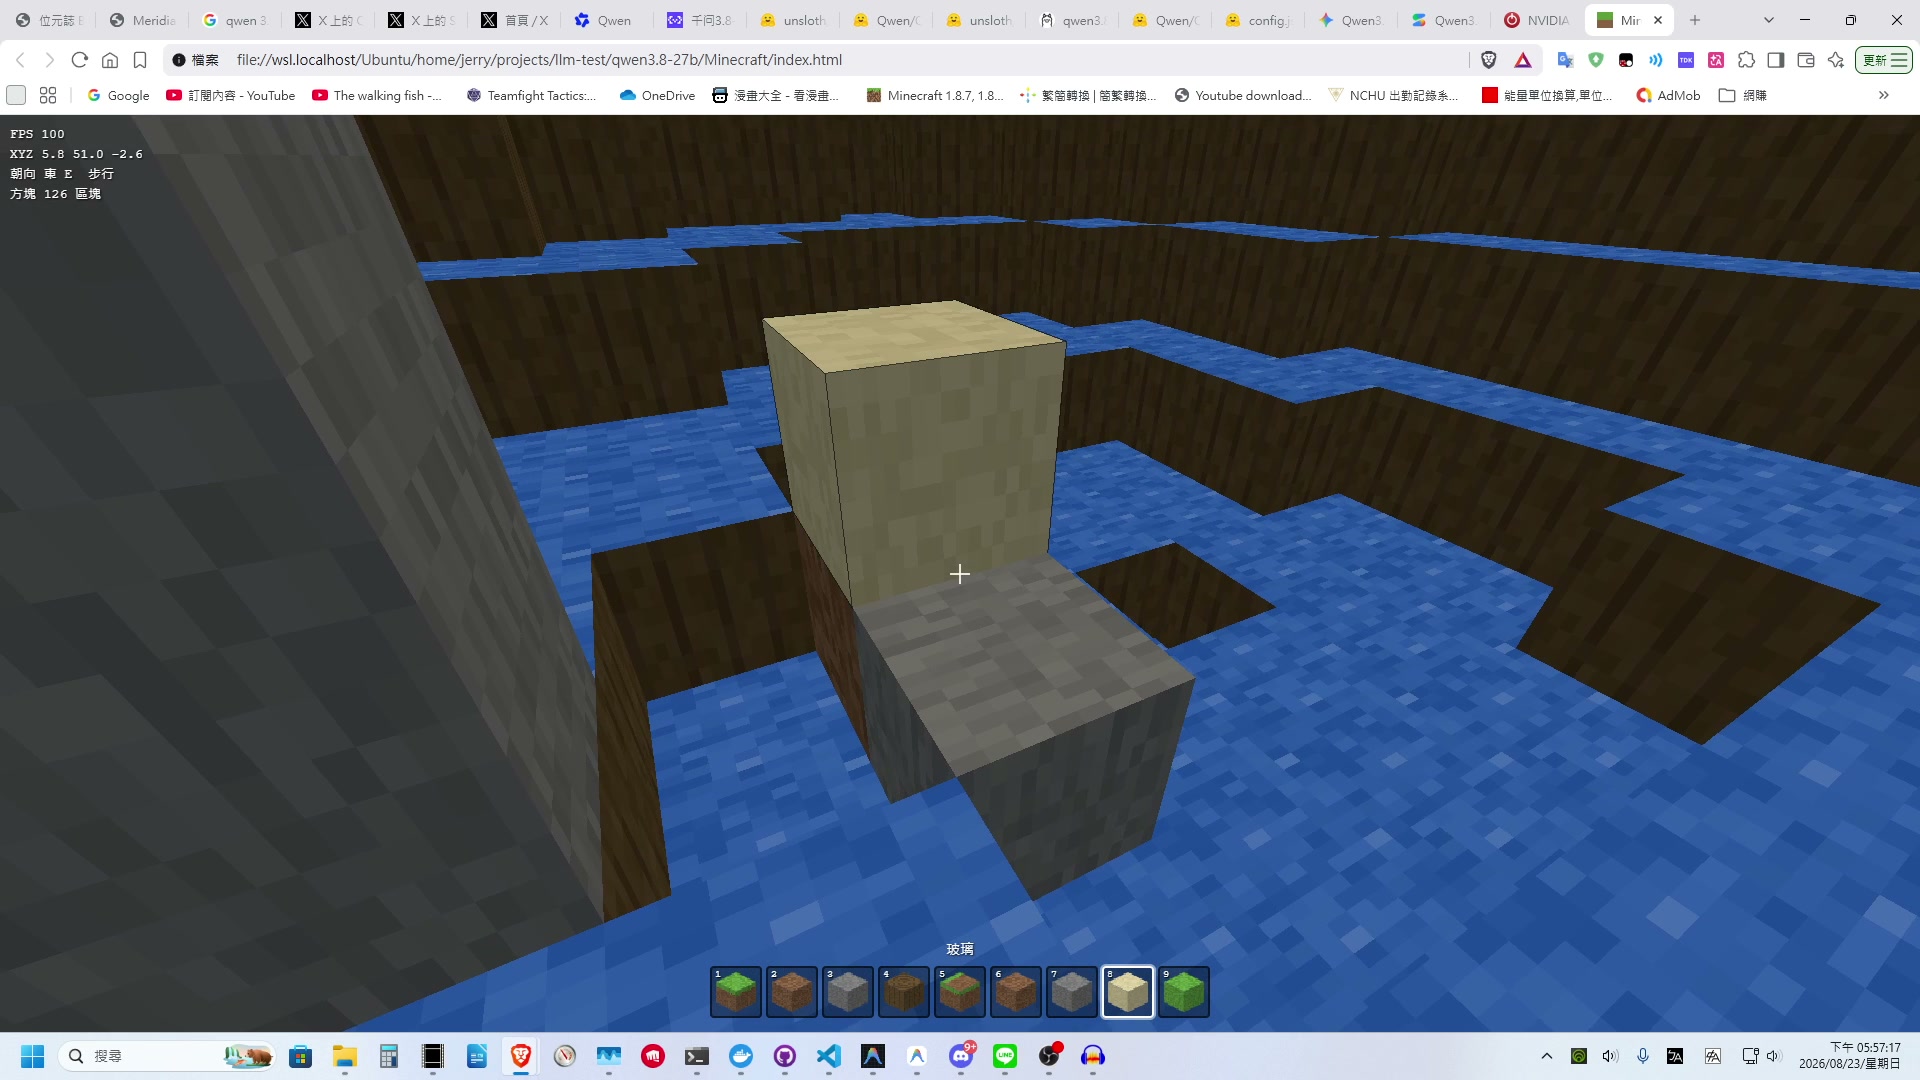
不過在實際試玩時我也抓到了一個有趣的小瑕疵:當我把快捷列切換到第 8 格的「玻璃(Glass)」方塊並在地上放置時,畫面出來的方塊居然套用了「沙子(Sandstone)」的黃色顆粒貼圖。雖然方塊能正常破壞與堆疊,但顯然模型在材質貼圖陣列的索引對應上搞錯了參數。這種小失誤在長代碼生成中很常見,但也證明它完全是在現場推導邏輯,而非單純背誦範例。
考題四:科技部落格單頁前端——坐在螢幕前愣住的瞬間,也是「位元誌」的誕生起點
如果說前面幾項 3D 測試只是驗證了幾何想像力,那麼第四項測試,則是真正讓我坐在電腦螢幕前愣住了好幾秒的轉折點。
我給了它一個很常規的指令:
|
|
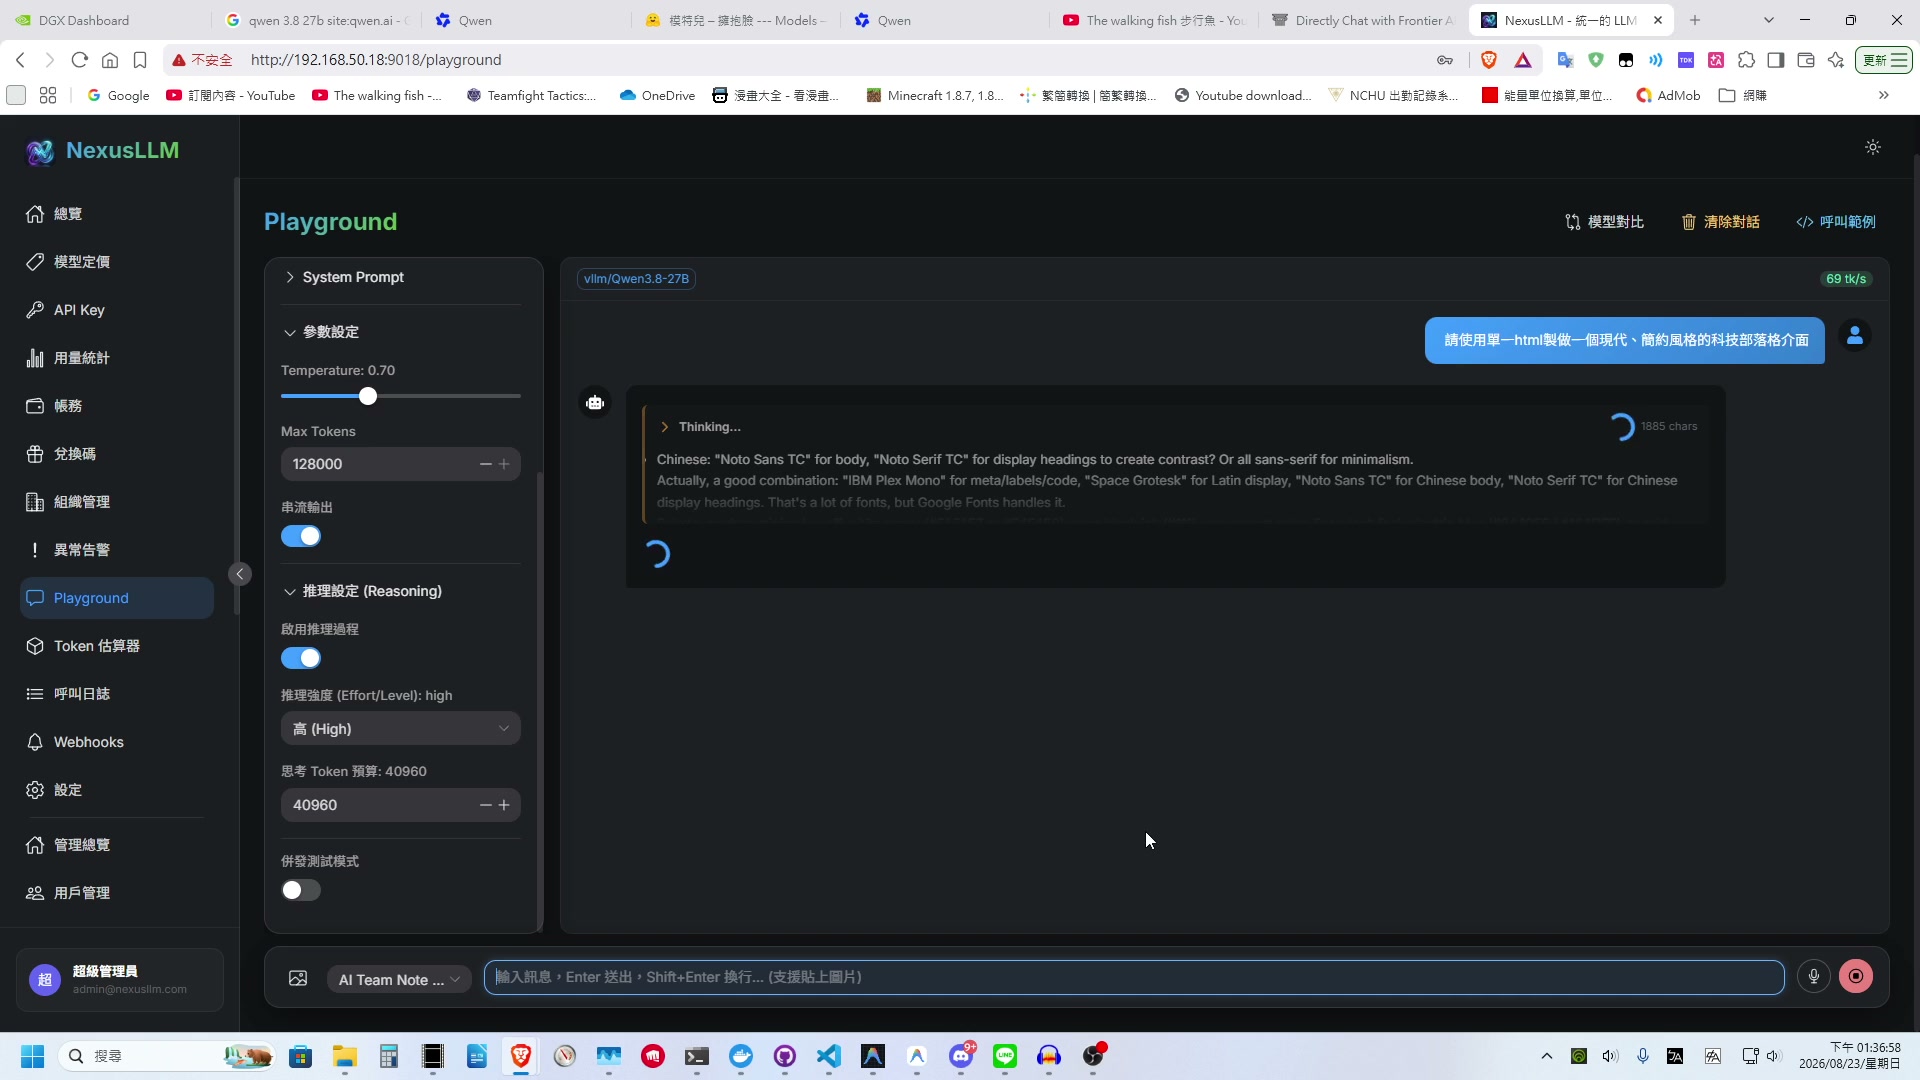
從我自製的網站中的的推論視窗中可以看到,這是一個不具有多步驟執行能力的、單純的對話介面,但模型在思考階段就已經非常有品味地規劃了整體的排版架構:它主動引入 Google Fonts,並主動思索如何利用 Space Grotesk(英文 Display)、Noto Serif TC(宋體標題)、Noto Sans TC(內文)與 IBM Plex Mono(標籤代碼)來營造現代科技雜誌的版面張力。
最後生成的「位元誌 BITWISE」,版面簡約俐落,徹底洗刷了傳統 AI 生成網頁那種死板的塑膠套版感:
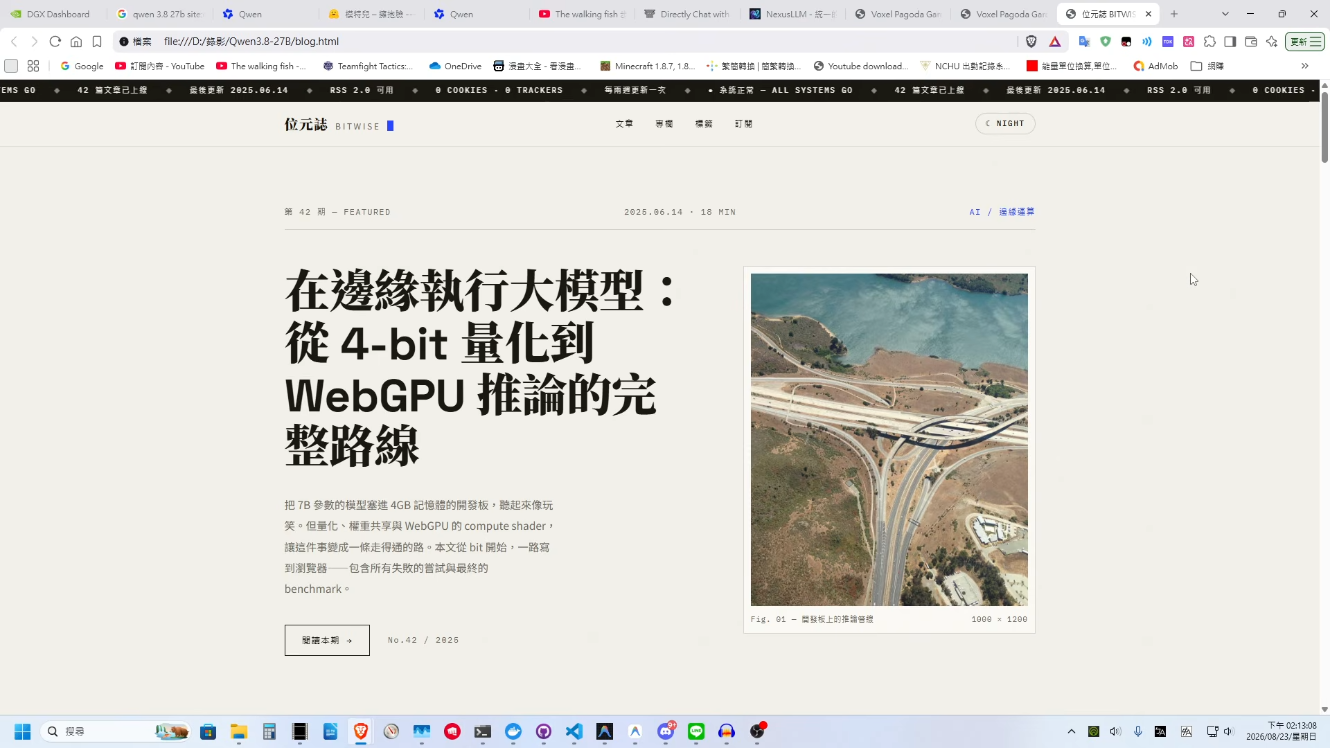
- 現代報刊風的文字排印:高對比的文字節奏,搭配清晰的序號系統(No.41, No.40…)與閱讀時間估算。
- 維度明確的分類過濾:包含人工智慧、系統、網頁、效能等多標籤即時篩選。
- 質感滿滿的互動細節:當滑鼠游標移動到文章列表上時,會有懸浮圖片預覽出現的效果。
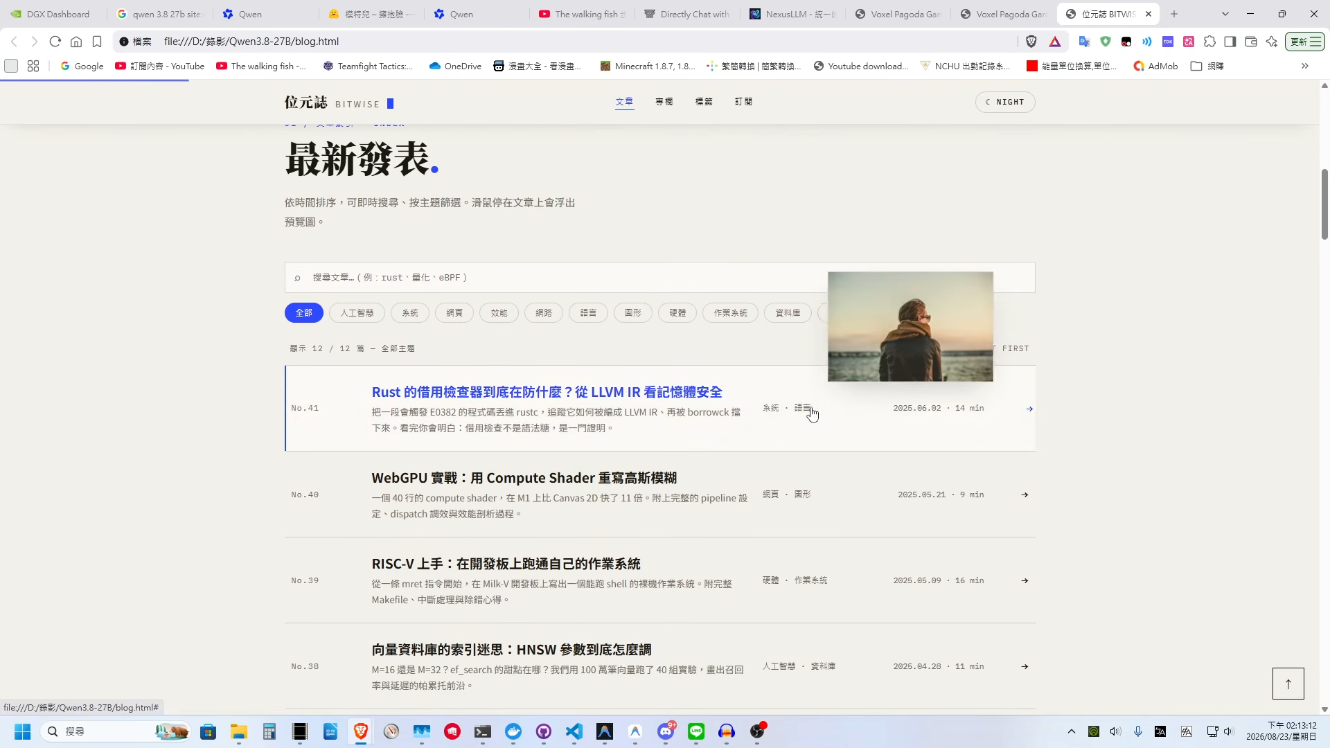
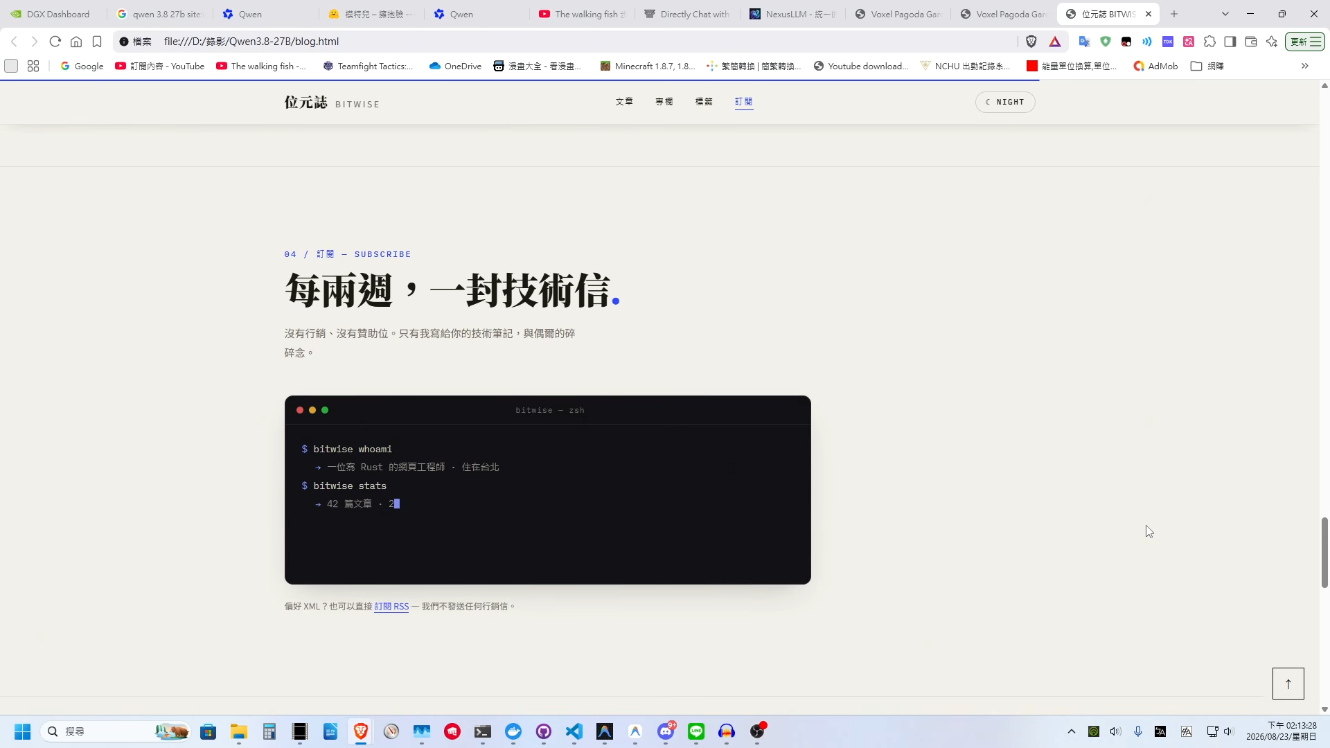
最不可思議的是,這個部落格原型還是用 NVFP4 量化版跑出來的!雖然 NVFP4 在 3D 體素那邊表現被閹割了一些,但在純前端 HTML/CSS 的美學設計上,依然展現出接近當今旗艦大模型的第一梯隊水準。在頁面底部,它甚至還設計了微噪點紙質質感、自訂終端機訂閱框(bitwise - zsh)與真正能運作的深淺色切換。這也是為什麼我後來下定決心,把整套部落格照著它的靈魂徹底打掉重做的原因。
考題五:Meridian SaaS 數據儀表板——乾淨實用的後台原型
第五個考題我換了個方向,想看看它做企業級儀表板(Dashboard)的能力,所以我請它做一個 SaaS 產品的分析後台 Meridian。
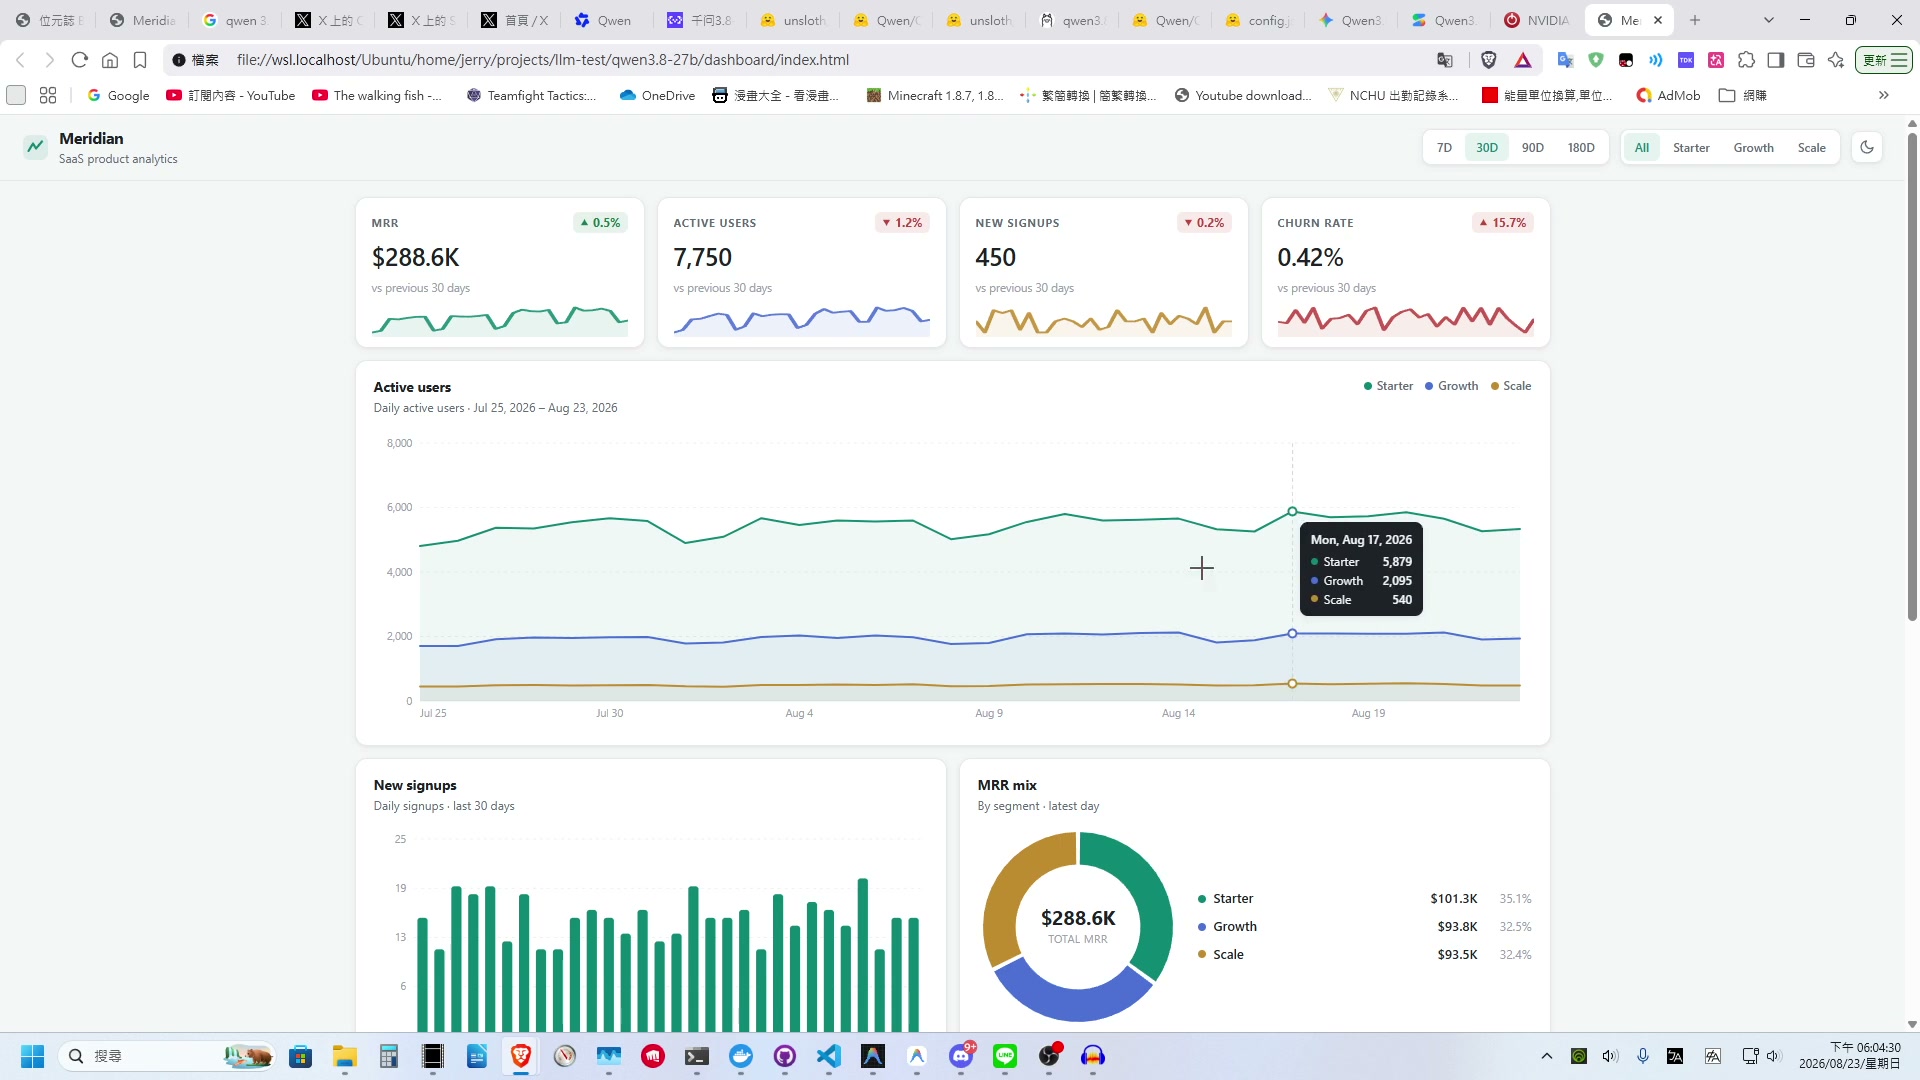
老實說,這類後台介面最容易被 AI 寫成死板的表格堆疊。但 Qwen 3.8-27B 吐出來的成品相當工整:
- 最上排整齊列出 MRR $288.6K、Active Users、New Signups 等核心指標卡片。
- 底下繪製了用戶活躍折線圖、每日註冊直條圖以及 MRR 佔比甜甜圈圖(Donut Chart)。
- 右上角時間區間(7D/30D/90D)跟深淺色模式切換按鈕都已經接好了事件監聽。
這種完成度,基本上拿來當後台原型甚至內部工具的起手式,已經可以直接省掉半天刻板的時間。
考題六:火鍋店菜單 OCR——原生中文多模態的降維打擊
最後一項測試,我隨手拿了一張外出吃飯時拍下的火鍋店菜單照片,丟進去讓它轉錄成結構化文字。這張照片除了字體大小不一,還包含各種加購費用與低消條款,排版相當繁瑣。
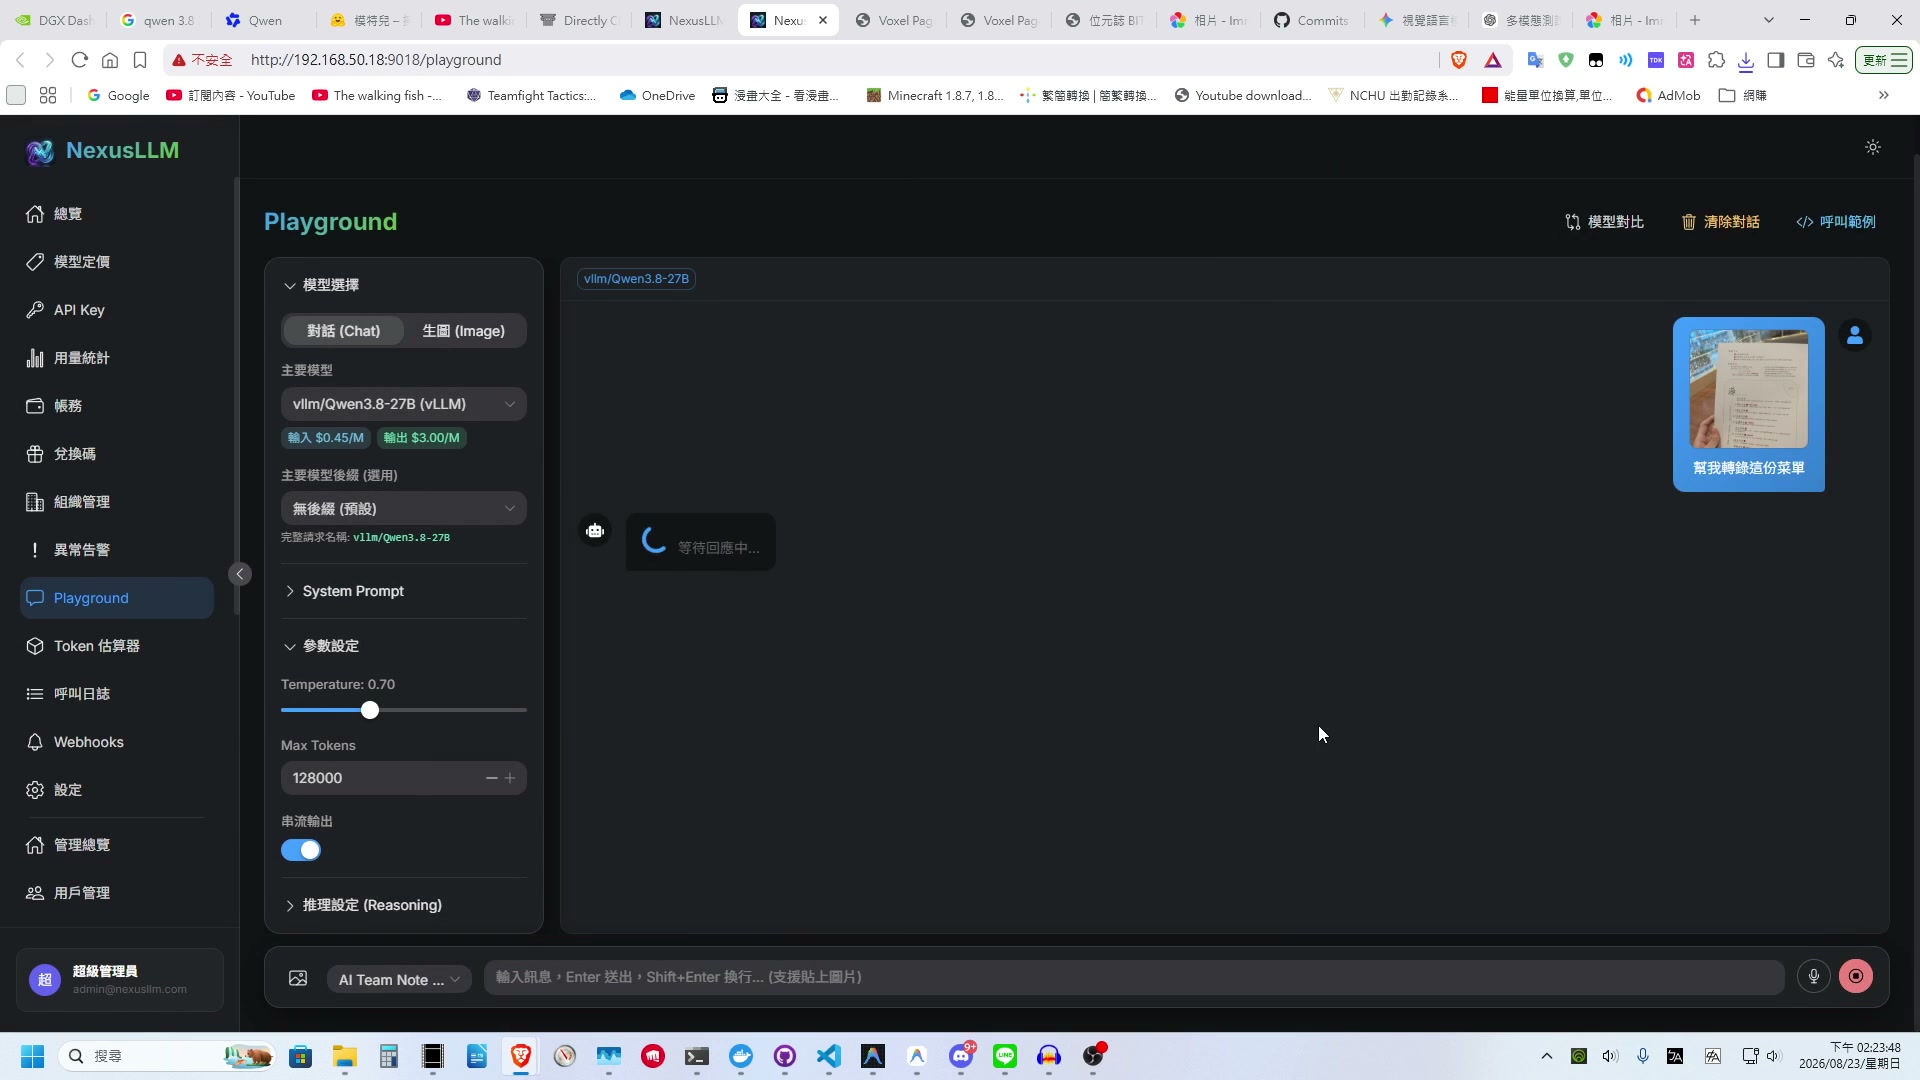
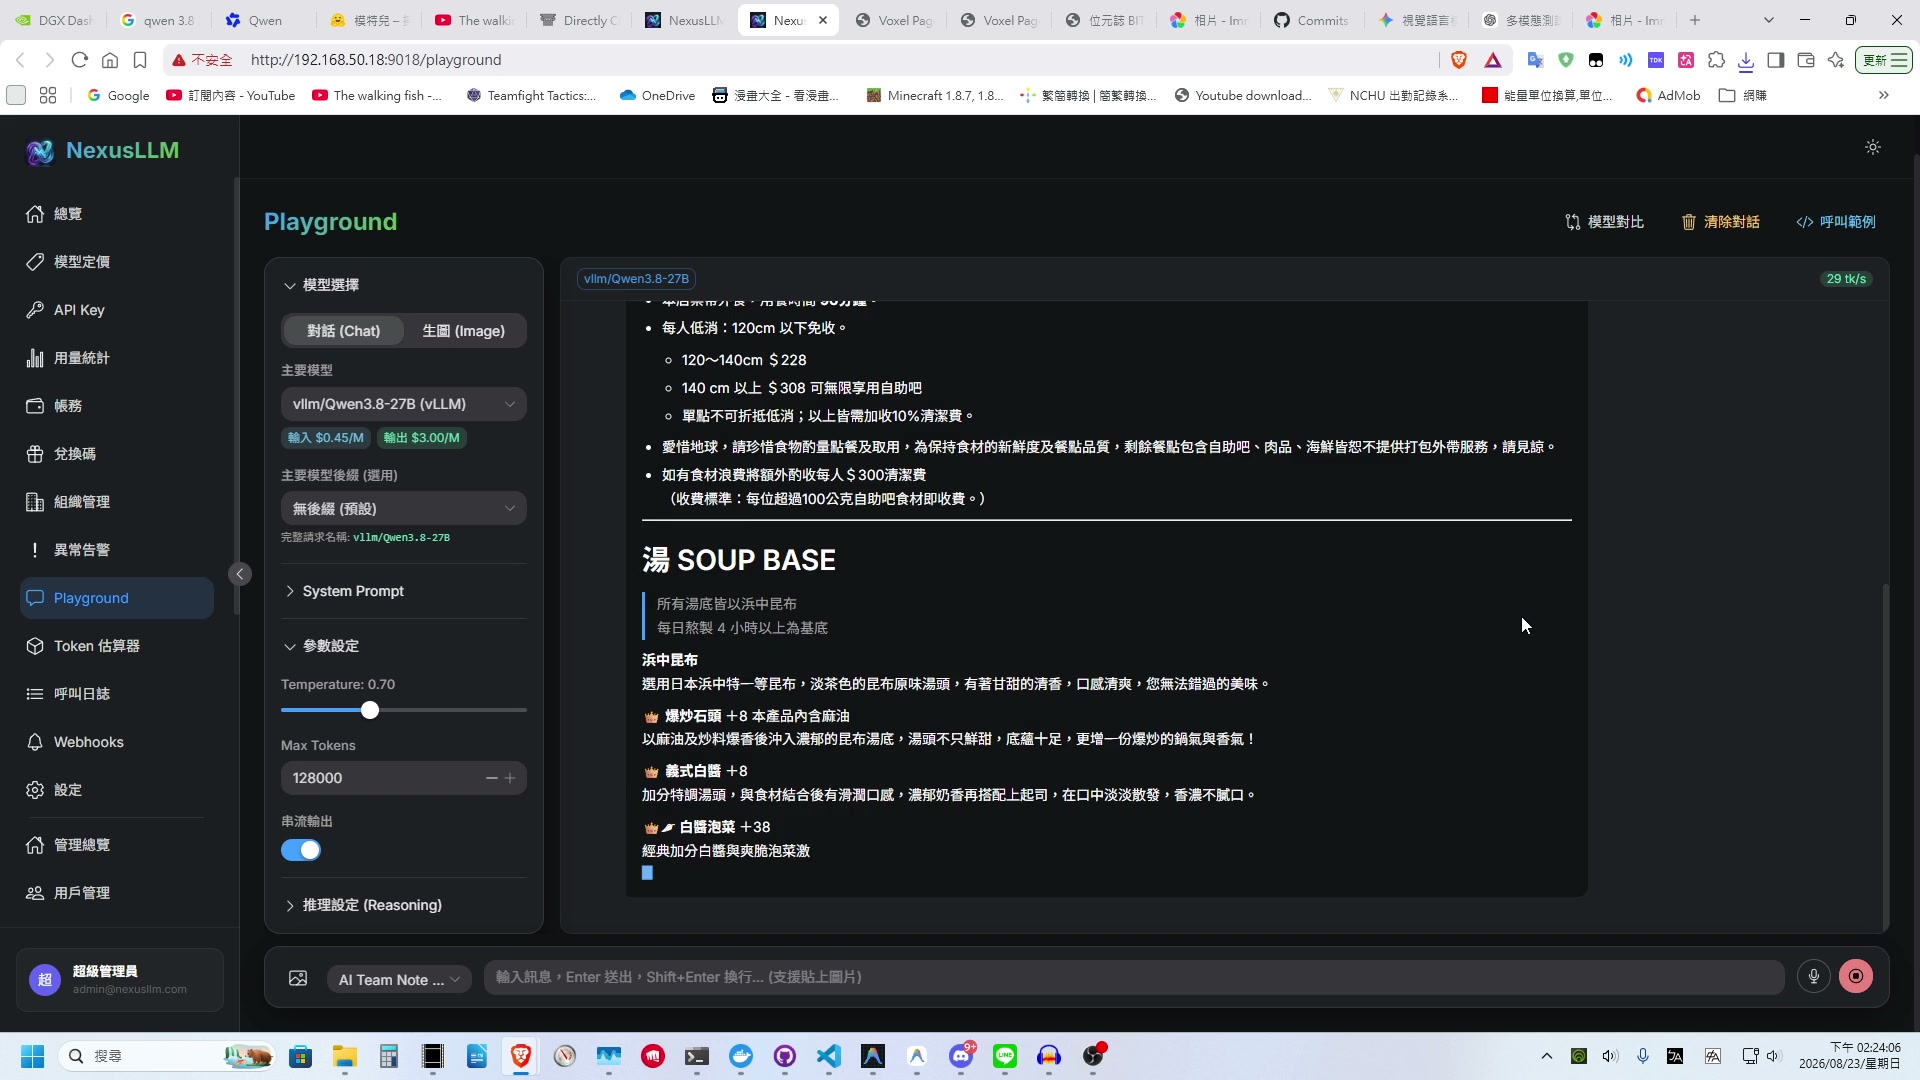
結果 Qwen 3.8-27B 轉錄得絲毫不差:
- 「湯 SOUP BASE」、「所有湯底皆以浜中昆布每日熬製 4 小時以上為基底」。
- 加價項目「爆炒石頭 +8」、「義式白醬 +8」、「白醬泡菜 +38」全部準確提取。
- 甚至連每人低消身高規範(120cm 以下免收、120~140cm $228、$308 清潔費)都一字不漏完整轉錄。
畢竟是中文原生大廠訓練出來的底模,千問對繁體中文與台灣餐飲菜單語境的理解能力確實無可挑剔。
真實專案實戰:從「動口不動手的軍師」到「親自動手寫 Code 的主力」
很多開源模型跑分很猛,但實際進到自己的真實專案裡卻根本不敢用。我自己平時在維護開源記帳專案(輕鬆記帳 Jijun)時,對這點體會特別深。
過去的無奈:Qwen 3.6 時代的分工瓶頸
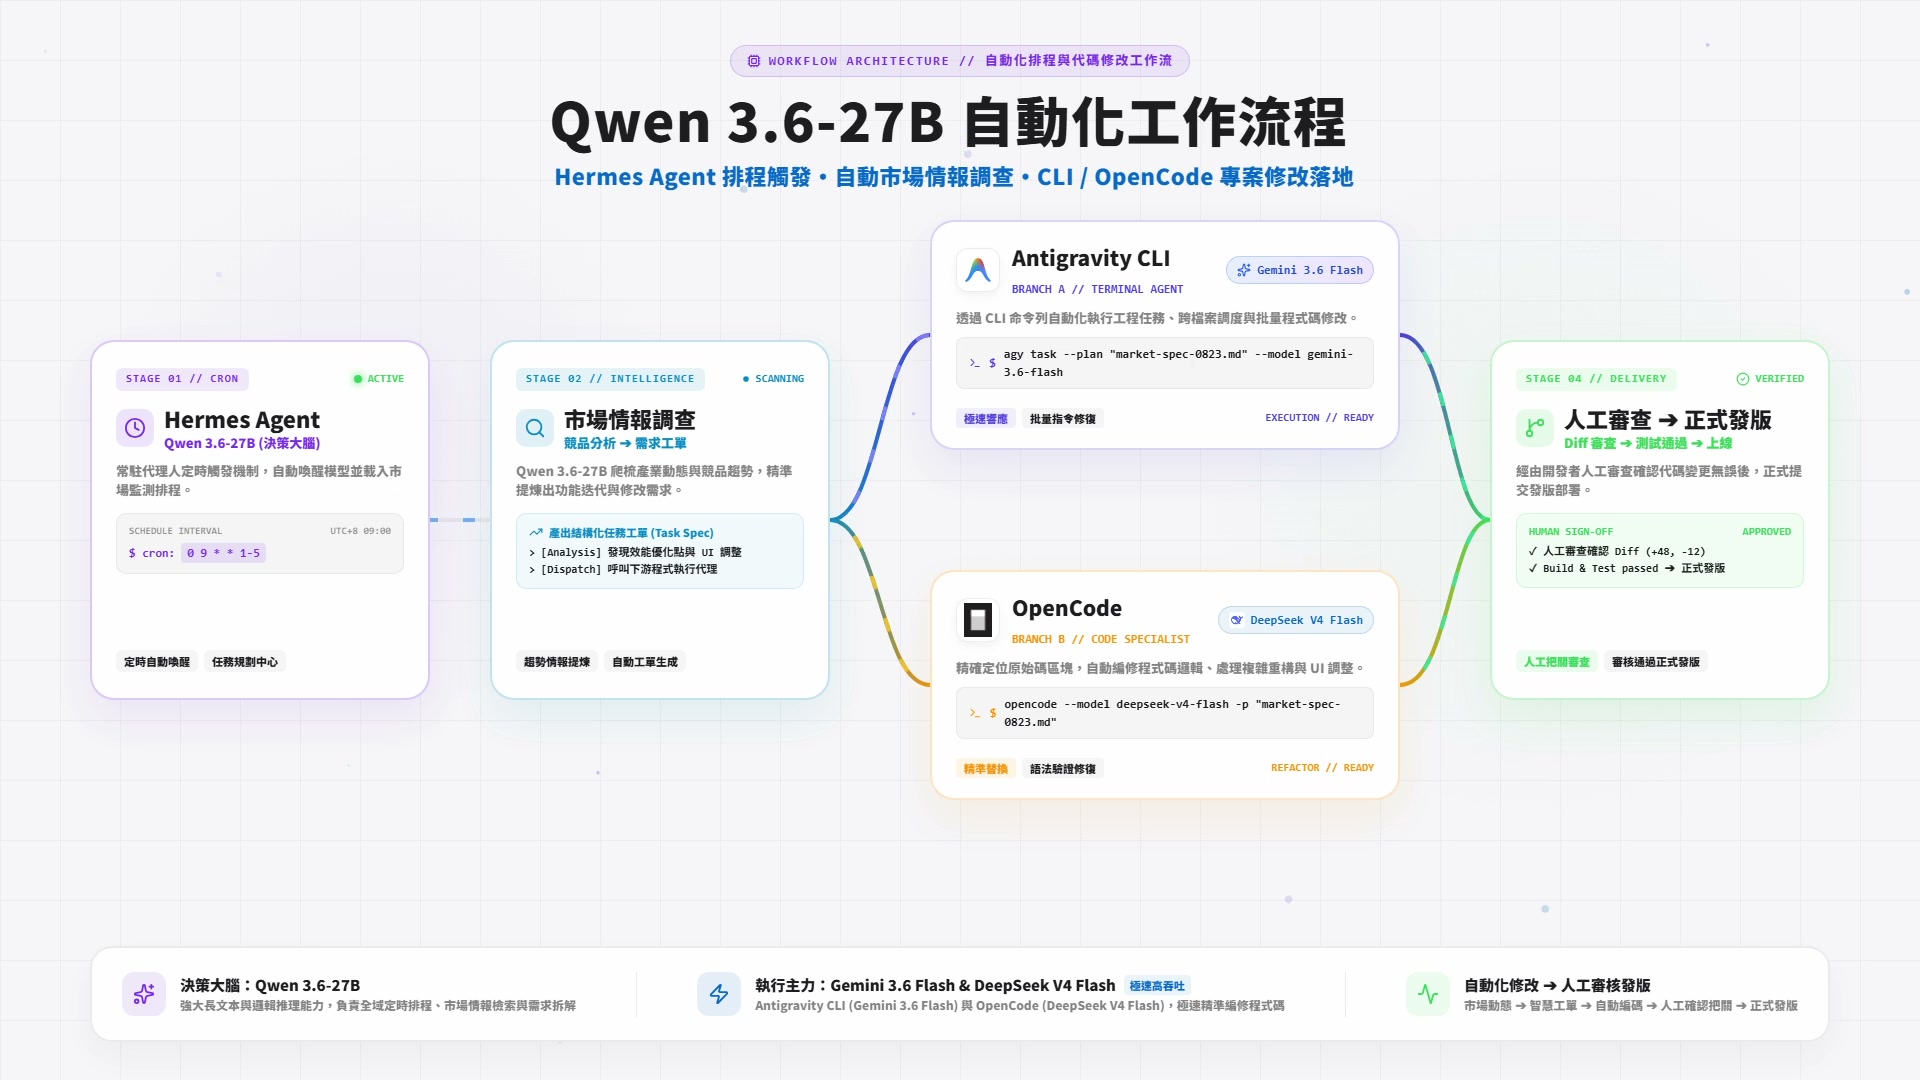
在 Qwen 3.6-27B 時代,它的代碼能力還不足以讓我放心把專案交給它直接改。我當時設計的自動化架構長這樣:
- Hermes Agent(Qwen 3.6 決策大腦):定時排程喚醒,負責爬取社群反饋與競品資訊,提煉出規格工單。
- 下游編程主力(Antigravity CLI / OpenCode):調用 Gemini 3.6 Flash 或 DeepSeek V4 Flash,由這兩家代碼能力極強的模型去讀取原始碼、找出函數並執行具體代碼修改。
- 人工審查發版。
當時 Qwen 3.6 頂多只能做做市場調研,或者調整幾行簡單的設定,真正要改複雜功能時,還是得靠其他頂級雲端模型去動刀。
現在的躍進:Qwen 3.8-27B 直接接管核心代碼編寫
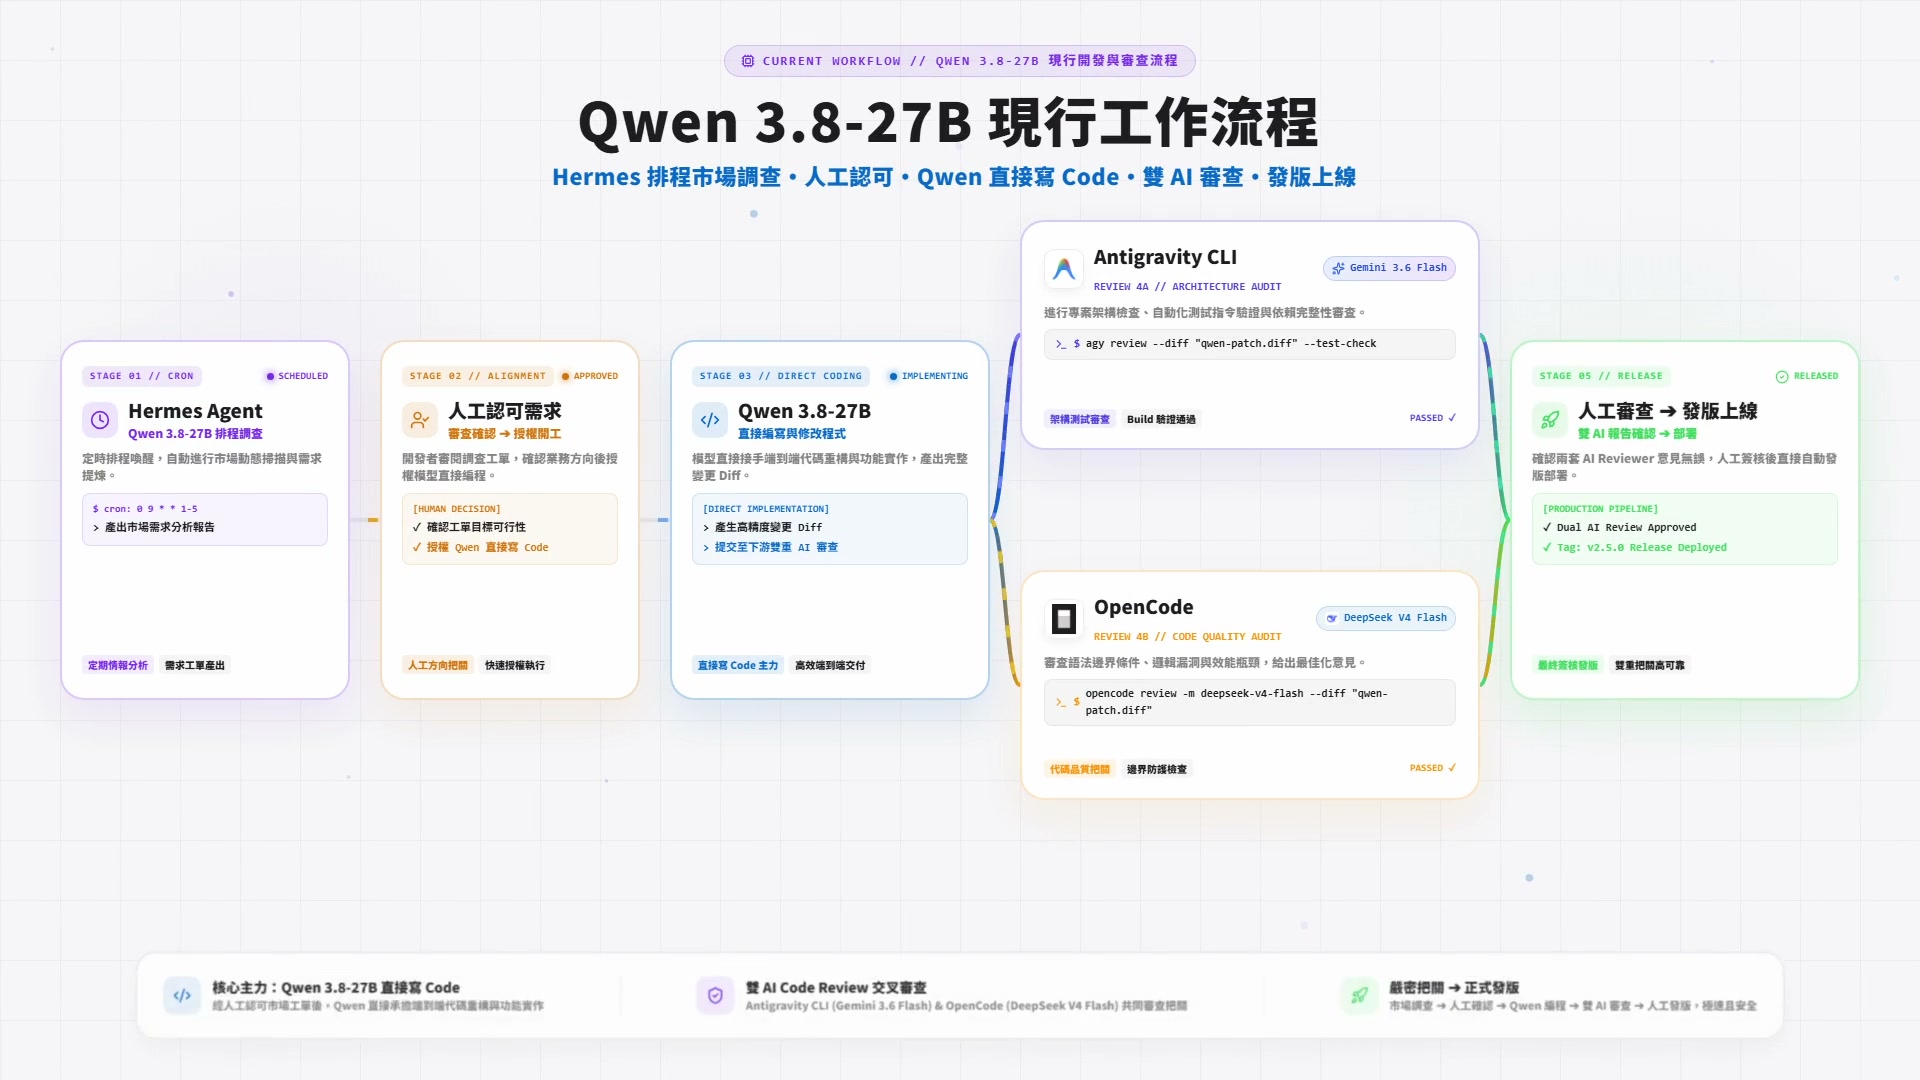
換上 Qwen 3.8-27B 之後,情況徹底改觀。我發現它在複雜專案中的理解力與代碼修改精度大幅提高,甚至已經足以直接勝任第一線的寫代碼主力!
我現在的日常開發流程已經進化成這套模式:
- Hermes Agent 排程調查:Qwen 3.8 定期喚醒並產出需求分析。
- 人工認可需求:我審查工單可行性後,一鍵授權放行。
- Qwen 3.8-27B 直接編寫代碼(Direct Implementation):模型直接端到端重構代碼,產生精確的 Git Patch Diff。
- 雙 AI Code Review 交叉審查:
- Antigravity CLI(調用 Gemini 3.6 Flash):負責架構檢查、自動化測試指令與相依性覆蓋。
- OpenCode(調用 DeepSeek V4 Flash):負責語法邊界條件、邏輯漏洞與效能瓶頸檢查。
- 人工確認後正式發版。
最近我的好幾個專案版本,都是直接讓 Qwen 3.8-27B 把代碼改完,再交給雙 AI 交叉審查,最後我自己過目一遍就直接發版。整個開發節奏明顯輕快了非常多。
狂暴的代價:動輒兩三萬 Token 的超長思維鏈
講了這麼多優點,也必須誠實講講 Qwen 3.8-27B 目前最大的缺點——它的思考過程(Thinking Tokens)實在是太長了!
只要遇到稍微複雜一點的題目,或者需要呼叫工具的 Agent 步驟,它的思考長度隨隨便便就能飆到 20K 甚至 30K Tokens!
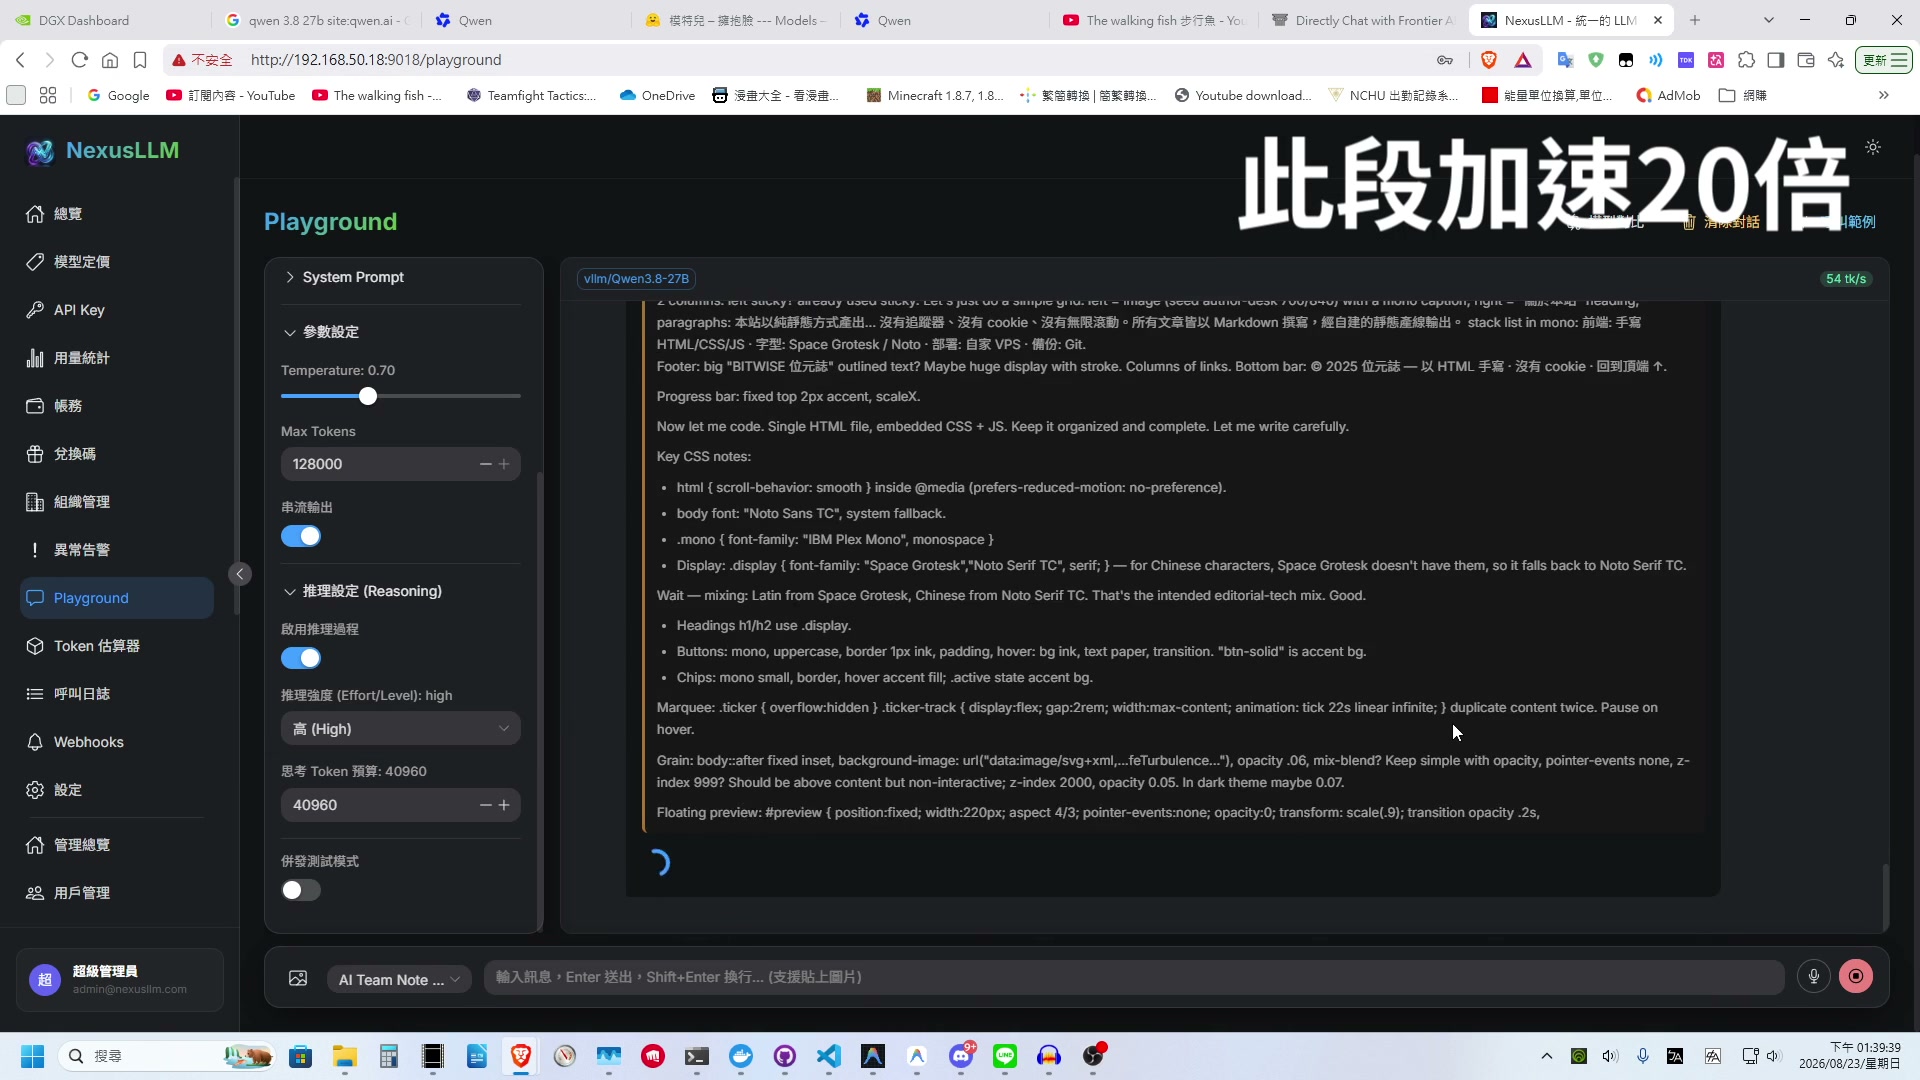
但換個角度想,這其實也是它能以 27B 的身材追平 Claude Opus 4.6 的根本原因:它用極端冗長的中間推理與自我反覆糾錯,硬生生把代碼的輸出品質拉拔到旗艦水準。
推理加速實測:MTP 預測接受率 95% 與神經刀 DFlash 2
在測試期間,我還發現了一個很有意思的現象:Qwen 3.8-27B 的實際推理速度,居然比 3.6 版快上不少!
前面說過它架構沒變,那這個速度差是哪裡來的?
答案就在 MTP(Multi-Token Prediction,多標記預測) 的預測命中率!
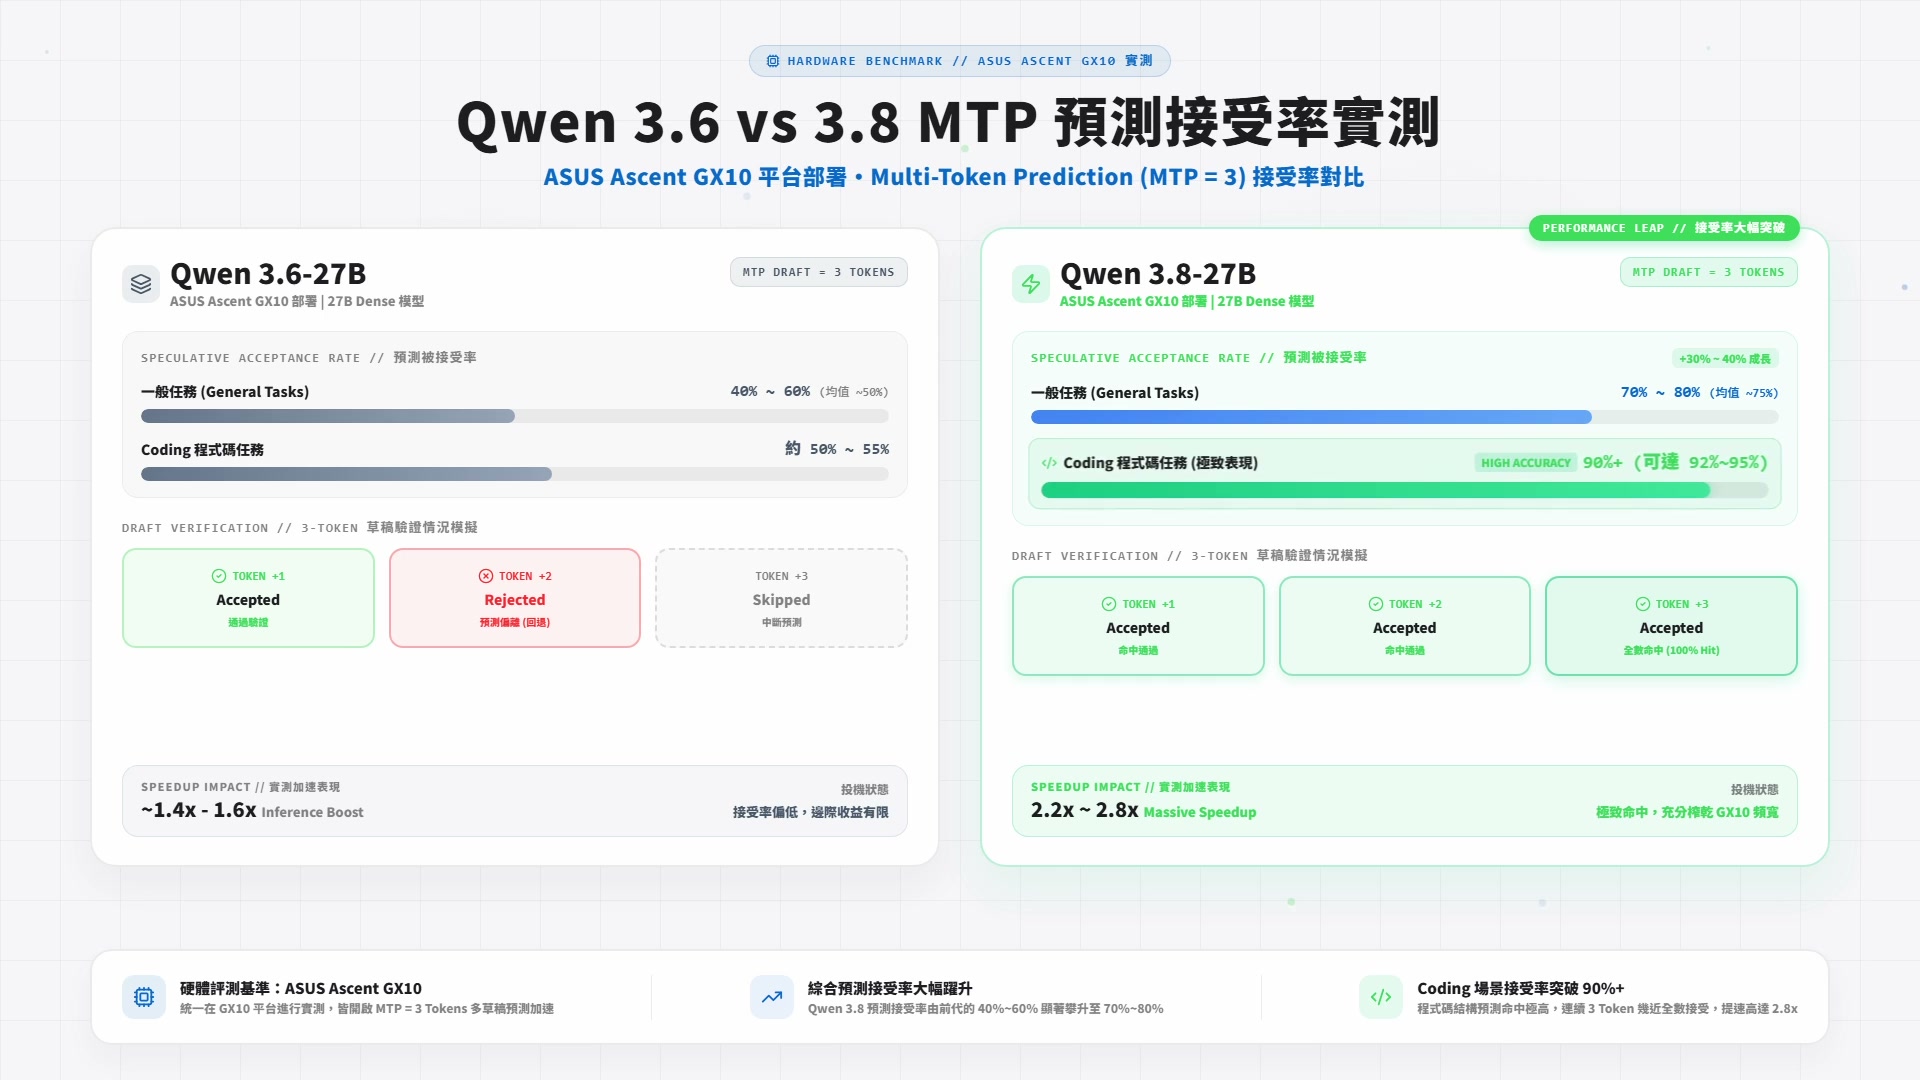
MTP 接受率實機對比(ASUS Ascent GX10 平台)
我在 ASUS Ascent GX10 上部署 FP8 版本,並開啟 MTP = 3 Tokens 投機預測:
- 一般任務(General Tasks):
- Qwen 3.6-27B 的 MTP 接受率大概落在 40% ~ 60%(均值約 50%),實際提速大約只有 1.4x ~ 1.6x。
- Qwen 3.8-27B 的接受率直接躍升至 70% ~ 80%(均值約 75%),提速達到 2.2x。
- 程式碼任務(Coding):
- 在寫程式這種語法結構嚴謹的場景下,Qwen 3.8-27B 展現出極為誇張的預測準度——連續 3 個草稿 Token 的接受率竟然能達到 90% 甚至 95%!
- 幾乎所有投機草稿全數命中,單機推理速度直接衝上 20 ~ 30+ Tokens/s,相當於速度硬生生翻了接近 3 倍!這點絕對是意外之喜。
如果進一步切換成 NVFP4 量化版,雖然節省了記憶體頻寬,但因為量化輕微削弱了 MTP 預測接受率,整體平均推理速度也是穩定落在 30 Tokens/s 左右。
DFlash 2 實測心得:快時神經刀,慢時不如不開
我也順便測試了 Hugging Face 上社群很夯的投機加速方案 DFlash 2(z-lab/Qwen3.8-27B-DFlash2)。
DFlash 2 採用一次預測 7 個 Token 的激進策略,官方基準跑分在單一請求下聲稱能帶來最高 3.43 倍的吞吐量提升:
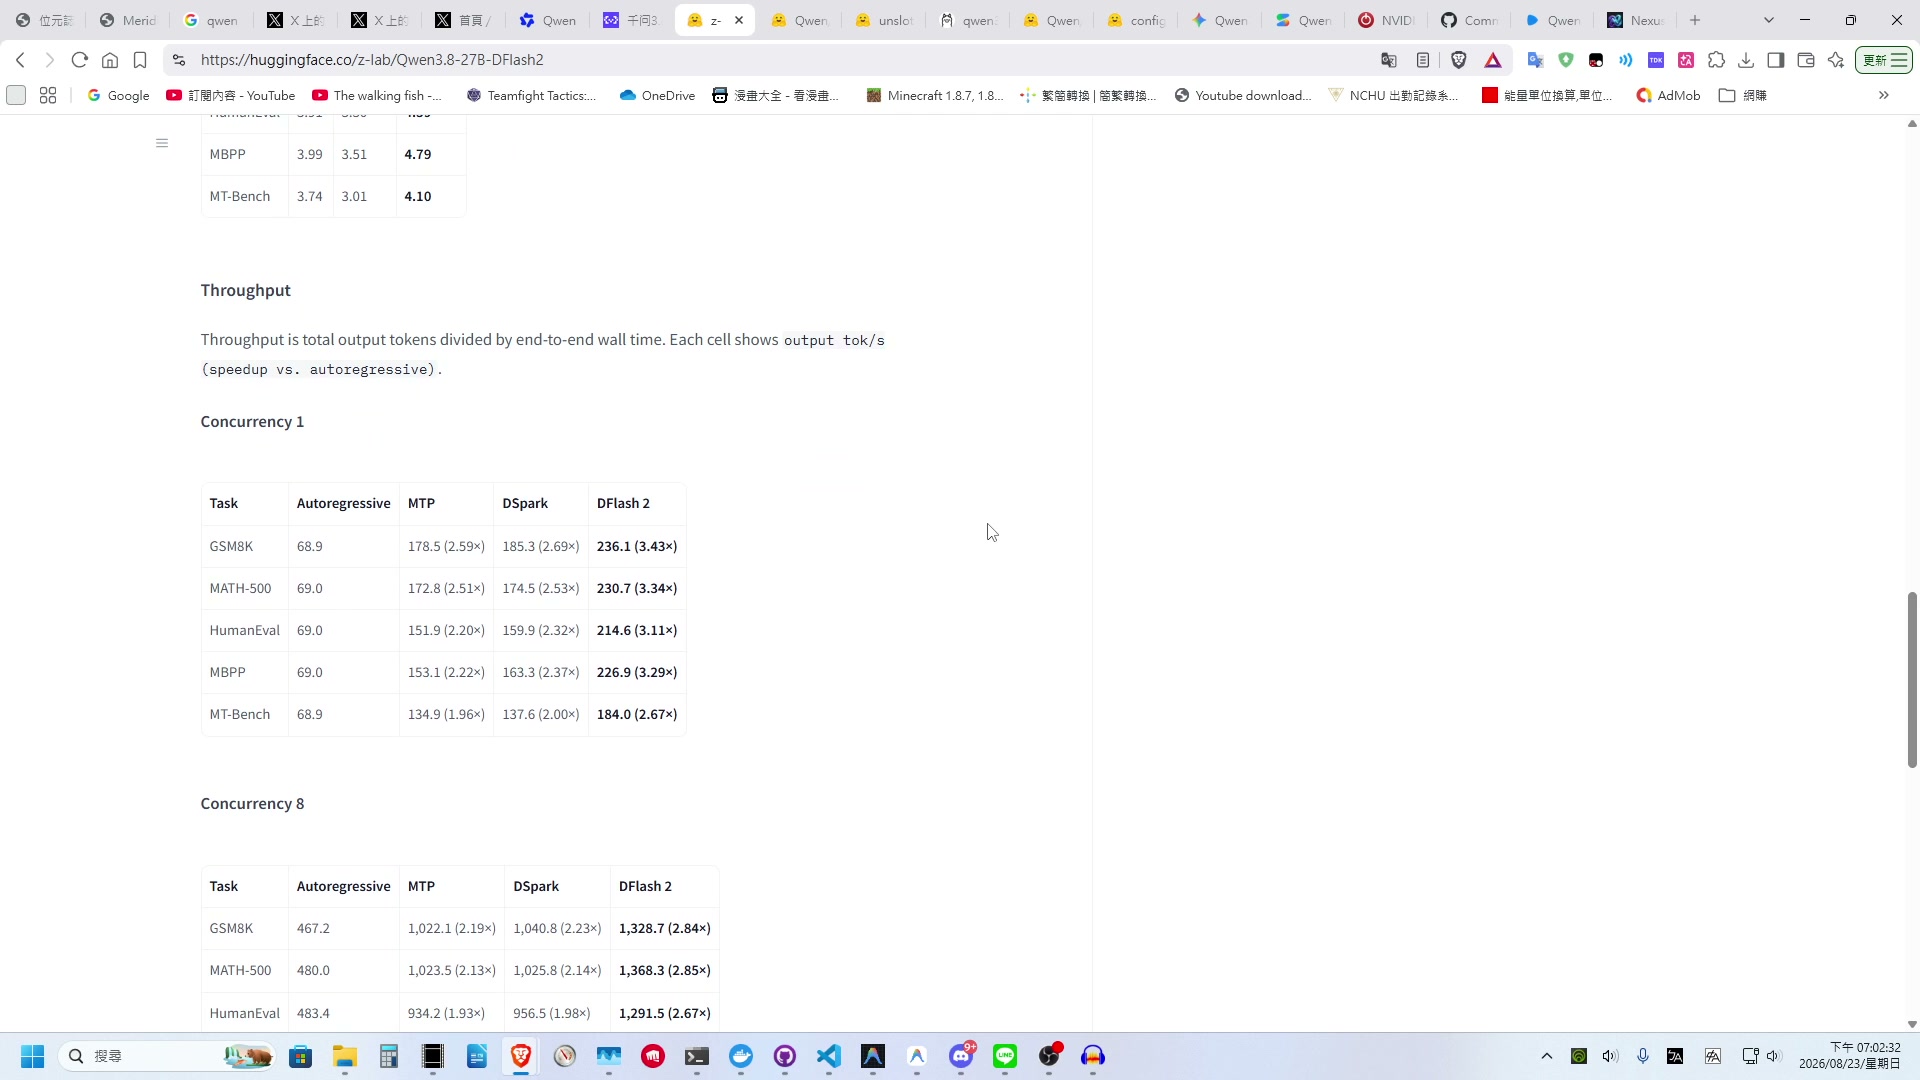
但在我自己實機測試下來,DFlash 2 的表現真的非常「神經刀」:
- 接受率大起大落:順的時候速度確實可以飆到接近 60 Tokens/s;但不順的時候接受率低到可憐,速度反而比完全不開加速還要慢。
- 並發高時嚴重卡頓:一旦稍微給點並發請求,模型運行到一半就會突然整個卡住幾秒甚至幾十秒,隨後才繼續吐字。推測是 DFlash 小模型與主模型在爭搶記憶體頻寬與計算資源導致的。
現階段如果要求穩定的日常生產力,原生的 MTP 方案依然是兼顧穩定度與顯著提速的最佳解法。
結語:開源小模型的新里程碑
總體實測下來,Qwen 3.8-27B 絕對是近期開源大模型界最令人振奮的一款產品。
它證明了開源模型不需要盲目堆疊參數量到幾百 B,只要透過高質量的後訓練、精準的強化學習以及足夠深度的思維鏈,哪怕只有 27B,也完全能在程式開發、Agent 工具調度與前端設計等關鍵生產力領域,與昂貴且封閉的頂規旗艦模型正面抗衡。
如果你手上正好有一台具備 24GB 以上 VRAM 的設備,非常推薦大家親自把它部署起來玩玩看。無論是作為本地個人 Agent 的大腦,還是拿來改專案程式碼,它帶來的生產力提升絕對會讓你大開眼界!