最近 AI 圈子很熱鬧,雖然大家都在玩那隻一直改名字的龍蝦,但網路上各種教學已經很多了,所以這週我不打算蹭這個熱度。
今天想跟大家介紹的是一個最近發現的專案:HeartMuLa。這是一個完全開源的歌曲生成模型,不管是程式碼還是權重都採用 Apache 2.0 協議。最重要的是,它解決了以往開源音樂模型「要嘛硬體需求高不可攀,要嘛生成品質慘不忍睹」的痛點。
為什麼要關注 HeartMuLa?
提到 AI 音樂生成,大家第一時間想到的肯定是 Suno 或 Udio。這些商業閉源方案雖然強大,但畢竟需要付費且依賴雲端。而 HeartMuLa 的出現,讓在家用電腦上跑出高品質音樂成為可能。
1. 親民的硬體需求
它的模型大小僅有 3B。這意味著什麼?只要你的顯卡擁有 8GB 到 12GB 的 VRAM,基本上就能在本機順暢運行。這對於大多數擁有中階顯卡的玩家來說,是一個巨大的福音。
2. 媲美 Suno 的品質
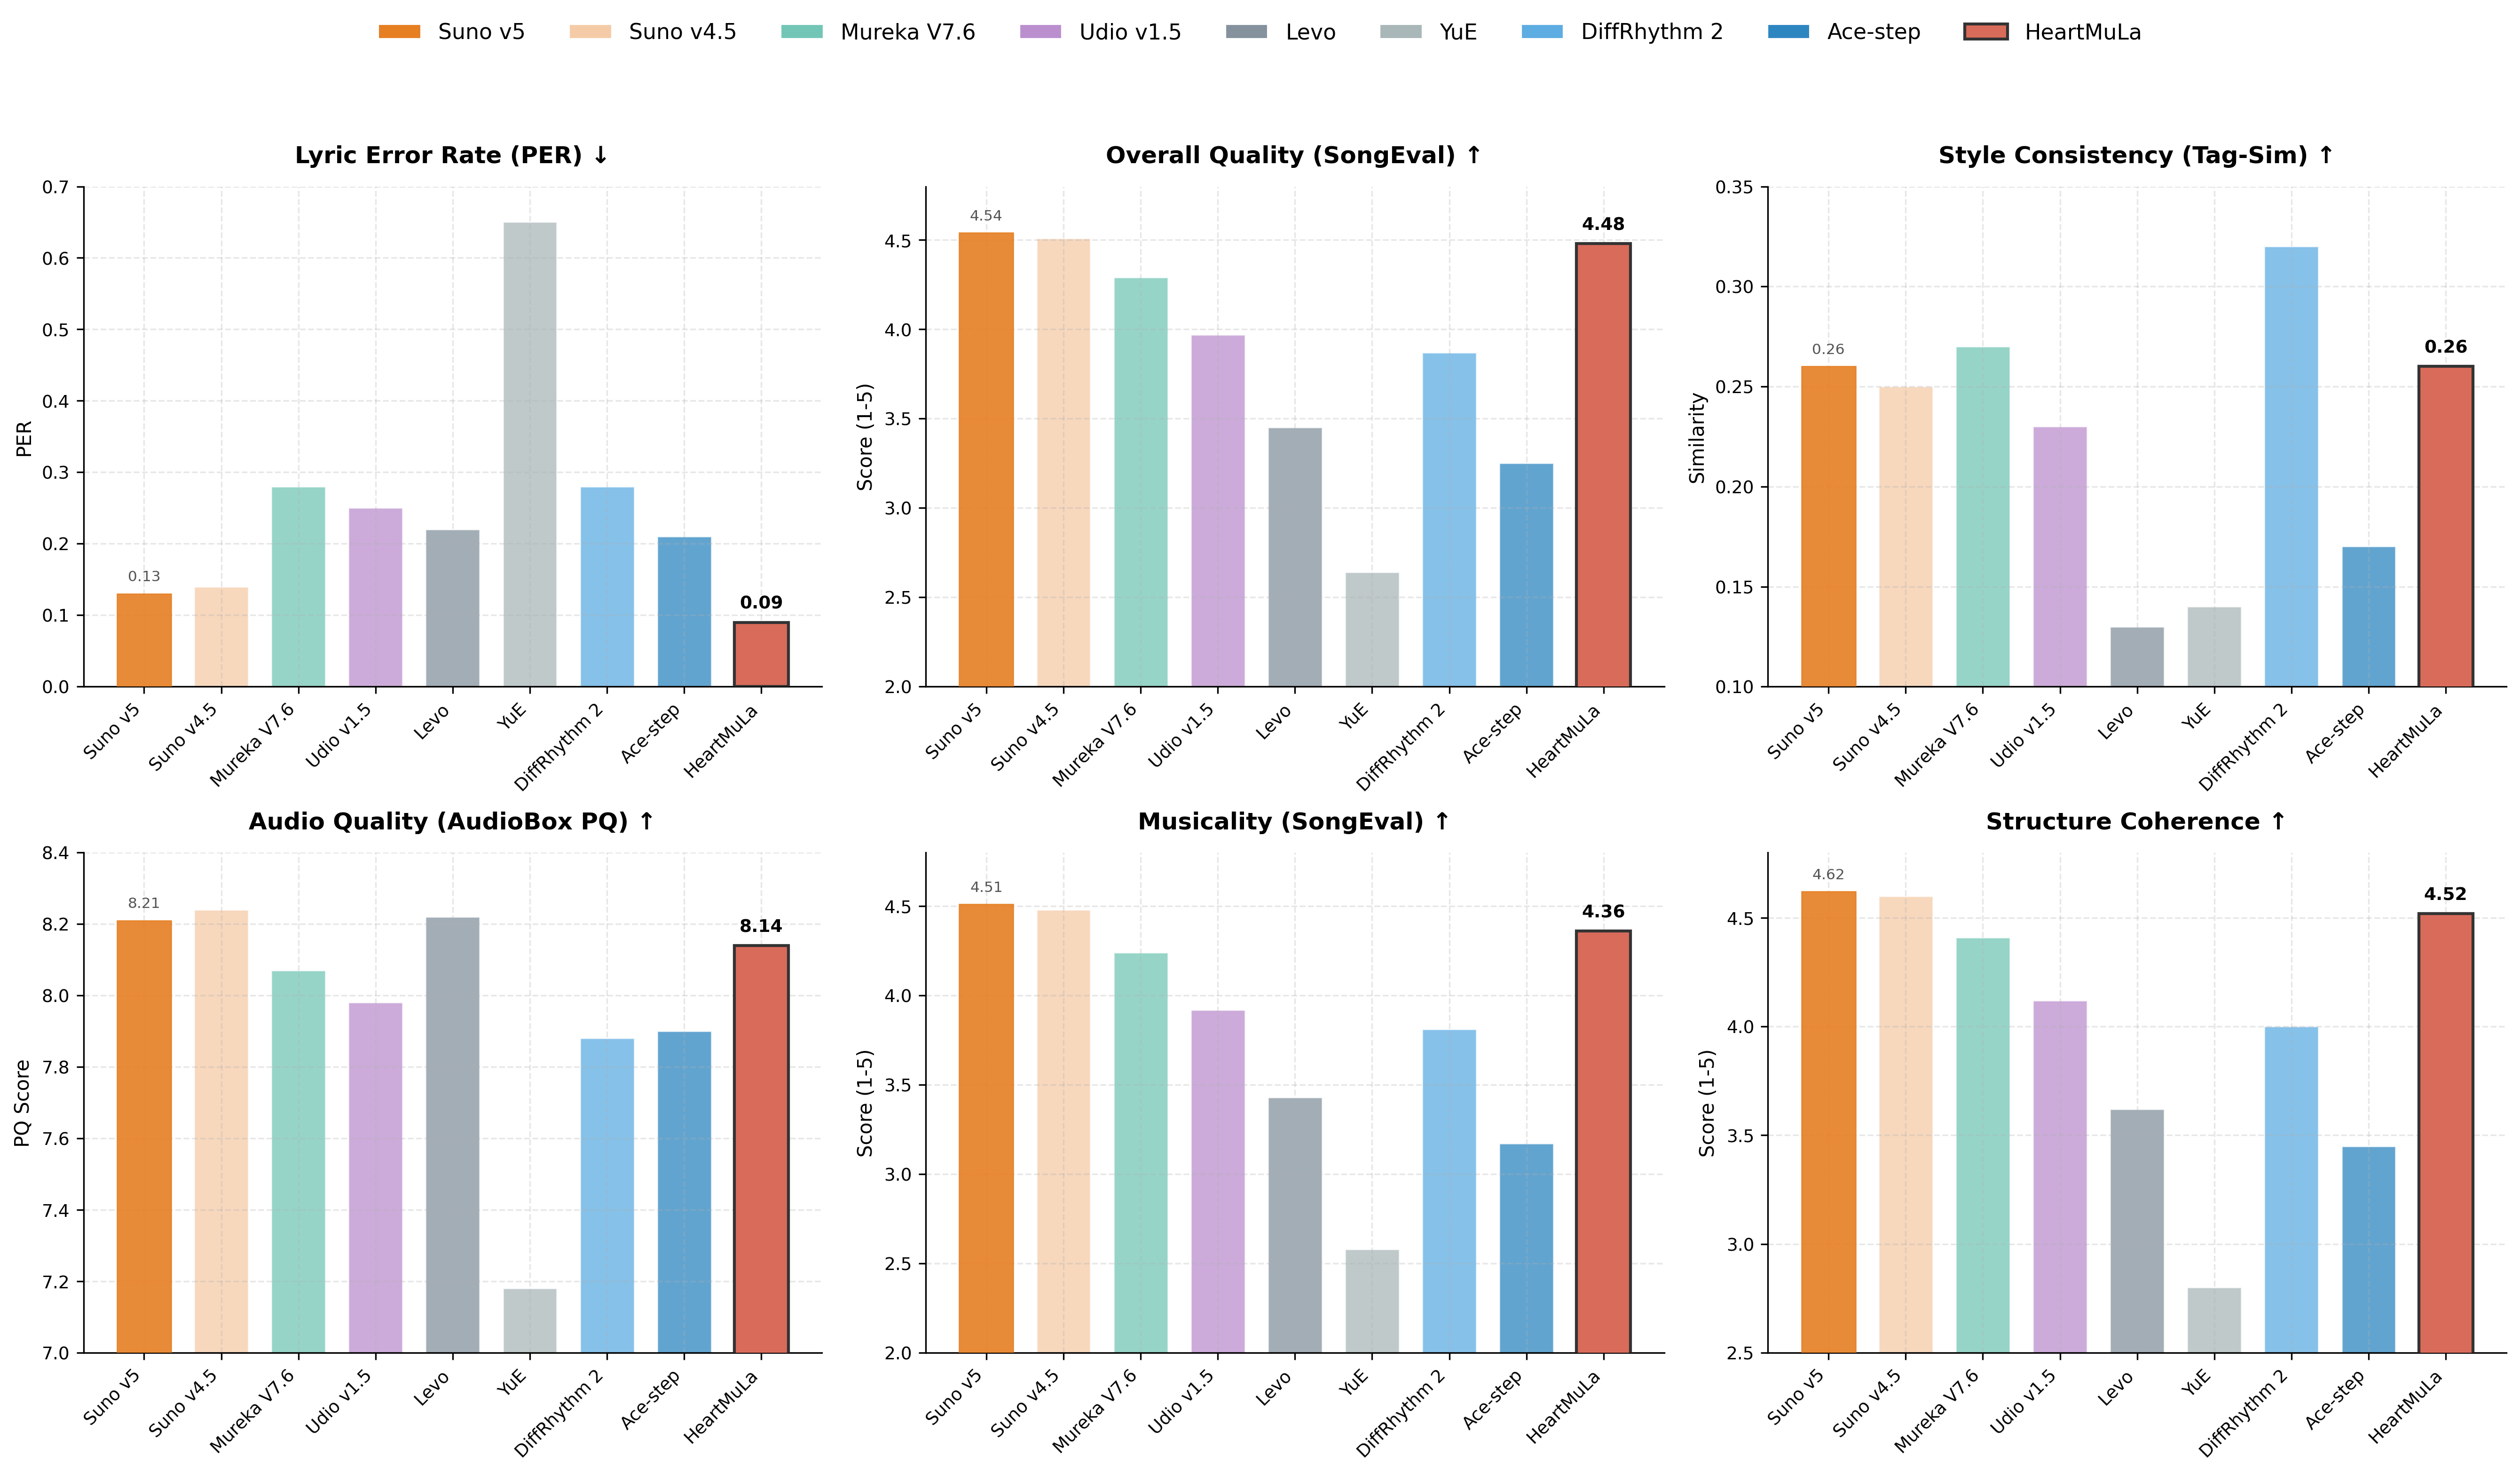
根據開發團隊的說法,HeartMuLa 最新的模型品質可與 Suno 媲美。它支援常見的 英文、中文、日文 等語言歌詞。
根據官方提供的資料,它念錯歌詞的比率甚至比 Suno V5 還要低!整體的音樂性我個人測試下來也相當不錯。
3. 高效率的生成架構
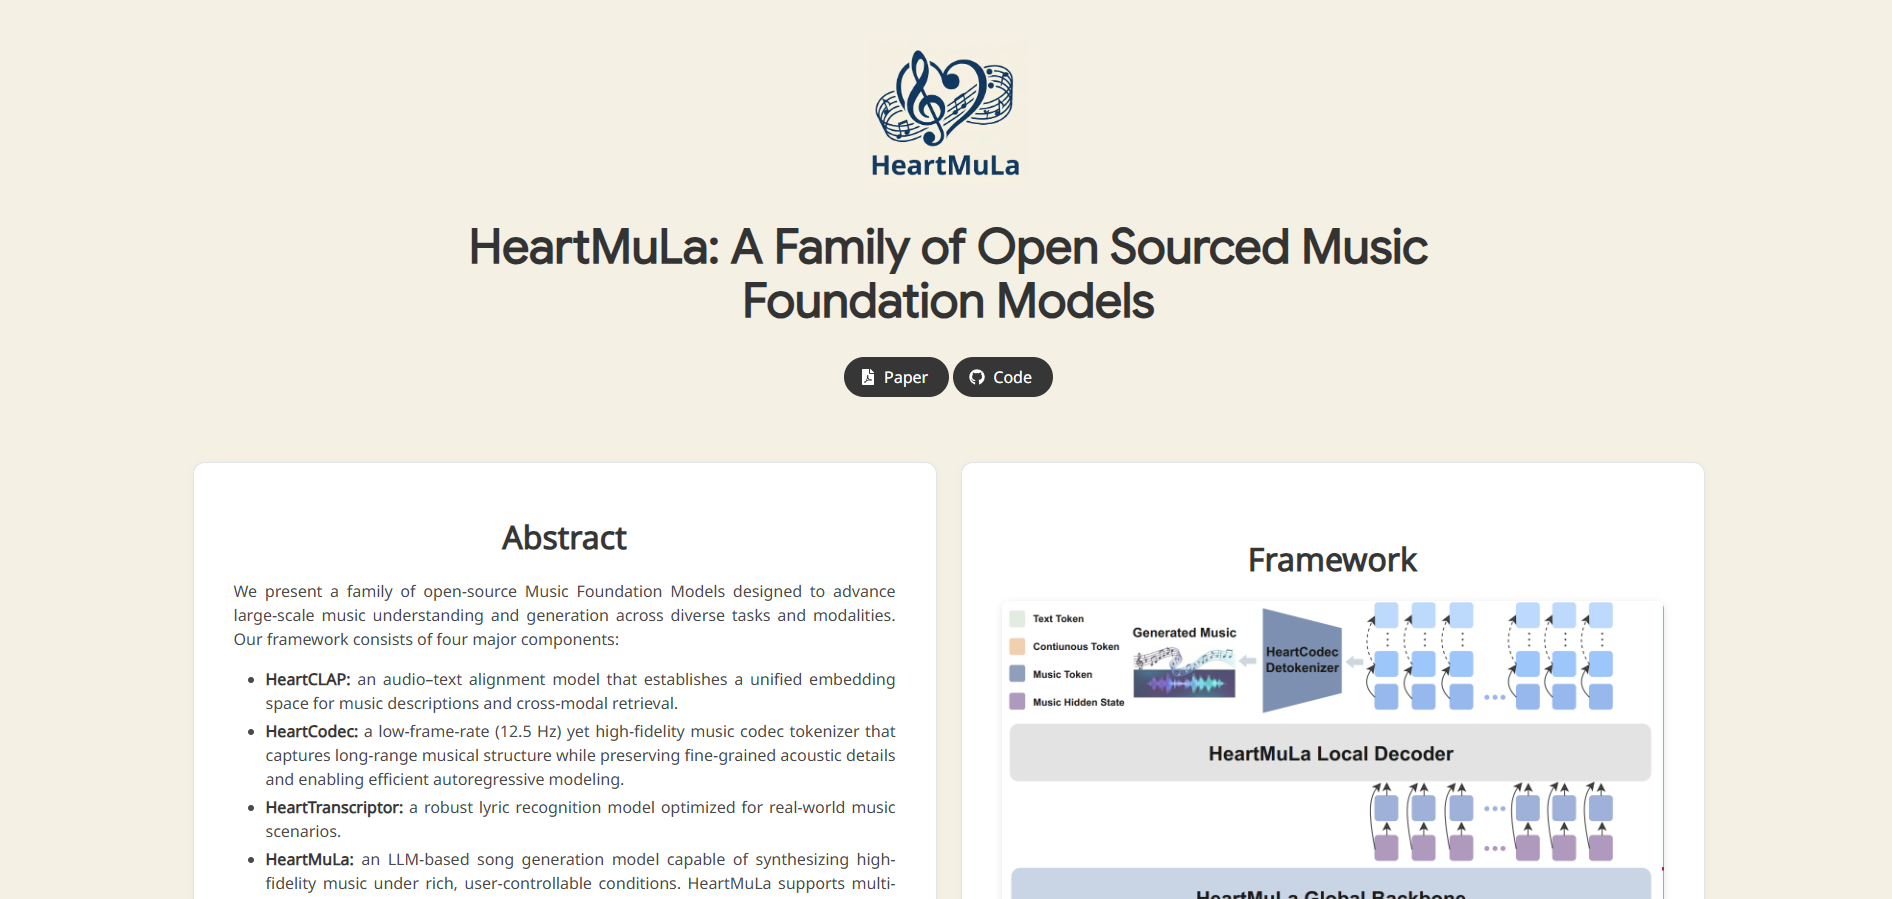
HeartMuLa 使用了 Llama 3.2 的架構,並訓練了一套超高效率的音訊編解碼模型。
- 傳統模型:通常需要 25Hz 或 50Hz 的 Frame Rate 才能還原細節。
- HeartMuLa:僅需 12.5Hz 就能還原豐富細節。
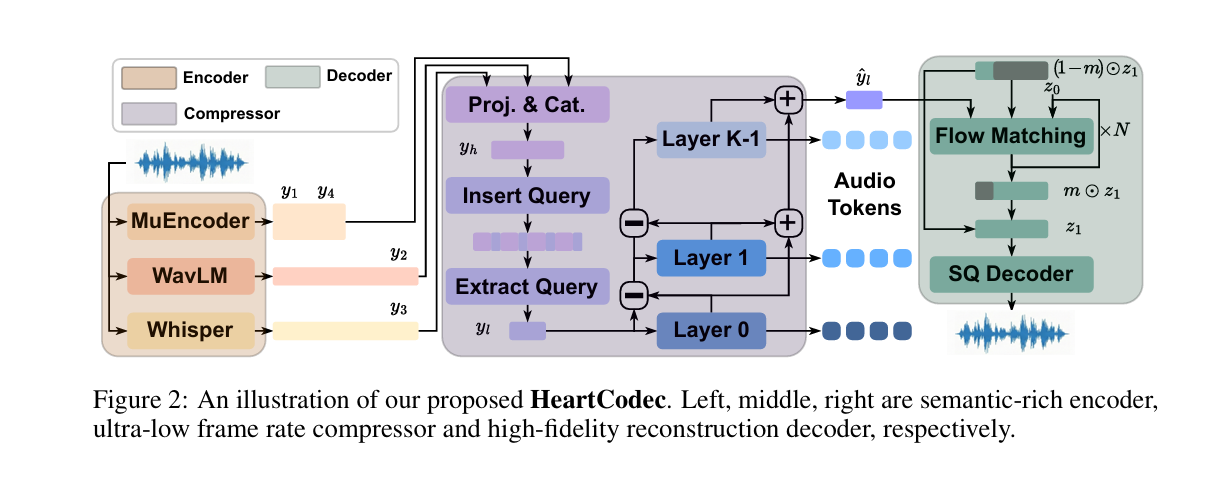
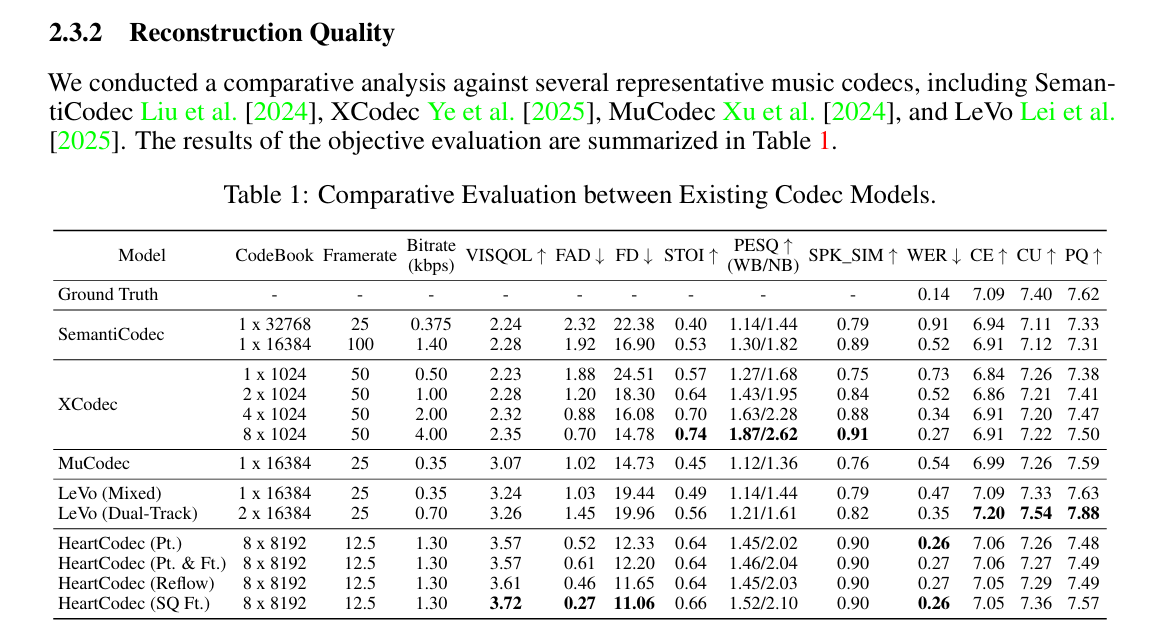
這讓生成速度大幅提升。以我的 RTX 4070 Super 為例,生成一首 4 分鐘的歌曲,大約只需要 10~11 分鐘(約音樂長度的 2.5~3 倍時間)。
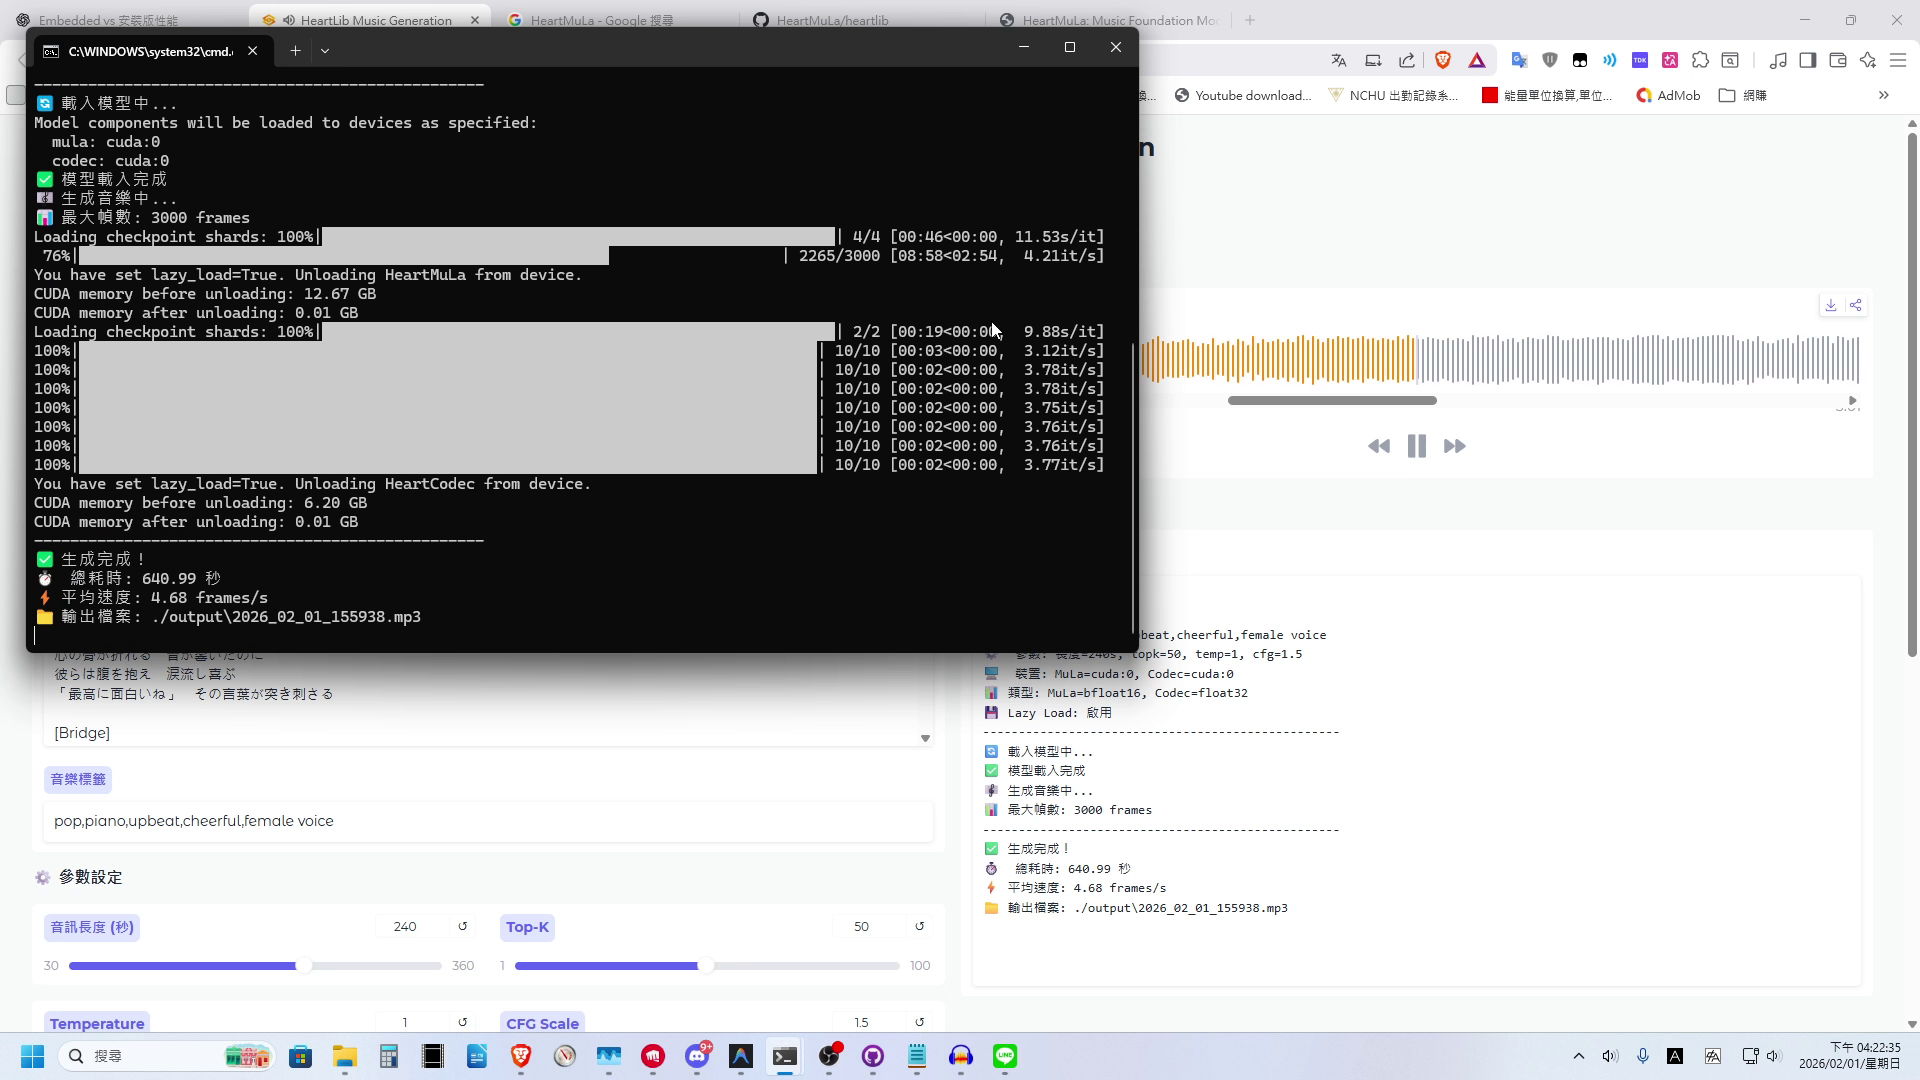
本機部署: 自製一鍵安裝懶人包
雖然 HeartMuLa 很棒,但目前的安裝方式對一般使用者來說非常不友善:
- 官方 Repo:沒有 UI 介面,需要手動修改 TXT 檔填入歌詞和標籤,再用指令生成,非常麻煩。
- ComfyUI 節點:雖然有介面,但在 Windows 上安裝環境極其痛苦。你需要手動處理 PyTorch 的 GPU 版本、FlashAttention、Triton 等組件,這些在 Windows 上都很難自動裝好。
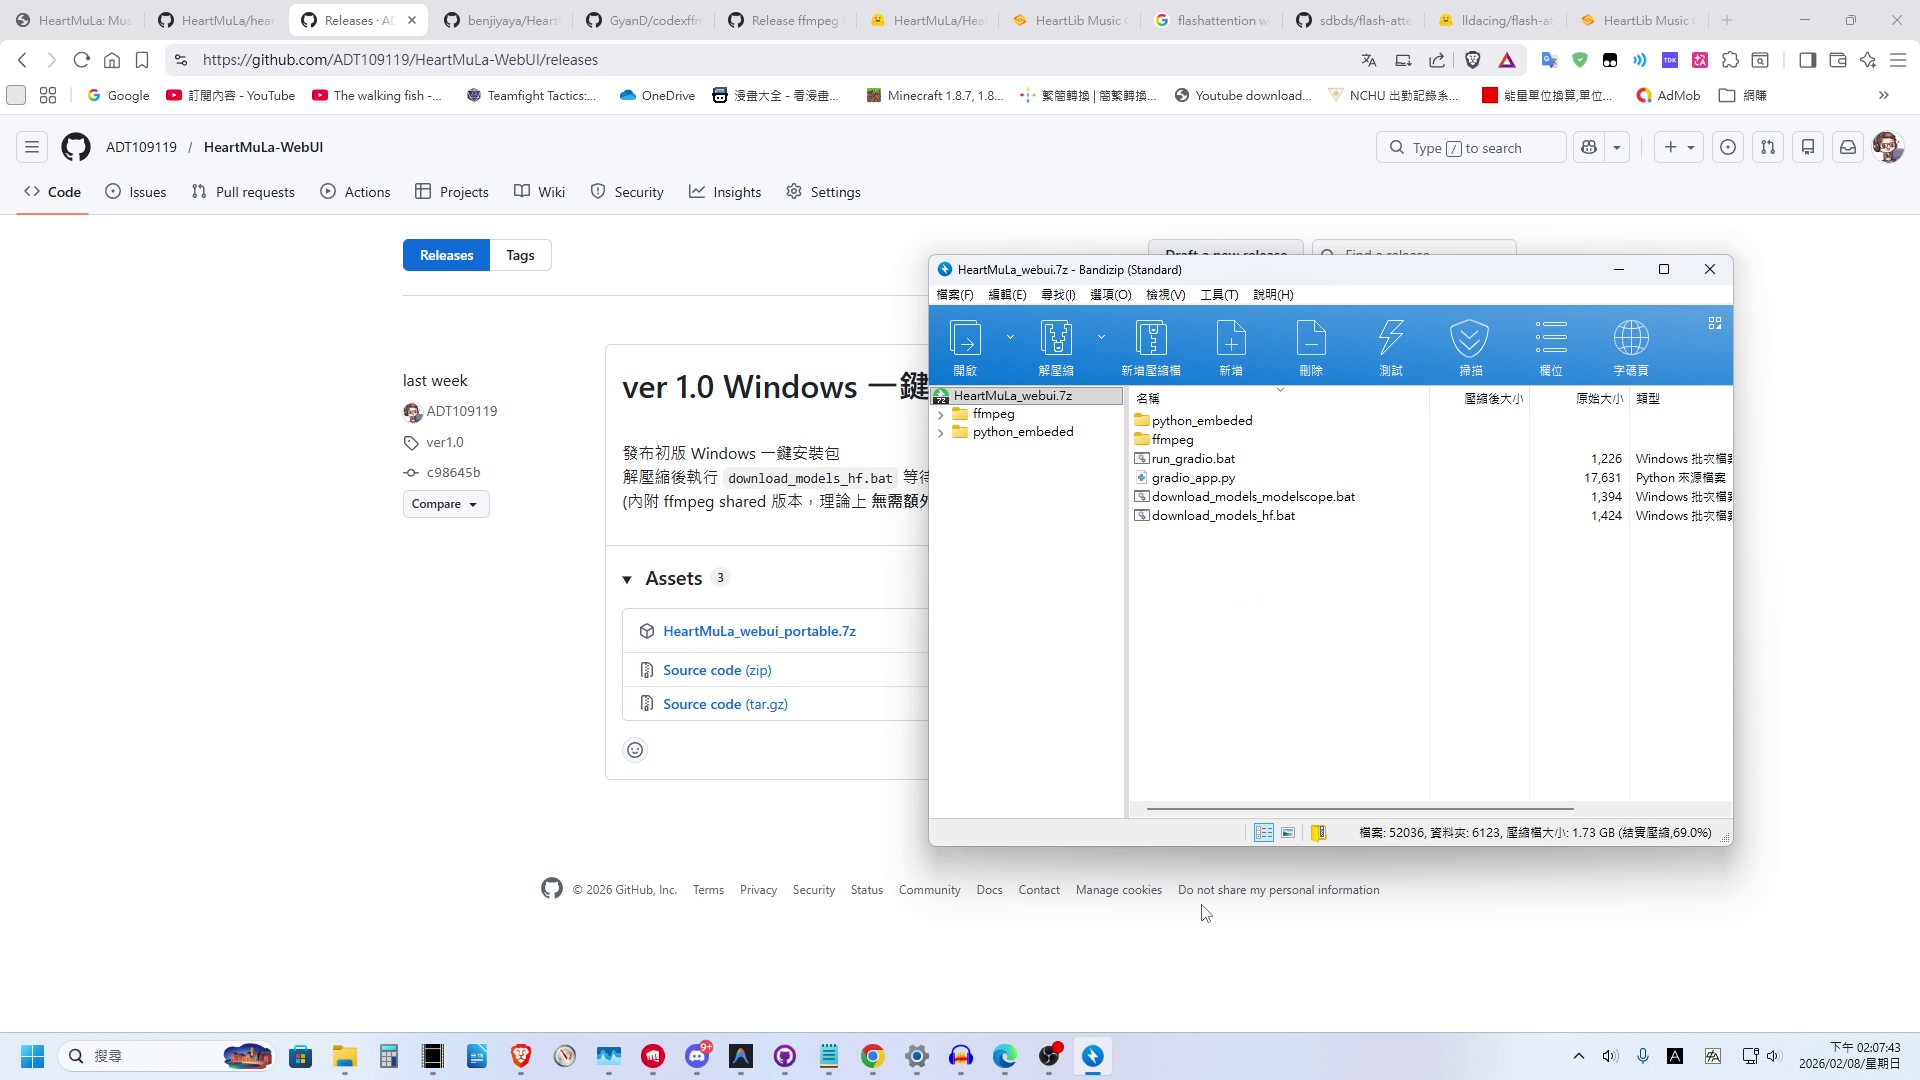
為了讓大家能輕鬆體驗,我稍微「偷懶」了一下,直接幫大家製作了一個 整合 WebUI 的一鍵安裝包!
使用教學
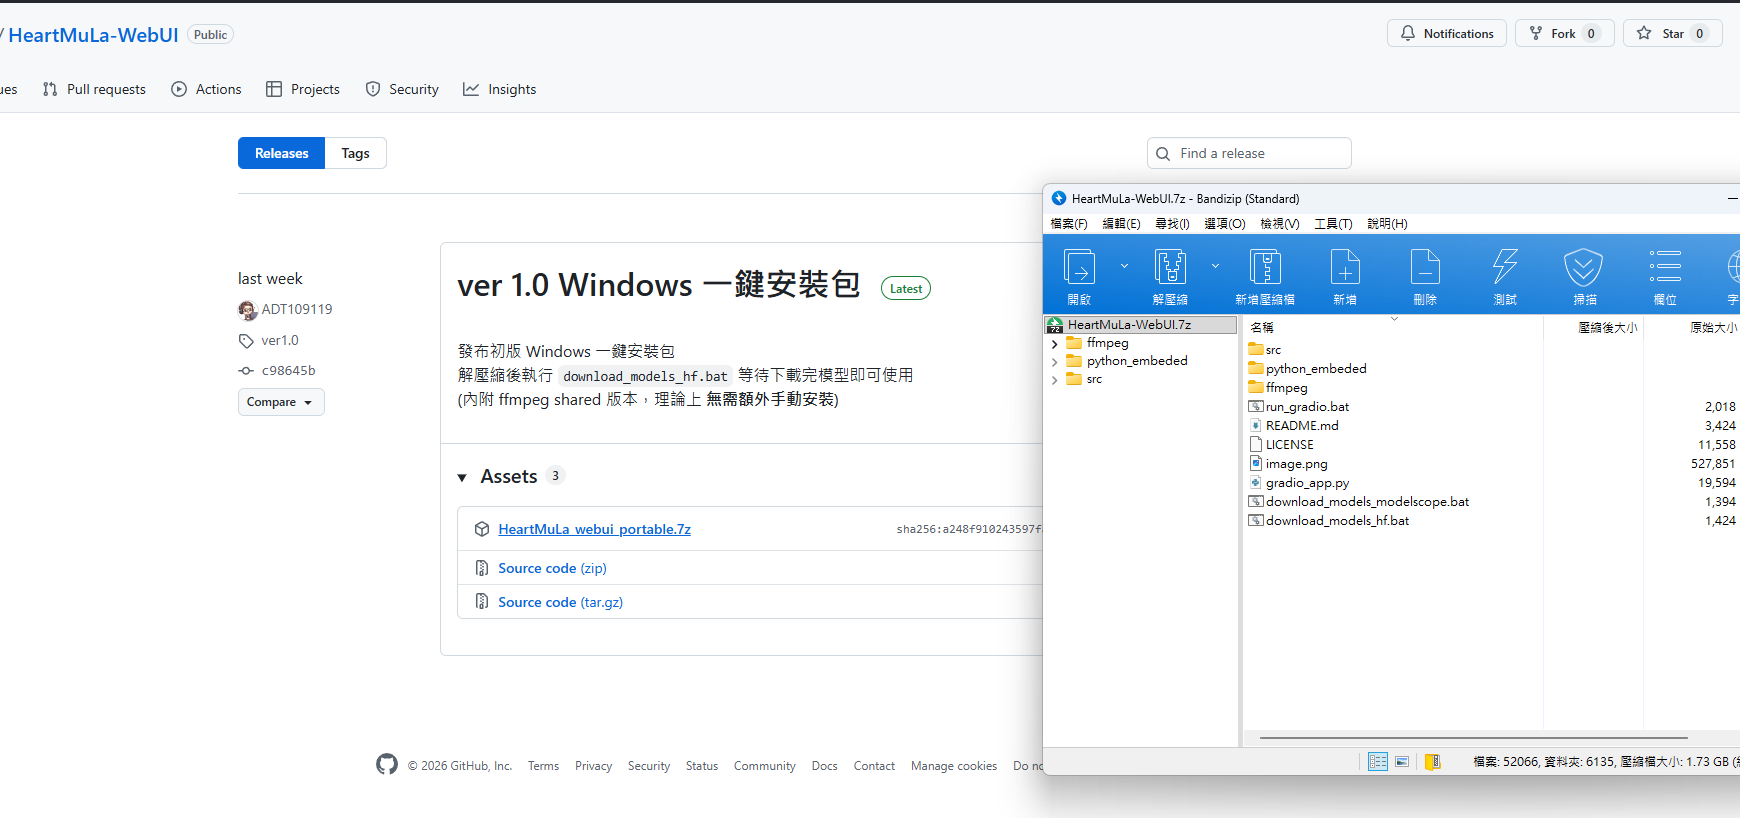
- 下載並解壓縮:下載我提供的懶人包,並將其解壓縮。
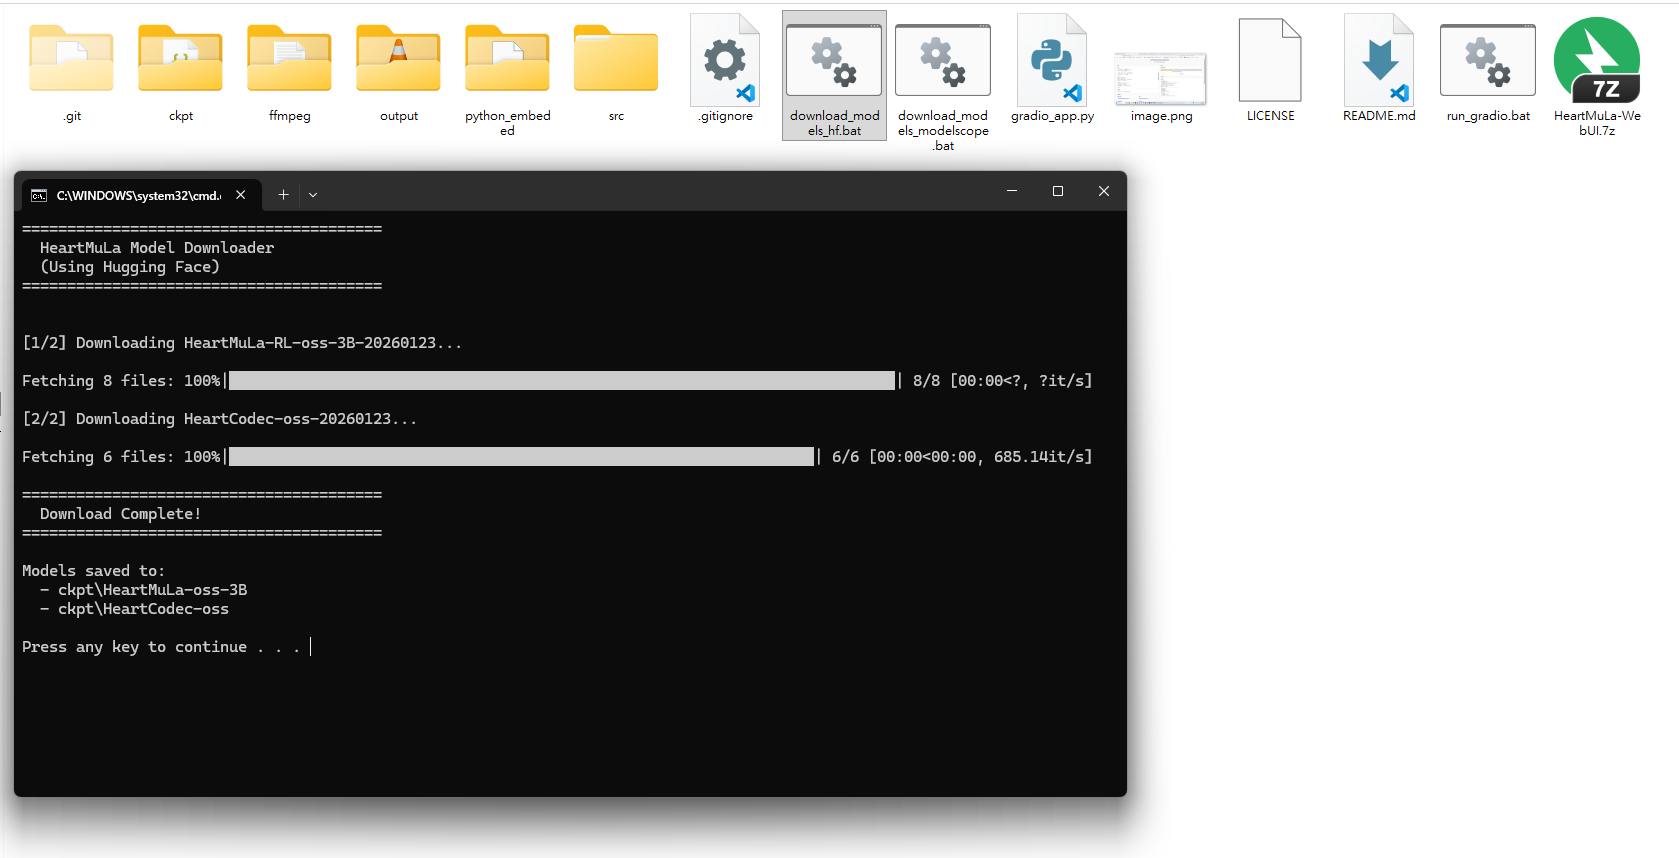
- 下載模型:下載完解壓縮後,先執行
download_models_hf.bat下載模型(因為官方有提供 ModelScope,我也整合進去了)。
- 啟動程式:等待模型下載完成後,點擊
run_gradio.bat啟動 WebUI。
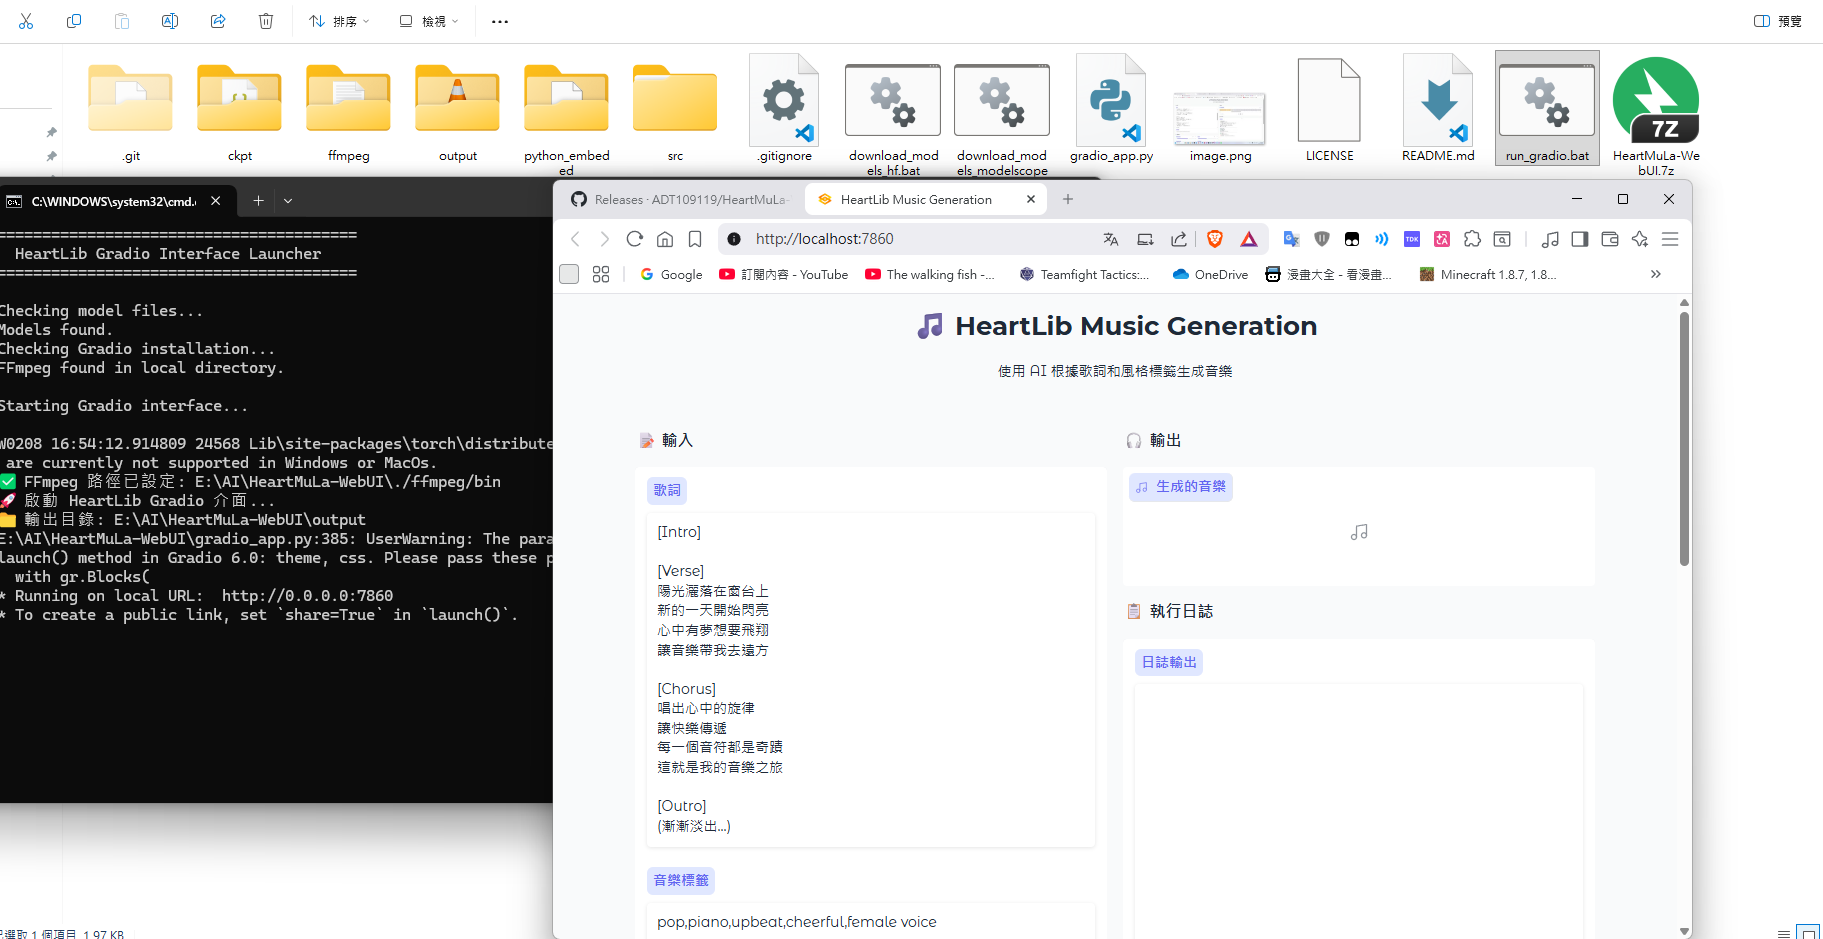
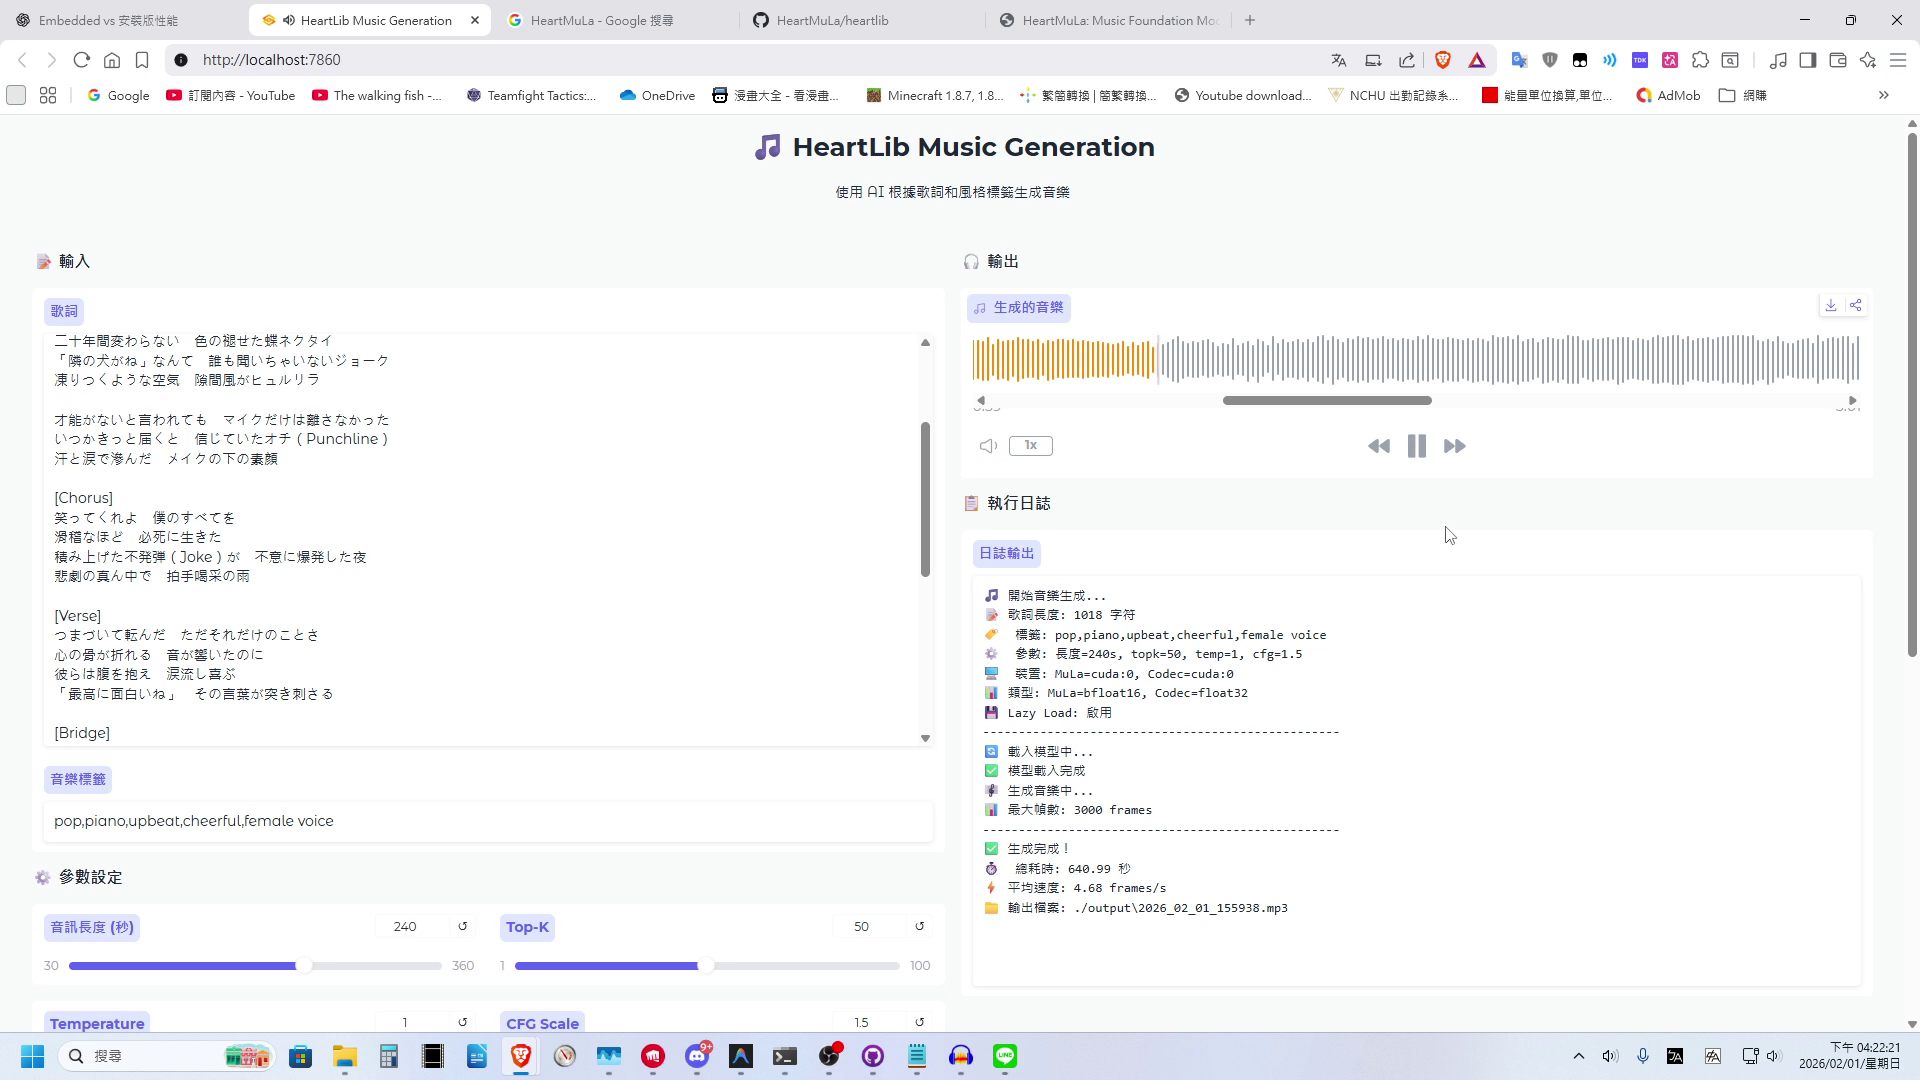
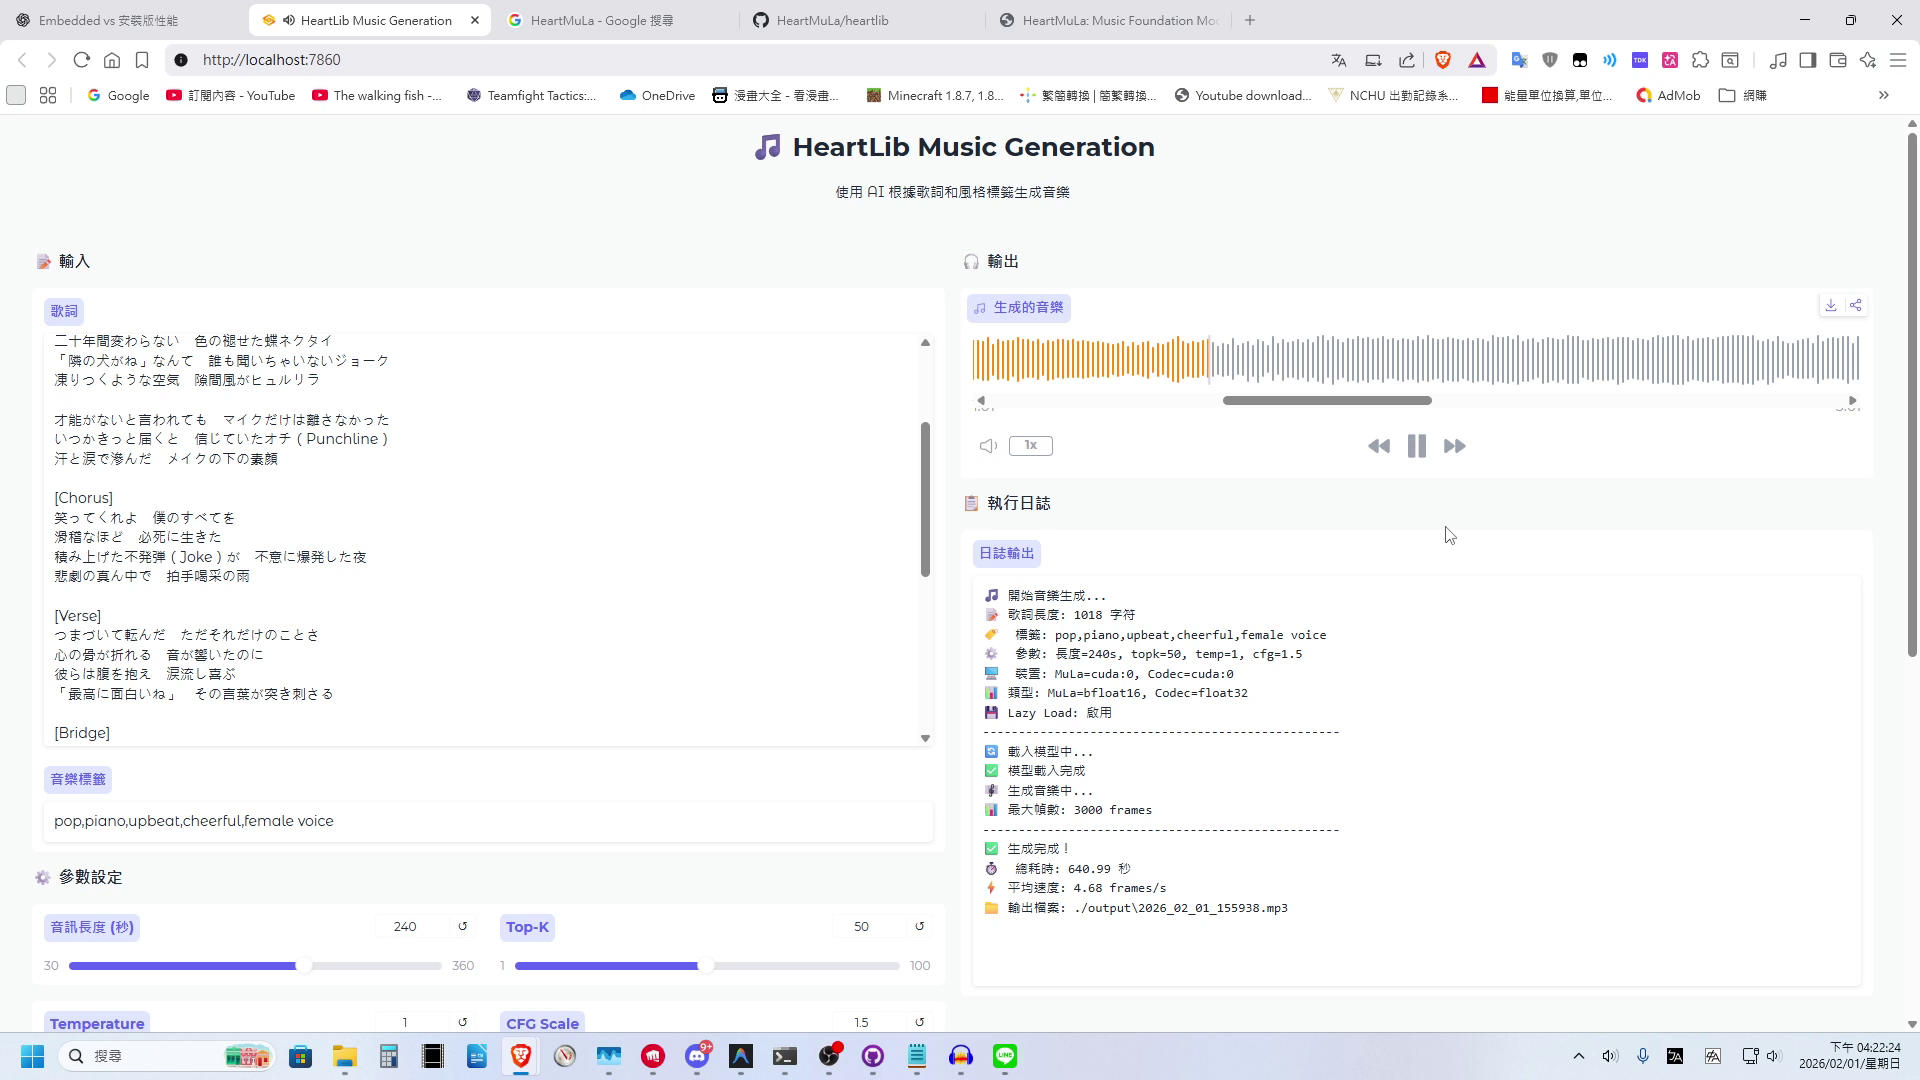
就是這麼簡單!瀏覽器會自動彈出 WebUI 操作介面。
操作指南與提示詞技巧
進入介面後,你會發現操作邏輯跟 Suno 有點像,主要分為歌詞區和風格標籤區。
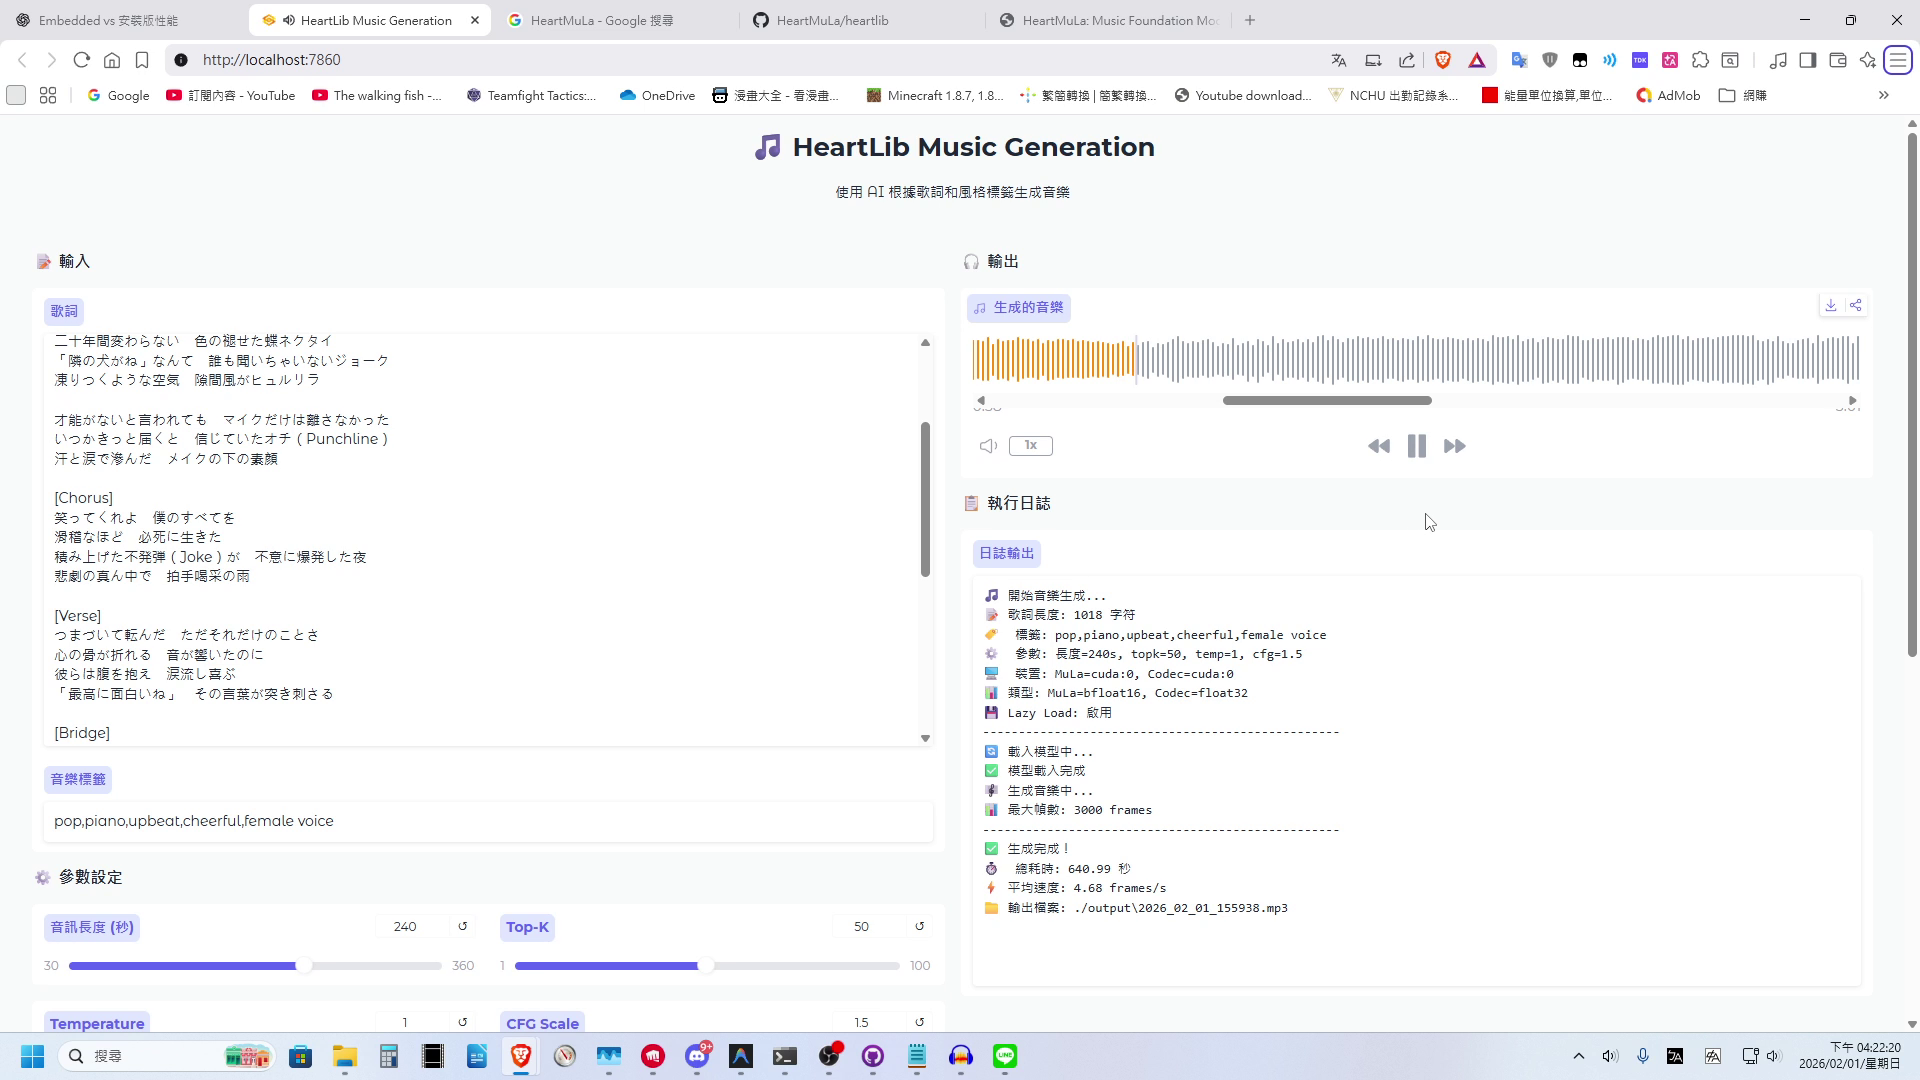
1. 歌詞結構 (Lyrics)
官方範例支援以下標籤來控制歌曲結構,記得用中括號 [] 包起來:
[Intro](前奏)[Verse](主歌)[Prechorus](導歌)[Chorus](副歌)[Bridge](橋段)[Outro](尾奏)
2. 風格標籤 (Tags)
這裡要注意,不要使用自然語言描述(例如:「一首悲傷的歌」)。建議使用單詞並以英文逗號分隔,像這樣:
J-pop, female vocals, energetic, piano
3. 進階控制
理想上,你可以在歌詞段落下方額外添加風格控制,例如:
|
|
不過我自己實測,這種額外提示很容易「漏氣」,被模型當作歌詞唱出來,所以效果見仁見智。
4. 參數設定
介面下方可以調整音訊長度、TopK、Temperature 等參數,如果想要生成快一點的話,也可以開啟 4-bit 量化,犧牲一點品質來換取速度。目前的模型版本是 3B,未來官方發布 7B 版本後,品質應該會更上一層樓。
生成歌詞的提示詞
這邊順便提供給大家,我寫好的歌詞生成提示詞範例,試試看使用他來在 ChatGPT 或 Gemini 上生成歌詞。
|
|
試聽與總結
這邊我就提供給大家我自己測試生成覺得生成的比較好的中文歌詞,讓大家聽聽看他的效果。
其他的詳細介紹與一些日文、英文片段的試聽,大家可以到 YouTube 影片上查看。
以上就是本篇全部的內容,我已經把編好的提示詞範例和懶人包連結都整理好了,歡迎大家下載來玩玩看,打造屬於自己的 AI 音樂工作站!